Gemini API の料金とは|入力トークンと出力トークンで決まる従量課金
Gemini API の料金は、月額固定のサブスクリプションではなく、やり取りしたトークン量に応じて課金される従量課金です。個人向けの Google AI Plus や Pro といったプランとは会計が分かれており、プランに加入していても API の利用料は別に発生します。
関連記事:Geminiの料金プランはいくら?無料・Plus・Pro・Ultraの違いと選び方
課金されるのは「文字数」ではなくトークン
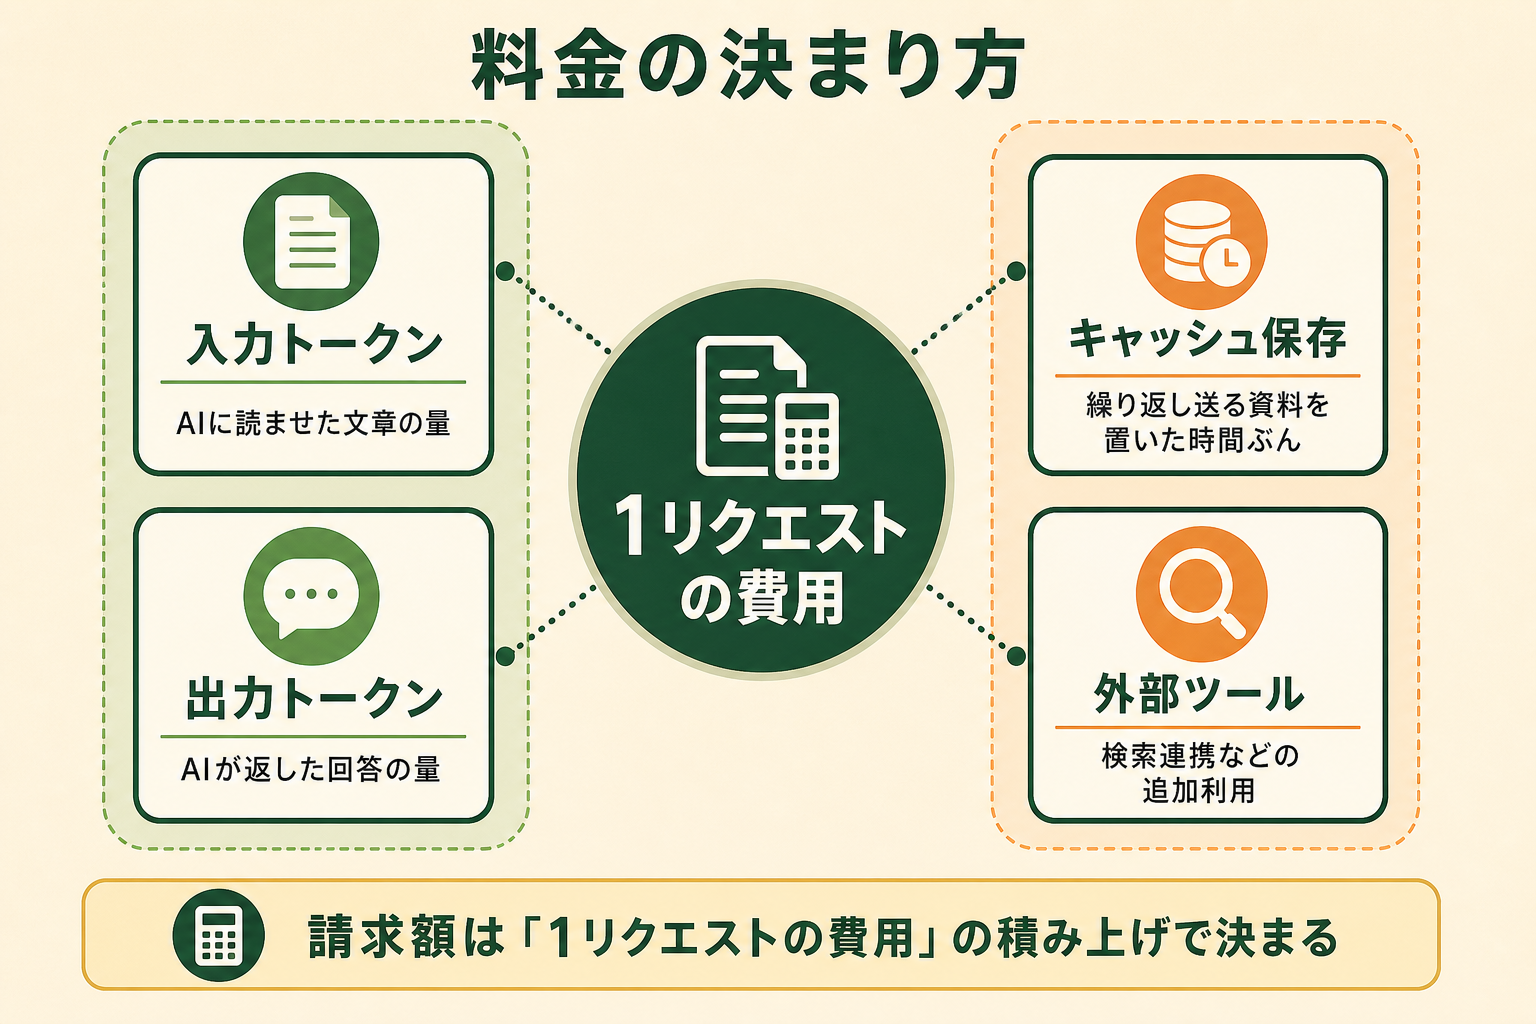
トークンとは、AI がテキストを処理するときの最小単位です。単価は「100万トークンあたり何ドル」という形で示され、AI に送った分が入力トークン、AI が返した分が出力トークンとして別々に数えられます。出力側の単価は入力側の5倍前後に設定されているモデルが多く、長い回答を返させるほど費用が伸びます。
日本語は英語に比べてトークン消費が多くなる傾向があり、おおむね1文字あたり1トークン前後を目安に見積もると大きく外しません。正確な消費量は API のレスポンスに含まれる利用トークン数で確認できるため、本番運用の前に実データで一度測っておくと見積もりの精度が上がります。
課金対象は入力と出力だけではない
費用が発生するのは入出力トークンだけではありません。同じ前提条件を繰り返し送る用途では、その部分をコンテキストキャッシュに保存しておくと入力単価が下がる一方、保存しているあいだはストレージ料金が時間単位で加算されます。Google 検索と連携させるグラウンディング機能も、規定の検索リクエスト数を超えると別途課金されます。
つまり見積もりで押さえるべき項目は、入力トークン、出力トークン、キャッシュの保存料、外部ツールの利用料の4つです(2026年9月時点、出典: ai.google.dev)。
Gemini API の課金の仕組み|標準・バッチ・Flex・優先度の4つの処理モード
Gemini API では、同じモデルでもリクエストの出し方によって単価が変わります。Google の料金ページでは、モデルごとに標準・バッチ・Flex・優先度の4つのタブで単価が示されています。Gemini 3.7 Flash を例に、100万トークンあたりの単価を並べると次のようになります。
| 処理モード | 入力単価 | 出力単価 | 向いている用途 |
|---|---|---|---|
| 標準 | $0.75 | $3.75 | 対話型の機能など、応答を待たせたくない処理 |
| バッチ | $0.375 | $1.875 | 締め切りのない一括処理。標準の半額 |
| Flex | $0.375 | $1.875 | 遅延を許容できる処理。標準の半額 |
| 優先度 | $1.35 | $6.75 | 混雑時も優先的に処理させたい場合。標準の1.8倍 |
いずれも2026年12月31日までの単価で、2027年1月1日からは同モデルの標準単価が入力$1.50・出力$7.50に改定されます(2026年9月時点、出典: ai.google.dev)。年間予算を組むときは、改定後の単価でも成立するかを合わせて確認しておくと安全です。
4つのモードのうち、費用面で効くのはバッチです。夜間にまとめて処理できる分類・要約・タグ付けのような用途を標準からバッチに移すだけで、同じモデル・同じトークン量でも支払いは半分になります。優先度モードは逆に単価が上がるため、応答速度が売上に直結する処理に限って使う判断になります。
Gemini API のモデル別料金一覧|主要モデルの単価と価格差
モデルによって単価は10倍以上開きます。テキスト処理でよく使われるモデルの標準単価(100万トークンあたり・米ドル)は次のとおりです(2026年9月時点、出典: ai.google.dev)。
| モデル | 入力単価 | 出力単価 | 無料枠 |
|---|---|---|---|
| Gemini 3.7 Flash | $0.75 | $3.75 | あり |
| Gemini 3.5 Flash | $1.50 | $9.00 | あり |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | あり |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | あり |
| Gemini 3.1 Pro(20万トークン以下) | $2.00 | $12.00 | なし |
| Gemini 2.5 Flash | $0.30 | $2.50 | あり |
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | あり |
Pro 系は長い文脈をまたいだ推論に強い一方、Flash-Lite との差は入力で8倍、出力で8倍前後になります。Gemini 3.1 Pro はプロンプトが20万トークンを超えると単価がさらに倍になるため、長文を丸ごと渡す設計では費用が跳ねます。
分類・抽出・定型の要約のように判断の幅が狭い処理は Flash-Lite、要件の読み取りや複数資料の突き合わせが要る処理は Pro、と用途で使い分けるのが費用対効果の面では素直です。
関連記事:Gemini 3.7 Flashとは?3.6 Flashとの違いと料金
Gemini API の無料枠で使える範囲と、有料に切り替わる条件
Gemini API には無料枠があり、請求先アカウントを登録しなくても一部のモデルを無料で試せます。上の一覧で「無料枠あり」としたモデルが対象です。ただし無料枠には、有料枠と決定的に違う条件が2つあります。
無料枠と有料枠の違い
1つ目はデータの扱いです。無料枠で送受信した内容は Google のサービス改善に利用されますが、有料枠では利用されません。社内文書や顧客情報を扱う検証を無料枠で回すのは避けてください。
2つ目はレート上限です。上限は1分あたりのリクエスト数、1分あたりの入力トークン数、1日あたりのリクエスト数の3つで測られ、いずれか1つでも超えるとエラーが返ります。適用単位は API キーではなくプロジェクトで、1日の上限は毎日リセットされます。
なお具体的な上限値は公式の料金ページに掲載されておらず、Google AI Studio で自分のプロジェクトの有効な値を確認する方式に変わっています(2026年9月時点、出典: ai.google.dev)。他の記事にある固定値を前提にせず、実際の画面で確かめてください。
有料に切り替わるのは自分で操作したときだけ
無料枠のまま使っている限り、勝手に課金が始まることはありません。有料枠へ移るには、Google AI Studio で請求先アカウントをリンクし、所定額のクレジットを購入する操作が要ります。この操作をしなければ、上限に達した時点でエラーが返るだけで請求は発生しません。
有料枠に移ると利用実績に応じてティアが上がり、レート上限と請求上限が段階的に引き上げられます。
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
ケース別に見る Gemini API の月額シミュレーション
費用が読めない原因の多くは、単価そのものではなく「自社のどの業務が何トークン使うのか」を見積もれていないことにあります。まず任せる業務を1つ決め、1リクエストあたりの入力・出力トークンと月間の件数を置くと、月額はその場で計算できます。GiftX のAIエージェント構築支援でも、対象業務を1つに絞ってモデルと処理モードを決めるところから設計しています。
ここでは代表的な3つのケースで試算します。いずれも Gemini 3.7 Flash と Flash-Lite の標準単価(2026年9月時点、出典: ai.google.dev)を用い、1ドル150円で換算しています。
試算に必要な数字は2つだけ
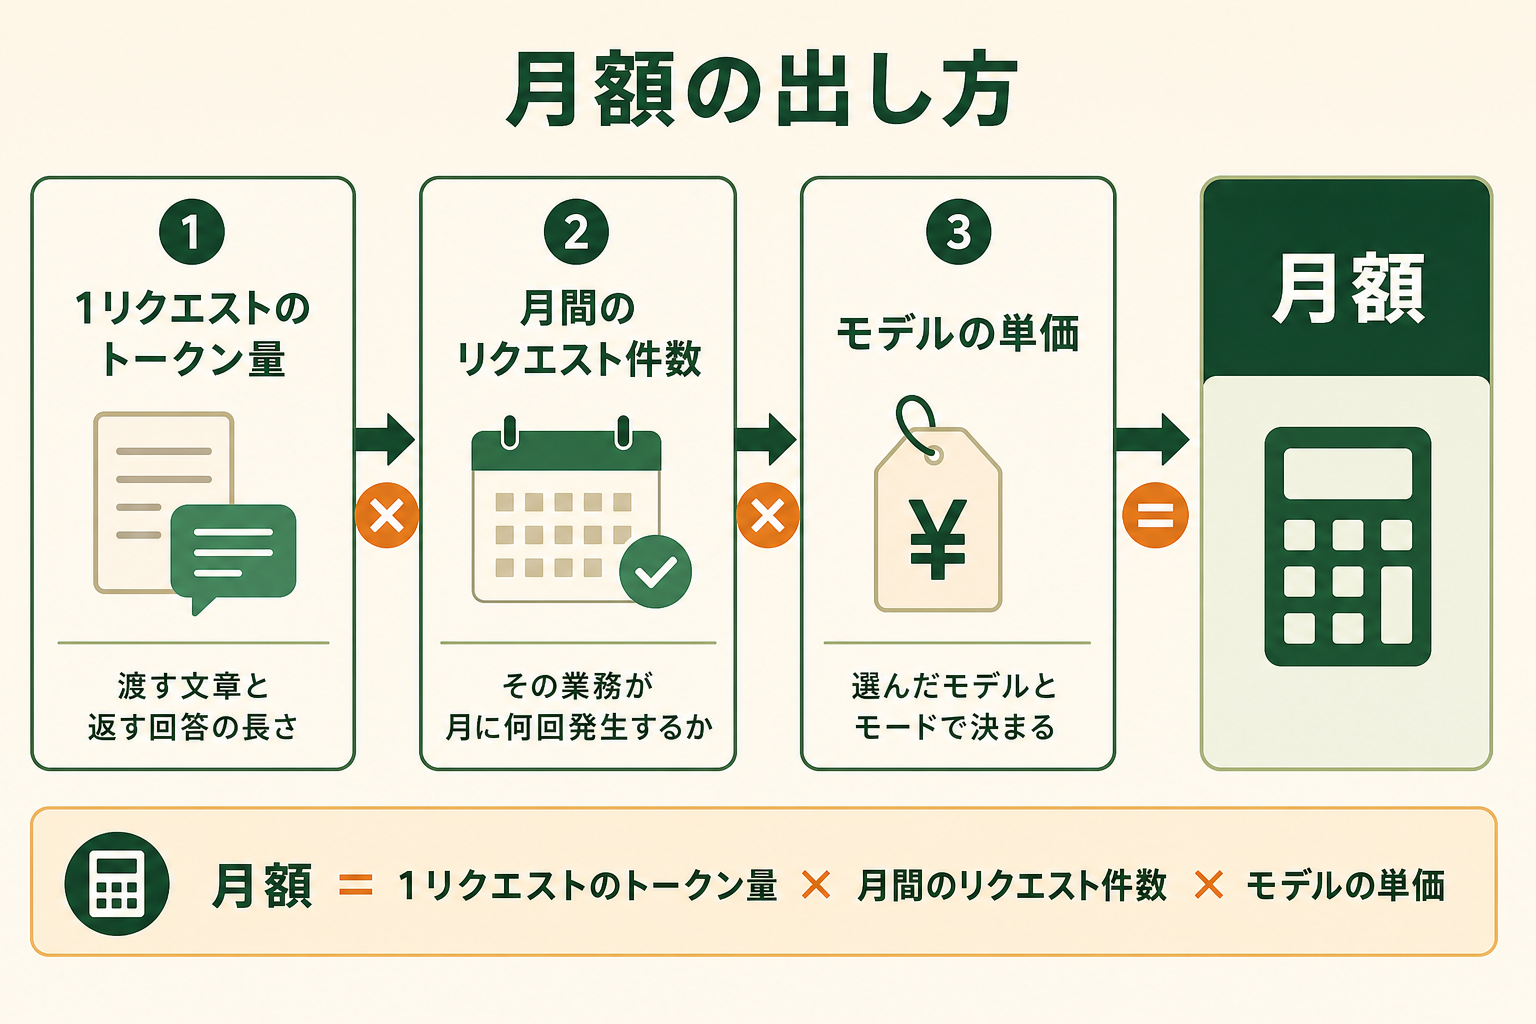
月額を出すのに要る情報は多くありません。次の2つを置けば計算できます。
- 1リクエストあたりのトークン量:AI に渡す文章の文字数がそのまま入力トークンの目安になり、返させたい回答の長さが出力トークンになります
- 月間のリクエスト件数:対象業務が月に何回発生するかを、現状の処理件数から置きます
たとえば A4 用紙1枚分の文章はおおむね1,500〜2,000トークンです。マニュアル10ページ分を毎回渡す設計なら、それだけで1リクエスト2万トークン前後になります。入力トークンは「毎回どれだけの文章を読ませるか」で決まるため、渡す資料の量を見直すことが最も直接的な費用対策になります。
ケース1|社内の問い合わせ対応ボット
社内規程やマニュアルを参照して回答するボットを想定します。1件あたり入力2万トークン・出力500トークン、月1万件の利用とします。
Gemini 3.1 Pro を使うと入力が2億トークンで$400、出力が500万トークンで$60、合わせて月およそ$460(約6万9,000円)になります。同じ条件を Gemini 3.7 Flash に置き換えると、入力$150・出力$18.75で月およそ$169(約2万5,000円)まで下がります。回答の難易度がそれほど高くない社内問い合わせであれば、Flash 系で十分に成立するケースが多い領域です。
この規模でも、検証段階なら無料枠で足ります。まず社内向けに1日数十件だけ流して回答精度とトークン消費を測り、実データで月額を出し直してから有料枠に移る進め方が、見積もりの精度としても費用としても無駄がありません。
ケース2|会議の議事録要約
1時間の会議の文字起こしを要約する用途です。1本あたり入力2万トークン・出力2,000トークン、月200本とします。
Gemini 3.5 Flash-Lite なら入力400万トークンで$1.2、出力40万トークンで$1.0、合計で月$2.2(約330円)です。定型的な要約や整形はトークン単価の低いモデルで足りるため、この規模の用途で費用が問題になることはまず起きません。むしろ注意すべきは、文字起こし側のサービス利用料が別にかかる点です。
一方で、議事録から意思決定の論点を抽出したり、過去の議事録と突き合わせて進捗を判断させたりする使い方に広げると、必要な推論の深さが変わります。要約の精度に不満が出た段階で Flash 系や Pro 系に上げても、この件数なら月額は数千円の範囲に収まります。
ケース3|大量の問い合わせテキストを分類する
蓄積した問い合わせ10万件をカテゴリ分けする一括処理です。1件あたり入力1,000トークン・出力50トークンとします。
Gemini 3.5 Flash-Lite の標準単価では入力1億トークンで$30、出力500万トークンで$12.5、合計$42.5(約6,400円)です。締め切りのない処理なのでバッチに回せば単価は半分になり、月$21前後まで落ちます。一括処理の用途で標準モードを使い続けているなら、ここが最も手早く効く削減余地です。
なおバッチ処理は、同時に実行できるジョブ数やキューに入れられるトークン数に別途上限があります。10万件を一度に投げるのではなく、日次で分割して流す設計にしておくと上限に当たりにくく、処理の失敗時にも戻しやすくなります。
Before/After|モデル選択とキャッシュで月額はどこまで変わるか
ケース1の問い合わせボットで、設計を見直した差を整理します。最上位の Pro モデルのまま、問い合わせのたびにマニュアル全文を貼り付けていた状態では、月およそ$460(約6万9,000円)でした。
マニュアル部分をコンテキストキャッシュに載せ、回答生成を Gemini 3.7 Flash に切り替えます。キャッシュ済み入力の単価は標準入力の10分の1にあたる$0.075です(2026年9月時点、出典: ai.google.dev)。入力2万トークンのうち1万8,000トークンをキャッシュに寄せると、入力$28.5・出力$18.75・ストレージ料$6.5前後になります。
合計で月およそ$54(約8,100円)となり、同じ件数・同じ内容のまま8割強の削減です。料金を下げる打ち手は、使う量を減らすより先に、モデル・処理モード・キャッシュを業務に合わせ直すことだと分かります。
見直す順番にも効き方の差があります。
- モデルの変更:この例では$460から$169へと6割強が落ち、最初に効きます
- キャッシュの利用:繰り返し送る資料が大きいほど差が開きます
- 処理モードの変更:応答を待たせてよい処理かどうかで選べる範囲が決まります
対話型の機能で費用を下げたい場合は、処理モードを標準から動かせないことが多いため、モデルとキャッシュの2点だけで効果を出す設計になります。
Gemini API を使い始める手順と、想定外の請求を防ぐ設定
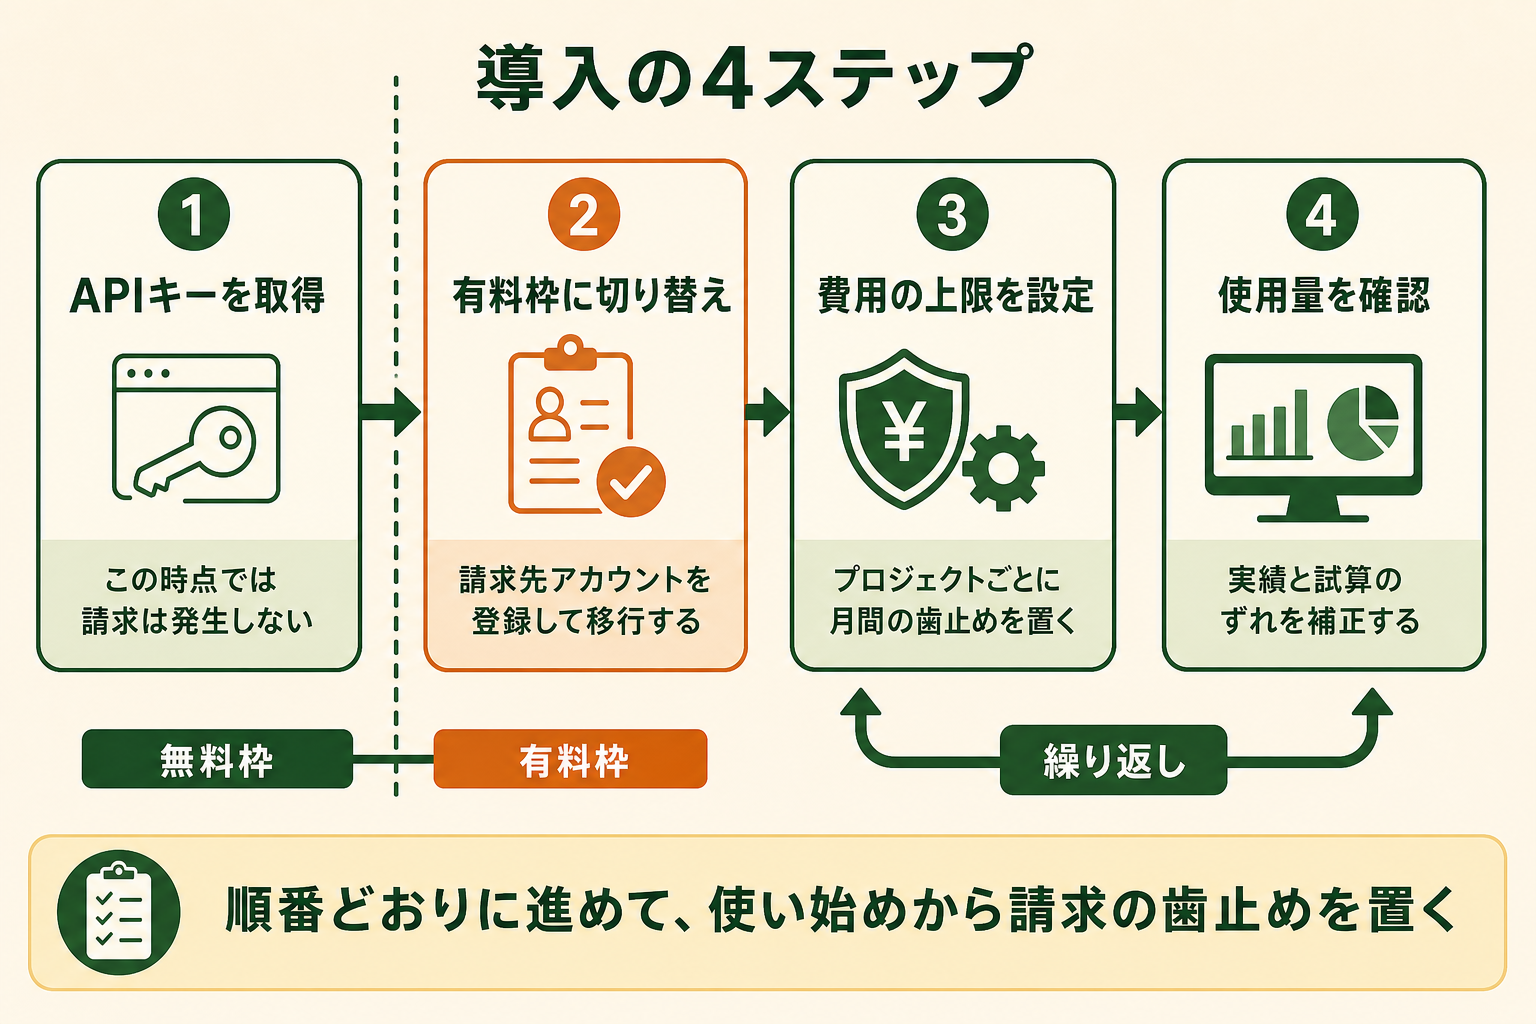
費用の見通しが立ったら、実際に使い始める手順に移ります。ここまでの試算をそのまま運用に乗せるには、キーの取得と課金設定に加えて、上限の設計をセットで行うのが安全です。
APIキーを取得する
Google AI Studio にアクセスして API キーを発行します。新規ユーザーには既定でプロジェクトと API キーが作成されるため、追加のキーが必要な場合のみ作成操作を行います。この時点では無料枠のままで、請求は発生しません。
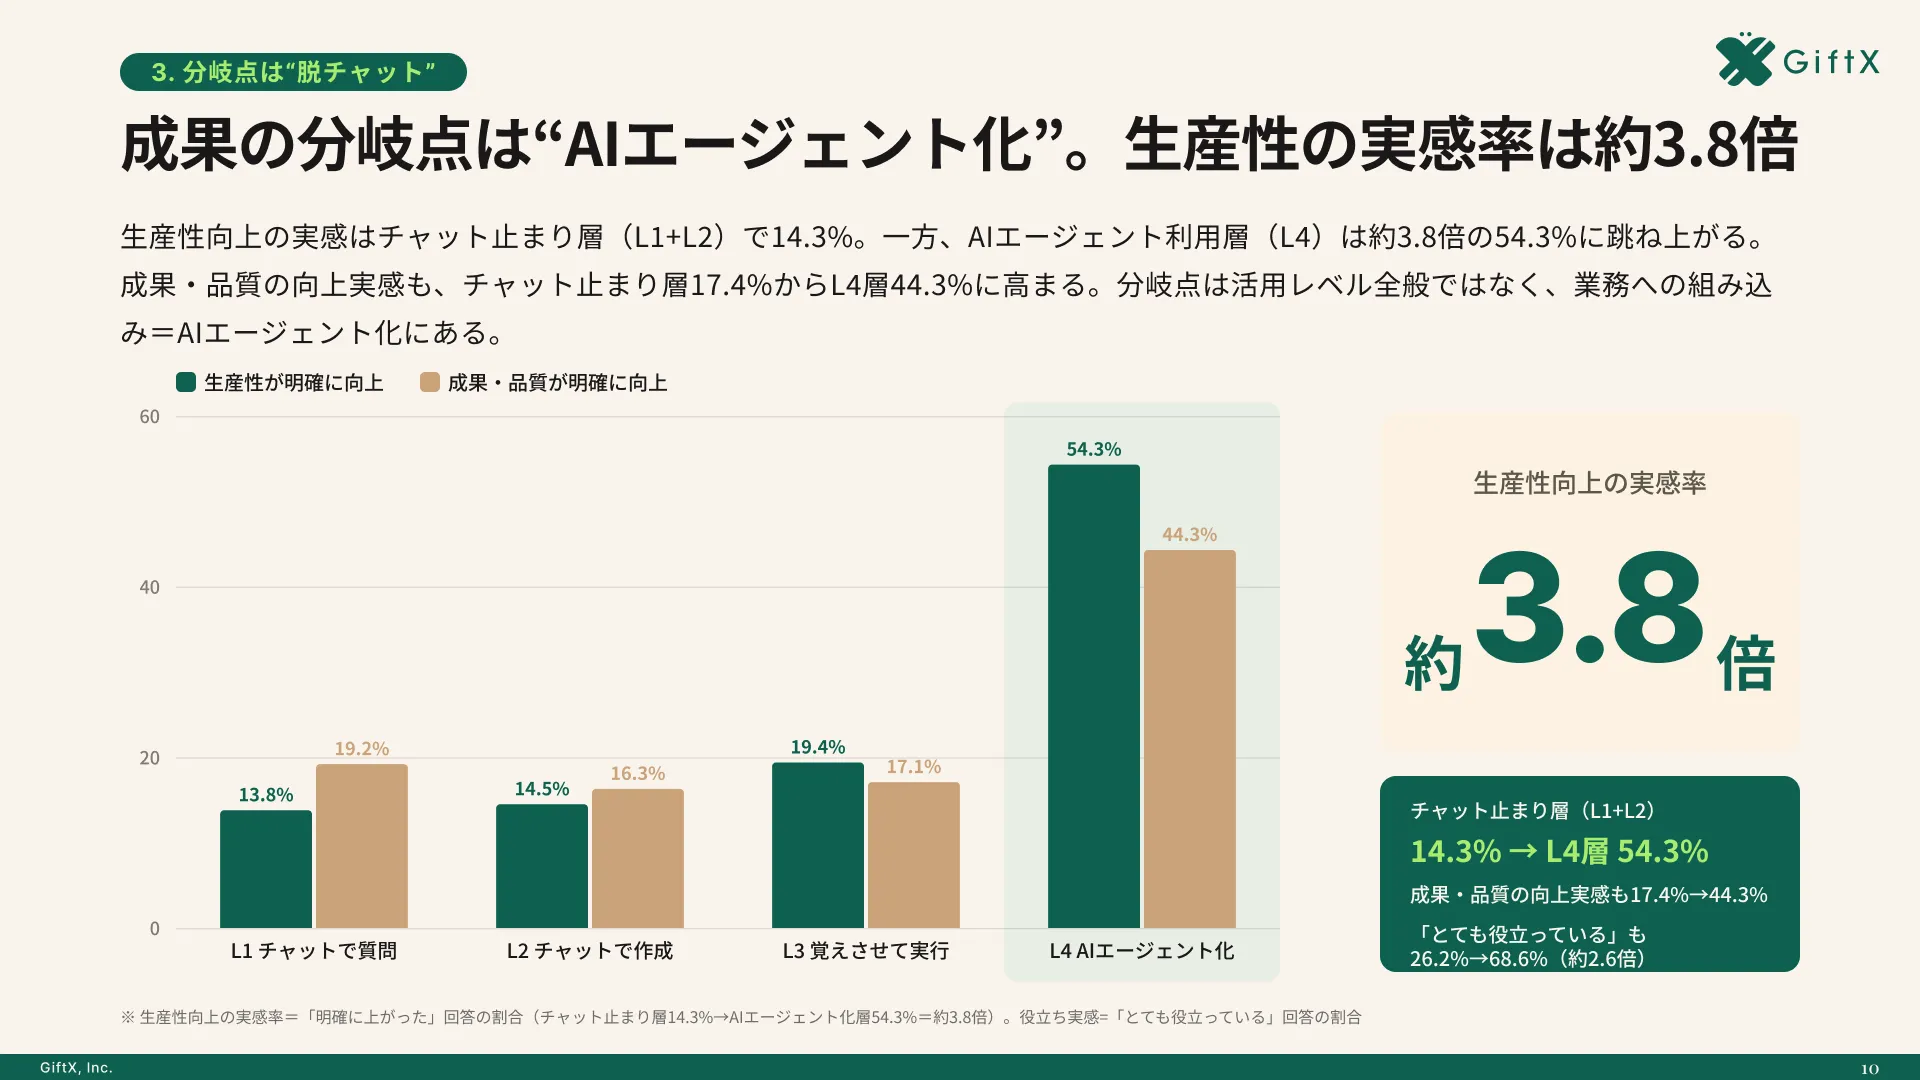
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
有料枠に切り替える
レート上限を上げたい、コンテキストキャッシュやバッチ処理を使いたい、送信内容をサービス改善に使われたくない、のいずれかに当てはまる場合は有料枠へ移ります。Google AI Studio のプロジェクトページから請求先アカウントをリンクし、最低5ドルのクレジットを購入すると切り替わります(2026年9月時点、出典: ai.google.dev)。
支払い方式には前払いと後払いがあり、2026年3月23日から区分が有効になっています。前払いの場合、購入したクレジットは12か月で期限切れとなり払い戻しはできません。また残高がゼロになると、その請求先アカウントにひもづく全ての API キーが同時に止まる点も押さえておく必要があります。
費用の上限を設定する
Gemini API では、請求先アカウントのティアごとの上限とは別に、プロジェクト単位で月間の費用上限を設定できます。同じ請求先で複数のプロジェクトを動かす場合に有効です。設定は Google AI Studio の費用ページから行います。
ただしこの機能は試験運用版で、課金データの反映に10分程度の遅れがあります。バッチ処理やエージェントのような長時間実行されるタスクでは、上限に達したことをシステムが検知する前に超過が発生しうる仕様です(2026年9月時点、出典: ai.google.dev)。上限は「必ず止まる壁」ではなく「おおよその歯止め」と捉え、余裕を持った値を設定してください。
オートチャージを使う場合は、あわせて1か月あたりの自動チャージ上限を設定します。残高が減るたびに無制限にチャージされる状態を避けられます。
使用量を確認する
運用開始後は Google AI Studio のダッシュボードにある使用量画面で消費を確認します。最初の1〜2週間は週次で実績を見て、試算とのずれを補正しておくと、その後の予算が立てやすくなります。どの業務から任せるかの判断材料は「職種別AI活用事例集」にまとめています。
ChatGPT・Claude の API と Gemini API の料金比較
他社 API と比べる場合は、モデルのクラスをそろえて見る必要があります。各社の代表的なモデルの単価(100万トークンあたり・米ドル)は次のとおりです。
| API | モデル | 入力単価 | 出力単価 |
|---|---|---|---|
| Gemini API | Gemini 3.7 Flash | $0.75 | $3.75 |
| Claude API | Claude Haiku 4.5 | $1.00 | $5.00 |
| OpenAI API | GPT-5.6 Sol | $5.00 | $30.00 |
Gemini 3.7 Flash と Claude Haiku 4.5 は軽量クラスの位置づけで、単価も近い水準にあります。GPT-5.6 Sol は上位クラスのモデルなので、この表だけで OpenAI API が割高と判断することはできません(Claude は2026年9月時点、出典: anthropic.com / OpenAI は2026年5月時点、出典: openai.com)。
また3社とも、バッチ処理で約50%、キャッシュ利用で最大90%の削減という同種の仕組みを持っています。単価表の数字だけで比較するのではなく、自社の処理がバッチに回せるか、同じ前提条件を繰り返し送る形かまで含めて比べると、実際の支払額に近い判断ができます。
関連記事:Geminiとは?できること・料金プラン・モデル体系とChatGPTとの違い
Gemini API を業務に組み込むときに陥りがちな3つの落とし穴
料金の構造を理解しても、実際に業務へ組み込む段階でつまずくパターンはある程度決まっています。
落とし穴1|いきなり全ての業務を API に載せ替えようとする
対象業務を絞らないまま検討を始めると、必要なモデルも想定トークン量も決まらず、見積もり自体が作れません。1つの業務に絞れば、1リクエストのトークン量と月間件数という2つの数字だけで月額が出せます。
落とし穴2|全社の AI 戦略から考え始めて最初の1リクエストを投げない
体制や規程の整備を先に片付けようとすると、検証に入るまでに数か月かかります。無料枠であれば請求は発生しないので、まず動かして実データのトークン消費を測るほうが、精度の高い計画につながります。
落とし穴3|既製のチャット型AIツールのまま業務フローに組み込めずにいる
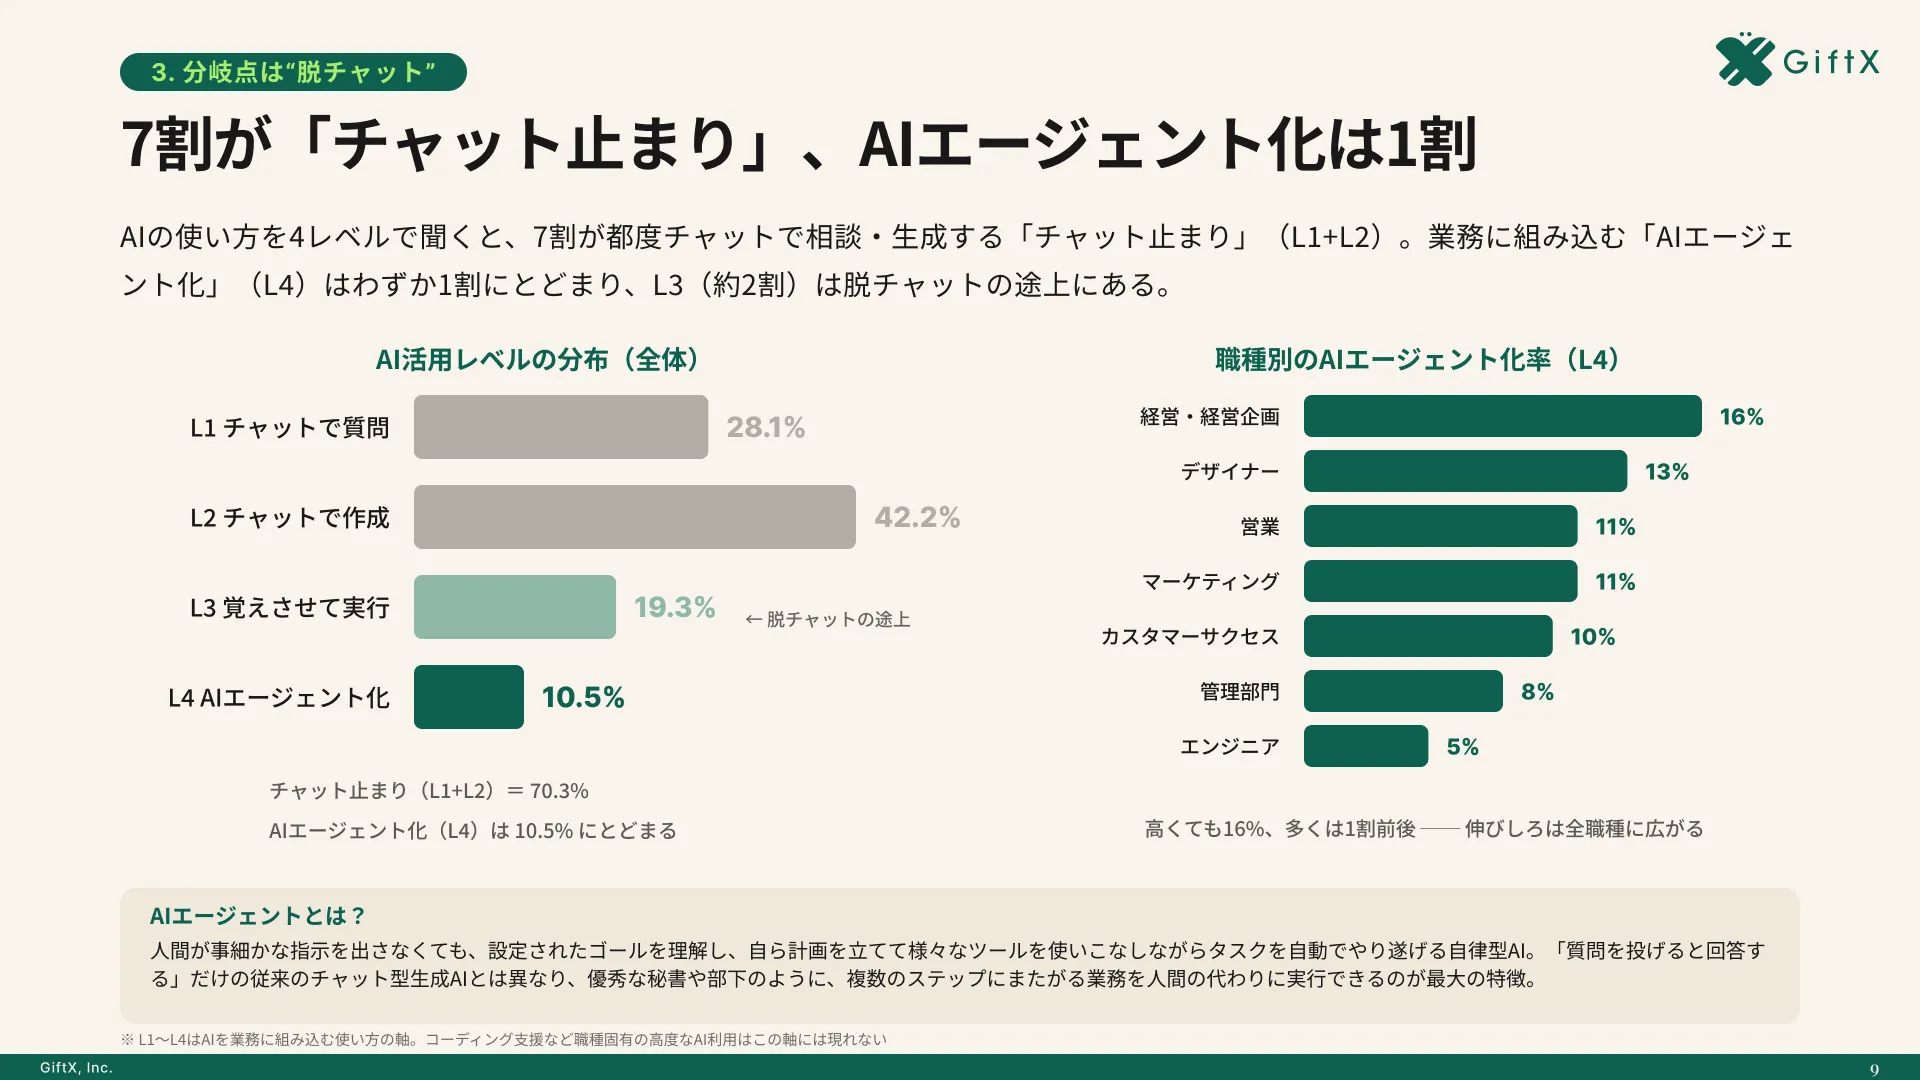
自社の調査でも、AI活用がチャットでのやり取りにとどまっている人が70.3%を占め、AIエージェントが複数工程を自動で進める段階まで来ている人は10.5%でした。チャット画面での利用は手軽な一方、自社の手順を覚えさせて同じ品質で繰り返す使い方には向きません。API に移すのはこの壁を越えるための手段であり、費用はその対価として設計する対象になります。
詳細な調査データは「ビジネス職生成AI活用実態調査(2026年版)」にてご覧ください。
スモールスタートで1業務を AI エージェントに任せる
3つに共通するのは、対象を絞らないまま費用や体制を考えようとしている点です。まず1業務を決め、無料枠で実際のトークン消費を測り、モデルと処理モードを選び直す。この順番で進めれば、費用は見積もれる対象になります。GiftX では、こうしたスモールスタート前提の AI エージェント構築を1業務単位から伴走支援しています。詳細は AIエージェント構築支援サービス をご覧ください。
まとめ
Gemini API の料金は、入力トークン、出力トークン、キャッシュの保存料、外部ツールの利用料という4項目の従量課金で決まります。同じモデルでも標準・バッチ・Flex・優先度で単価が変わり、締め切りのない処理をバッチに移すだけで支払いは半分になります。
無料枠は請求先アカウントを登録しない限り課金に切り替わらないため、まずは無料枠で実データのトークン消費を測るのが遠回りに見えて確実です。そのうえでモデルと処理モードを選び、プロジェクト単位の費用上限とオートチャージ上限を設定しておけば、想定外の請求はおおむね防げます。
費用を下げる打ち手は使用量を我慢することではなく、1業務ずつ対象を決めて設計を合わせ直すことにあります。
AI活用の伴走支援をご検討の方へ
本記事で紹介した AI エージェントの活用に向けて、自社の業務でも具体的に進めたい・相談したいとお考えの方は、ぜひ GiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせて1業務単位のスモールスタートから本番運用まで、AIエージェント構築をワンストップで支援します。ユースケースの洗い出しから、PoC、本番運用、社内ナレッジ化まで伴走します。
AI活用にご関心のある方は、ぜひ一度ご相談ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら