Muse Sparkとは?Meta AIとの違いと利用する入口
Muse Spark は、Meta が開発するマルチモーダル対応の推論モデルです。
マルチモーダルとは、文章に加えて画像や動画など、複数の形式の情報を扱うことです。推論モデルは、問いに対して途中の検討を重ねながら回答を生成するモデルを指します。Muse Spark はこうした処理を担う基盤で、利用画面や業務の実行手順は別の製品・プログラムが用意します。
関連記事:Meta Museとは?できること・料金・日本での利用可否と安全性を解説
Muse Sparkはモデル、Meta AIはアシスタント
Muse Spark とMeta AIは、AIの回答を利用するという点で関係があります。下表では、役割、操作方法、組み込み時の位置づけを分けて整理しました。自分で質問を入力したいのか、システムから自動で呼び出したいのかを基準に読むと、必要な入口を選べます。
| 観点 | Muse Spark | Meta AI |
|---|---|---|
| 役割 | 内容を読み取り、推論して回答するモデル | 利用者が対話するアシスタント |
| 利用する入口 | Meta Model APIや対応製品 | Meta AIアプリやWebの対話画面 |
| 利用者が用意するもの | APIで組み込む場合はプログラムや処理手順 | 対応する利用環境と質問・素材 |
| 機能を確認する単位 | モデルのバージョン、入出力、API仕様 | アシスタントの画面、モード、提供条件 |
例えば、アプリ上で資料を読ませて質問する場合は、Meta AIの機能を確認します。同じ処理を社内の仕組みから定期的に実行する場合は、モデルを呼ぶAPIと、その前後で資料を渡すプログラムを設計することになります。
Meta は2026年7月の公式発表で、Muse Spark 1.1をMeta AIのThinkingモードへ提供すると説明しています。ただし、アプリの全機能がモデル単体の機能であることや、アプリとAPIで常に同じバージョンを使うことまでは意味しません。
Meta Model APIとMuse Codeの役割
API(Application Programming Interface、ソフトウェア同士が機能を呼び出すための接点)は、Muse Spark を自分のアプリから使う入口です。Meta が提供するMeta Model APIを通じて文章などを送り、生成された回答を受け取ります。対話画面でコピーする作業を、プログラムの処理へ組み込めます。
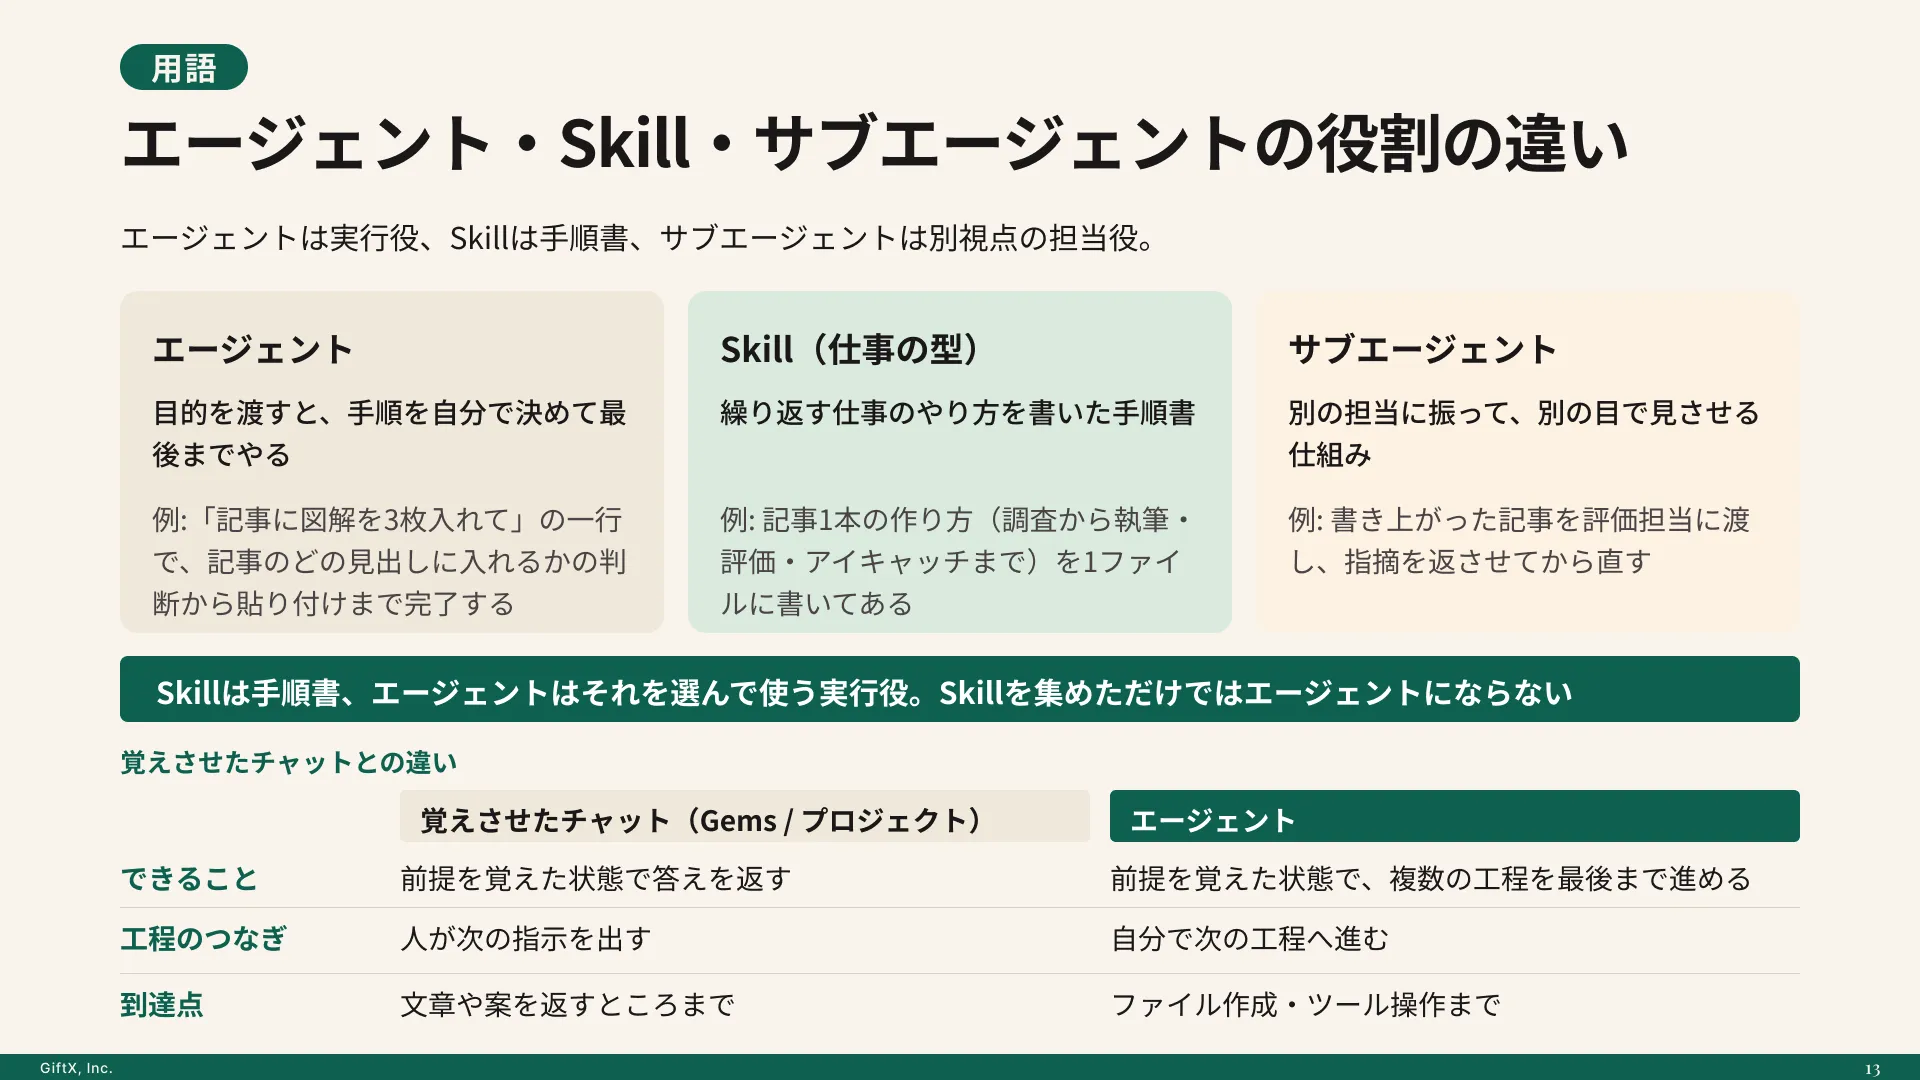
Muse Code は、ターミナルで使う完成済みのコーディングエージェントです。AIエージェントとは、目的に応じて道具を使い、複数の処理を進める仕組みを指します。Muse Code では、Muse Spark を基盤に、コードの調査・編集・コマンド実行などを進めます。モデルへの一問一答と、実際にファイルを書き換える作業は区別して考えます。
2026年9月の確認対象はMuse Spark 1.3
2026年9月15日時点のモデル一覧では、Muse Spark 1.3が新しい作業向けの推奨モデルとして掲載されています。Meta Model APIとMuse Codeで利用でき、APIでは muse-spark-1.3 というモデルIDを指定します。
同じ一覧には1.2や1.1も残っています。記事やサンプルを参考にするときは、単に「Muse Spark対応」と読むだけでなく、どのモデルIDを使っているかまで確認します。特に入力形式や推論設定は、バージョンや利用枠により条件が異なります。
Muse Sparkの仕組みとできること
Muse Spark は、渡された情報を読み取り、回答やコードをテキストで生成します。外部の道具と接続すると、情報取得や処理の結果を受けて、次の回答へ反映できます。
画像・動画・資料を読み取って文章で答える
公式モデル一覧では、Muse Spark 1.3の入力としてテキスト、画像、動画、PDFが案内されています。PDF(Portable Document Format、文書のレイアウトを保って共有する形式)を含め、複数の素材を扱えることが特徴です。例えば、図表を含む資料から確認項目を抜き出す用途を検討できます。
一方、モデルの出力はテキストです。画像を読み取れることと、画像ファイルを生成できることは同じではありません。Meta Model APIの画像生成には別のMuse Imageが用意されているため、画像制作まで行う場合は利用するモデルとAPIを分けます。
音声もバージョンの確認が必要です。Muse Spark 1.3では音声入力が十分にサポートされず、品質が低下する可能性があると公式資料に記載されています。音声処理では1.2や音声認識用モデルなど、公式が案内する選択肢を確認します。
長い資料を渡せるコンテキスト
コンテキストとは、回答を作る際にモデルが参照する情報の範囲です。前掲の公式モデル一覧では、Muse Spark 1.3のコンテキスト長は1,048,576トークンと案内されています。トークンは文章などをモデルが処理する単位であり、日本語の文字数と一対一には対応しません。
長い資料をまとめて扱える余地があっても、資料を無制限に詰め込む設計には向きません。必要な箇所を指定し、求める出力形式と照合方法を決めたほうが、回答を確認しやすくなります。処理する入力が増えれば、料金や応答時間にも影響します。
例えば、手順書から作業条件を整理する場合は、「対象の章」「抽出する項目」「記載がない場合の扱い」を先に決めます。回答に根拠箇所を添えるよう依頼し、元の資料と照合できる形で受け取ると、読み違いを見つけやすくなります。
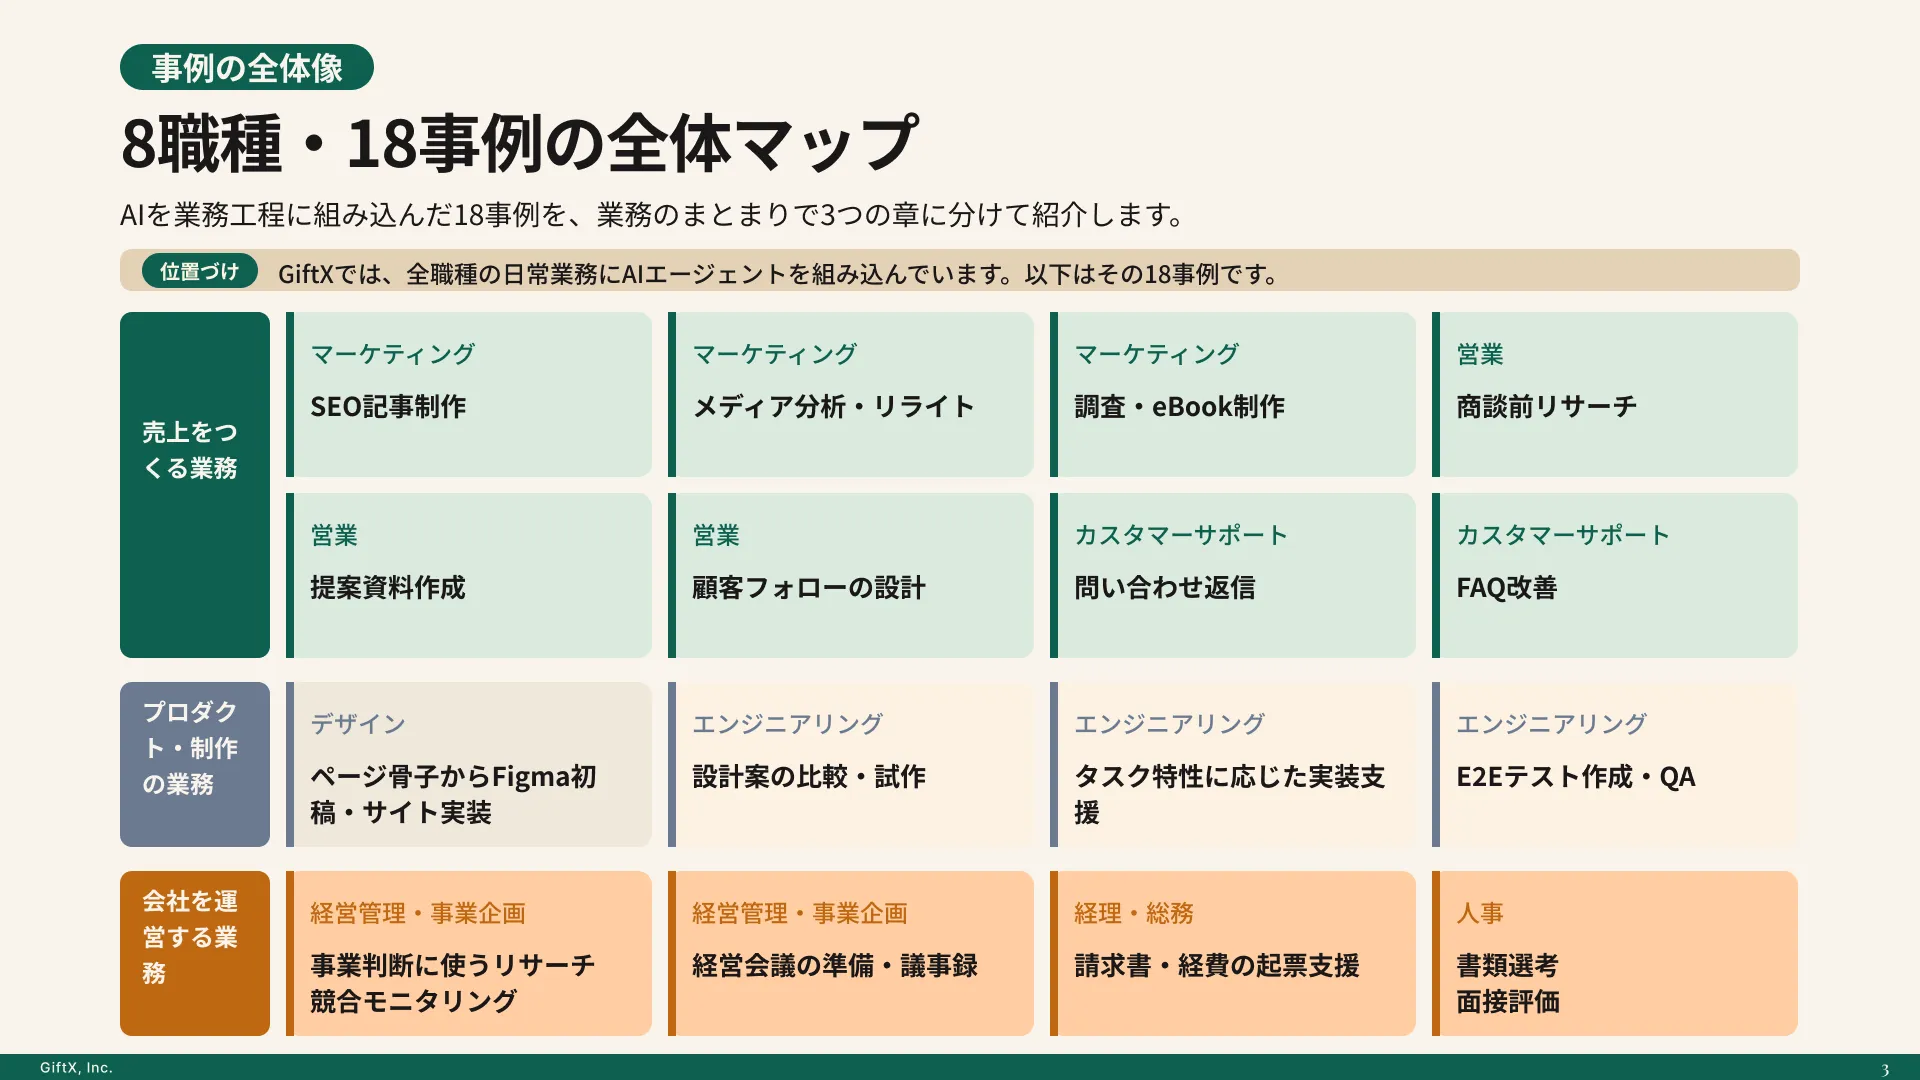
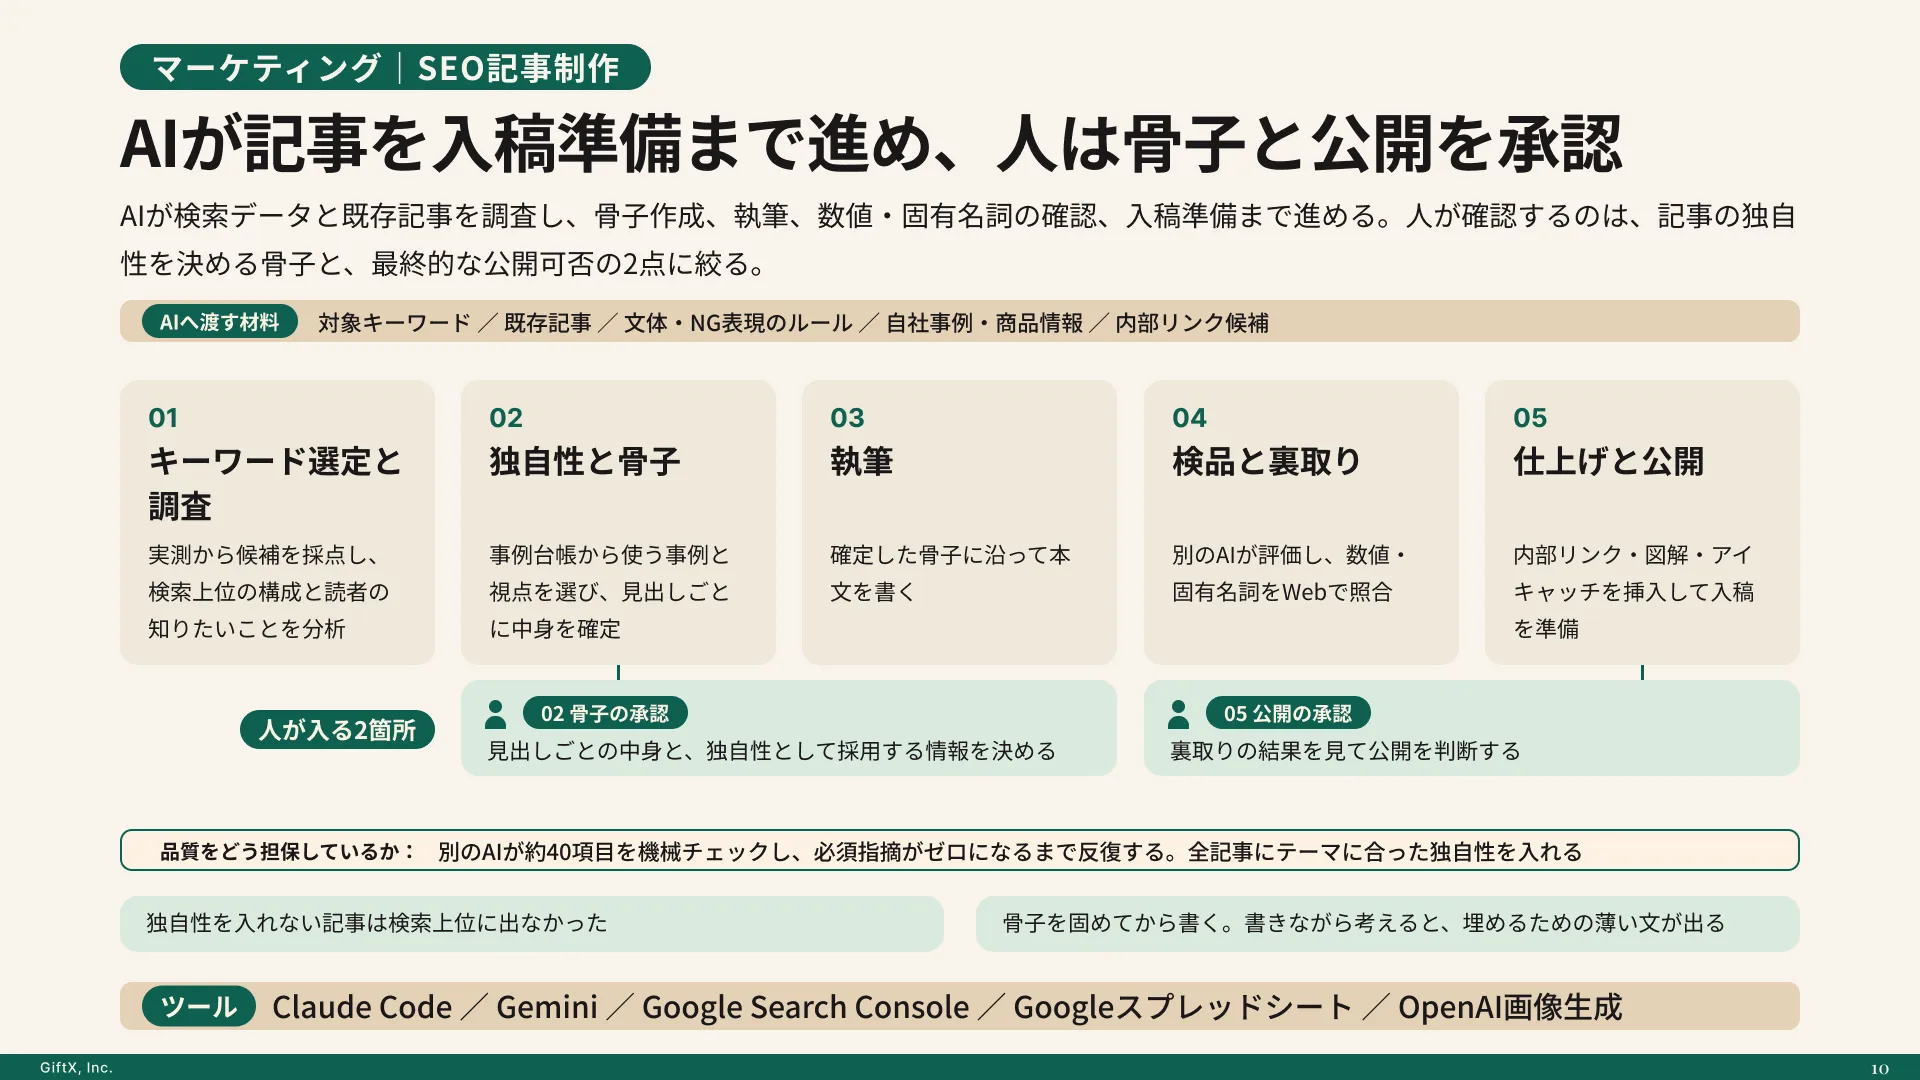
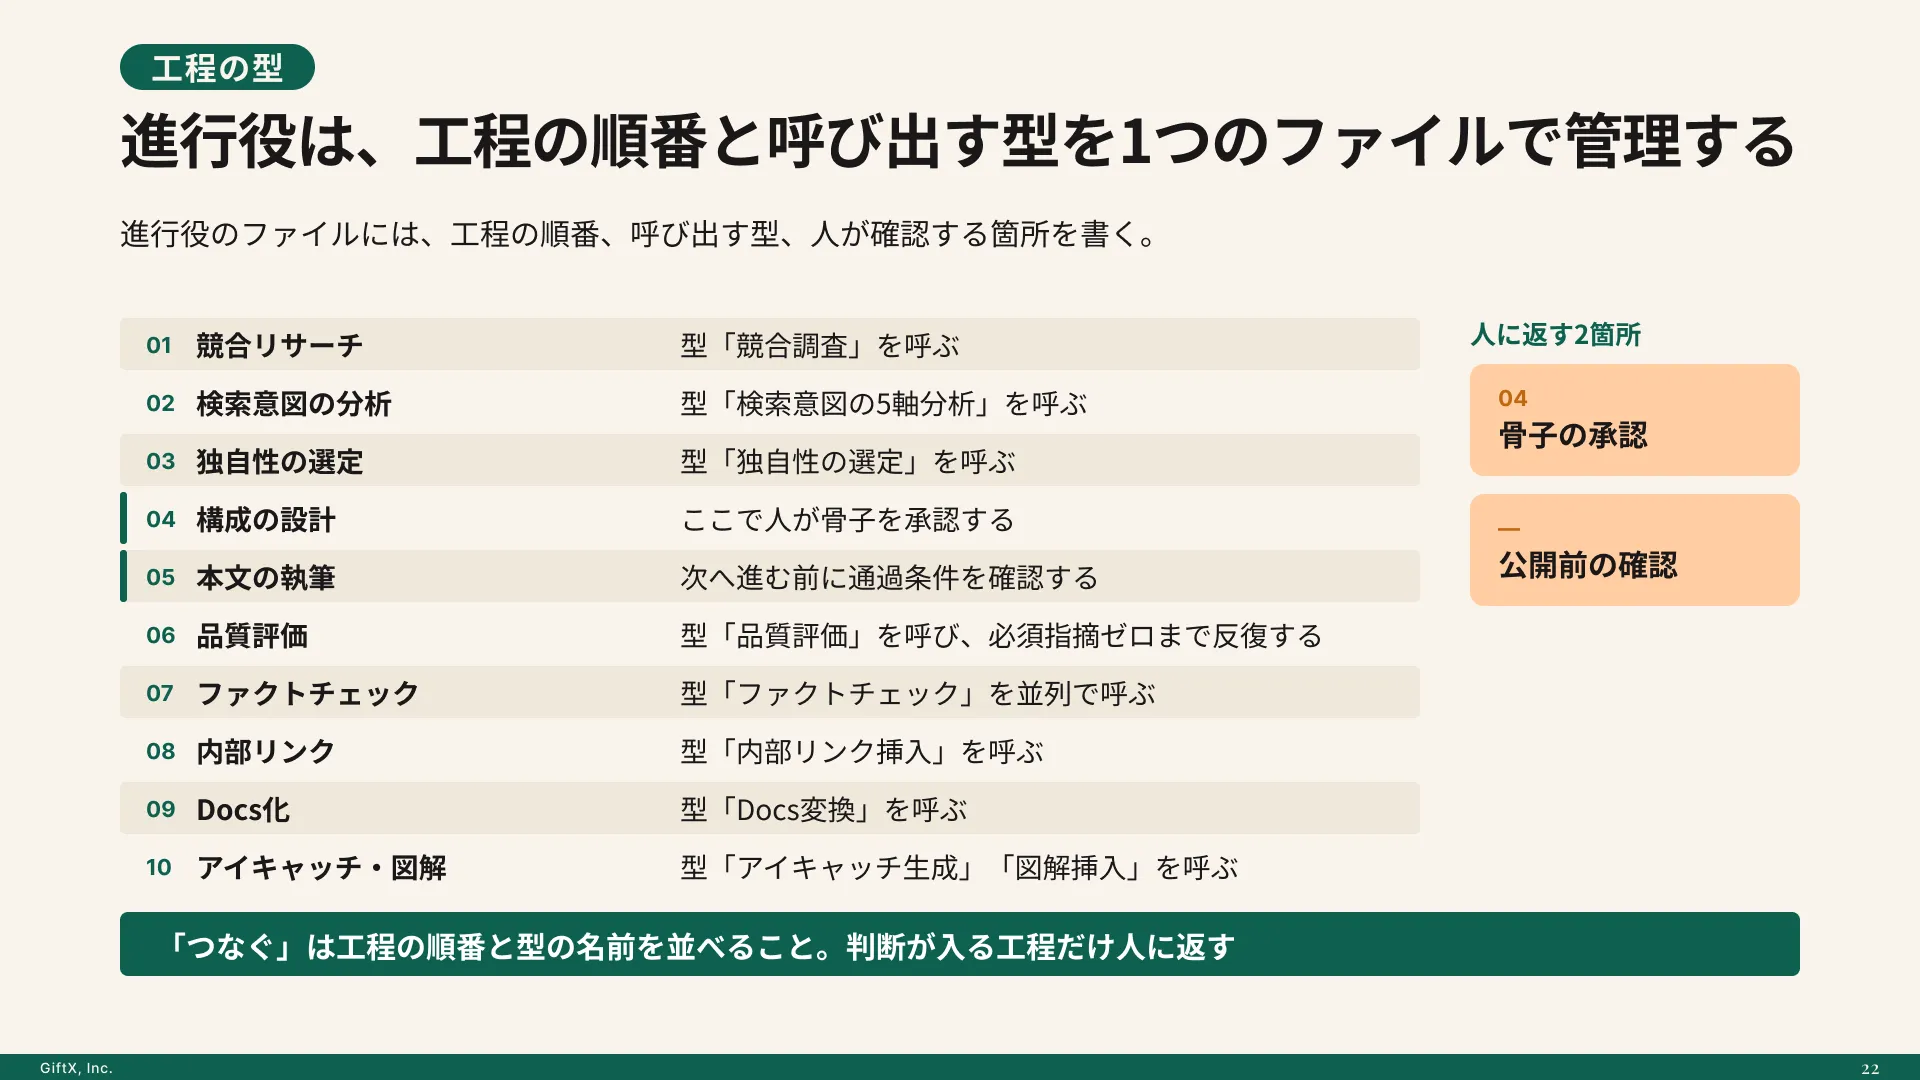
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
ツール利用と推論設定で処理を組み立てる
ツール利用は、モデルが外部の機能を呼ぶための仕組みです。モデルからの要求をアプリ側が受け、検索や計算などを実行し、その結果をモデルへ返します。Muse Spark 自体に社内システムの操作権限が自動で付くわけではなく、接続先や実行してよい処理を実装側で定めます。
Muse Spark 1.3には、難しい作業に向けた max の推論設定があります。ただし公式モデル一覧ではStandard枠のみの対応です。推論へより多くの処理を割く設定なので、短い定型処理まで一律に使うより、回答品質と待ち時間を同じ課題で比べて決めます。
正しさの確認は処理の外側にも用意する
資料の読み取り、コード生成、外部ツールの利用は、いずれも結果の正しさを保証するものではありません。例えば生成したコードは、実行環境や既存の仕様に合うかをテストで確認します。抽出した文章は、原文の条件や否定表現が抜けていないかを確認します。
最初の検証では、正解を人が把握している少数の入力を使います。成功した例だけでなく、資料に答えがない例や、条件が複数ある例も含めると、任せられる範囲を具体的に決められます。これはMuse Spark の実測結果ではなく、導入時の検証方法の提案です。
関連記事:ハルシネーションとは?意味・原因・対策と生成AIを安全に使うコツ
Muse Spark APIの使い方と始め方
Muse Spark をプログラムから呼ぶ場合は、Meta Model APIのアカウントとAPIキーを用意します。2026年9月15日時点ではパブリックプレビューとして案内されており、初期発表時の限定APIプレビューだけを見て利用可否を判断しないようにします。
手順1:アカウントと利用条件を確認する
まず公式クイックスタートから、Meta Model APIのアカウントを準備します。利用資格や課金条件は登録画面の案内で確認します。この記事では日本からのアカウント作成や有料契約を実行していないため、すべての読者が同じ条件で登録できるとは断定しません。
続いてダッシュボードのAPI keysでキーを発行します。APIキーは呼び出し元を認証する秘密情報です。共有資料、公開リポジトリ、ブラウザ側のソースコードには直接書かず、サーバー側の環境変数などから読み込む形にします。
手順2:接続先とモデルIDを設定する
基本の接続先は https://api.meta.ai/v1 です。テキストを送る最小構成では、Responses APIの /responses に対して、モデルIDと入力を渡します。以下は公式サンプルの各設定が何を担うかを整理したものです。
| 設定 | 指定する値 | 役割 |
|---|---|---|
| 接続先 | `https://api.meta.ai/v1` | MetaのAPIへ接続します |
| 認証 | 発行したAPIキー | 呼び出し元のアカウントを識別します |
| model | `muse-spark-1.3` | 使用するモデルを指定します |
| input | 質問や処理の指示 | モデルへ渡す内容を指定します |
OpenAI のSDK(Software Development Kit、開発用のライブラリ集)を使う方法も公式で案内されています。この場合でも、接続先はMetaです。ライブラリの名前だけでOpenAIのモデルを呼ぶと判断せず、接続先とモデルIDを確認します。
手順3:小さな入力で回答を受け取る
Python を使う場合、公式手順はPython 3.9以上を前提としています。pip install openai でライブラリを導入し、APIキーを環境変数 MODEL_API_KEY へ保存します。キーの値を表示する必要はありません。
プログラムでは from openai import OpenAI で読み込み、接続先とキーを指定してクライアントを作成します。公式例の指定は OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"]) です。環境変数を読むための import os も必要です。
client.responses.create(model="muse-spark-1.3", input="日本の首都はどこですか?") で回答を作ります。MODEL_API_KEY はSDKが自動で読む既定名ではないため、api_key へ明示して渡します。実行できる一式は公式クイックスタートで確認できます。
手順4:エラーと利用量を確認してから組み込む
接続できない場合は、エラーの種類に沿って確認します。401は認証、404はモデル名や対象の指定、429は利用上限をまず確認する目安です。キーをチャットへ貼って相談するのではなく、秘密情報を除いたエラーコードと設定項目を確認します。
公式のレート制限はAPIキー単位ではなくチーム単位です。複数の処理が同じチームを使うと利用量を共有します。429が出たときにすぐ連続で再送せず、待ち時間を段階的に延ばして再試行する設計にします。
最小の呼び出しが成功した後で、実際に扱う資料、必要な出力形式、1回の処理量を追加します。試験用の入力を固定し、正確性・応答時間・課金対象の使用量を記録してから、定期実行や外部システムへの書き込みへ広げます。
Muse Spark APIの料金とデータ利用条件
Muse Spark APIはトークンの使用量に応じた従量課金です。StandardとContributorでは単価に加え、入力と出力をモデルの学習に使う条件が異なります。安さだけで選ばず、送信する資料に適用できる条件かを先に確認します。
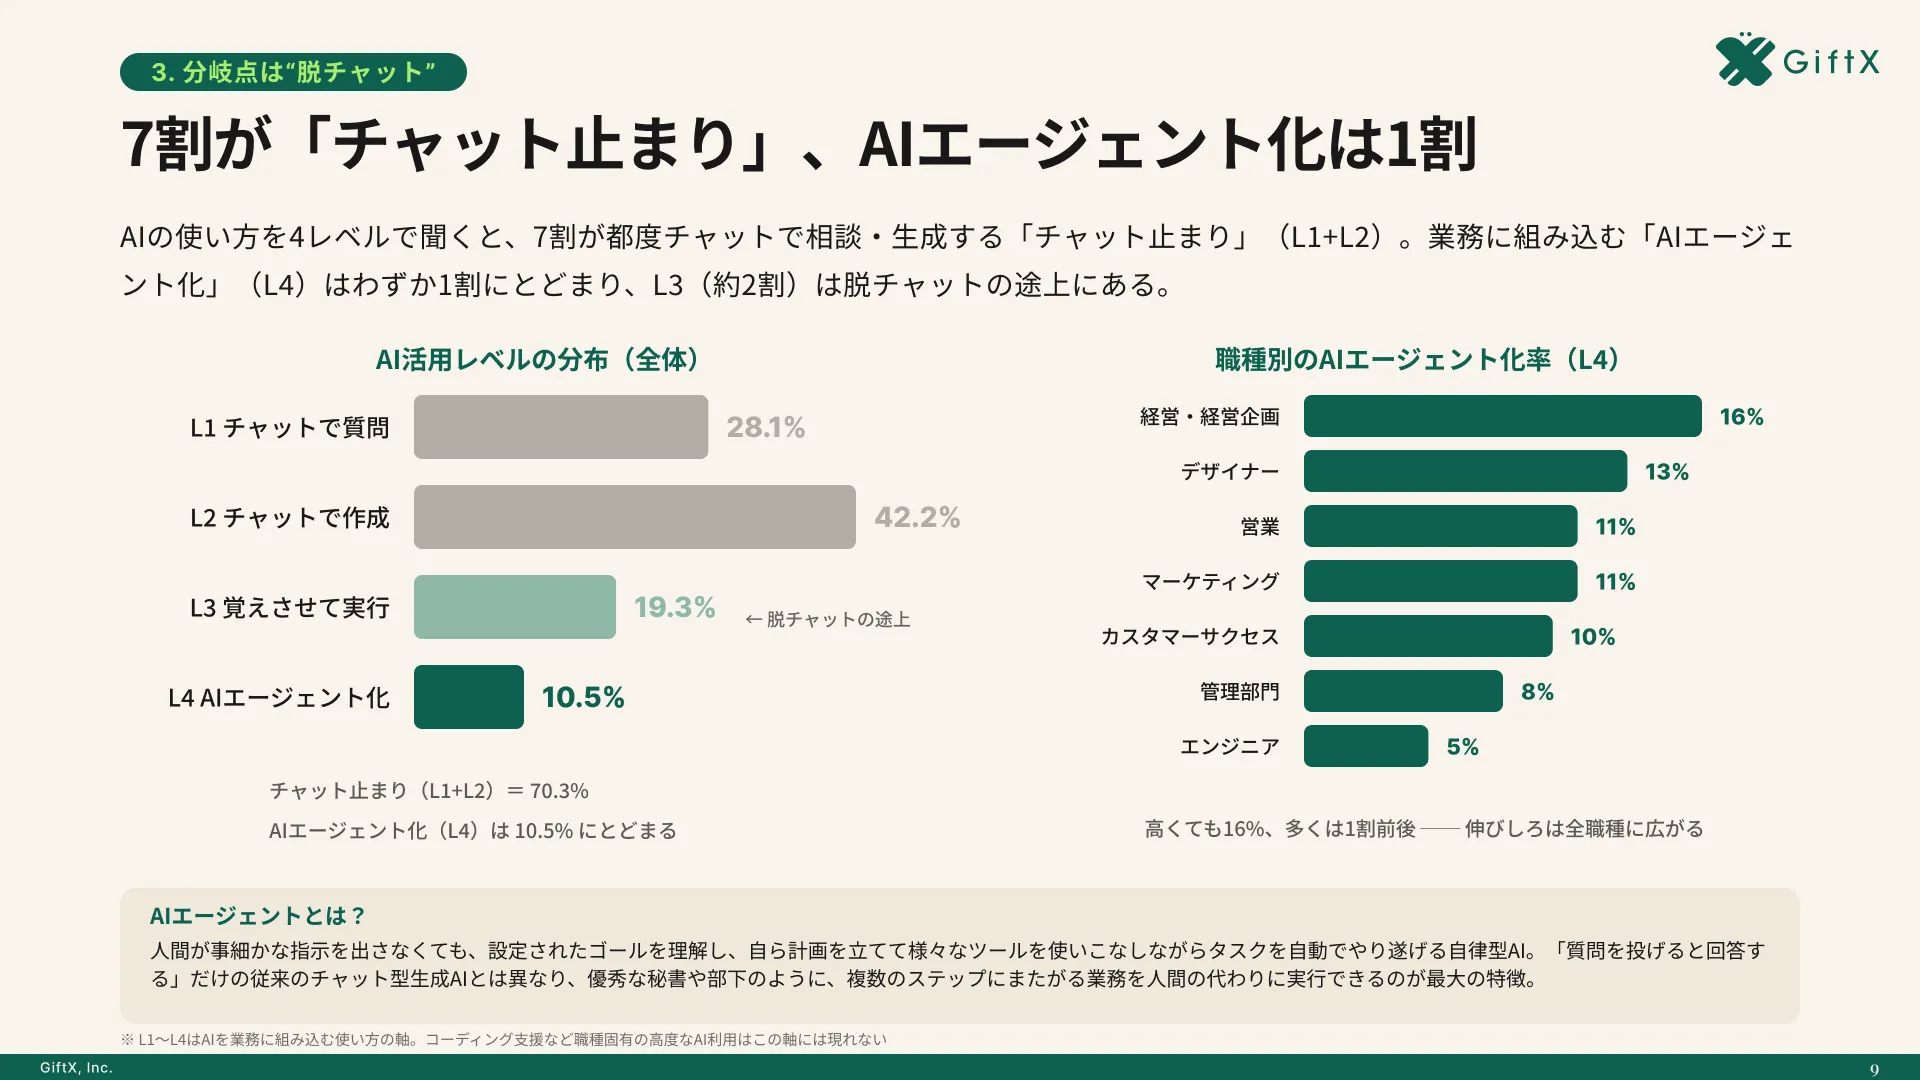
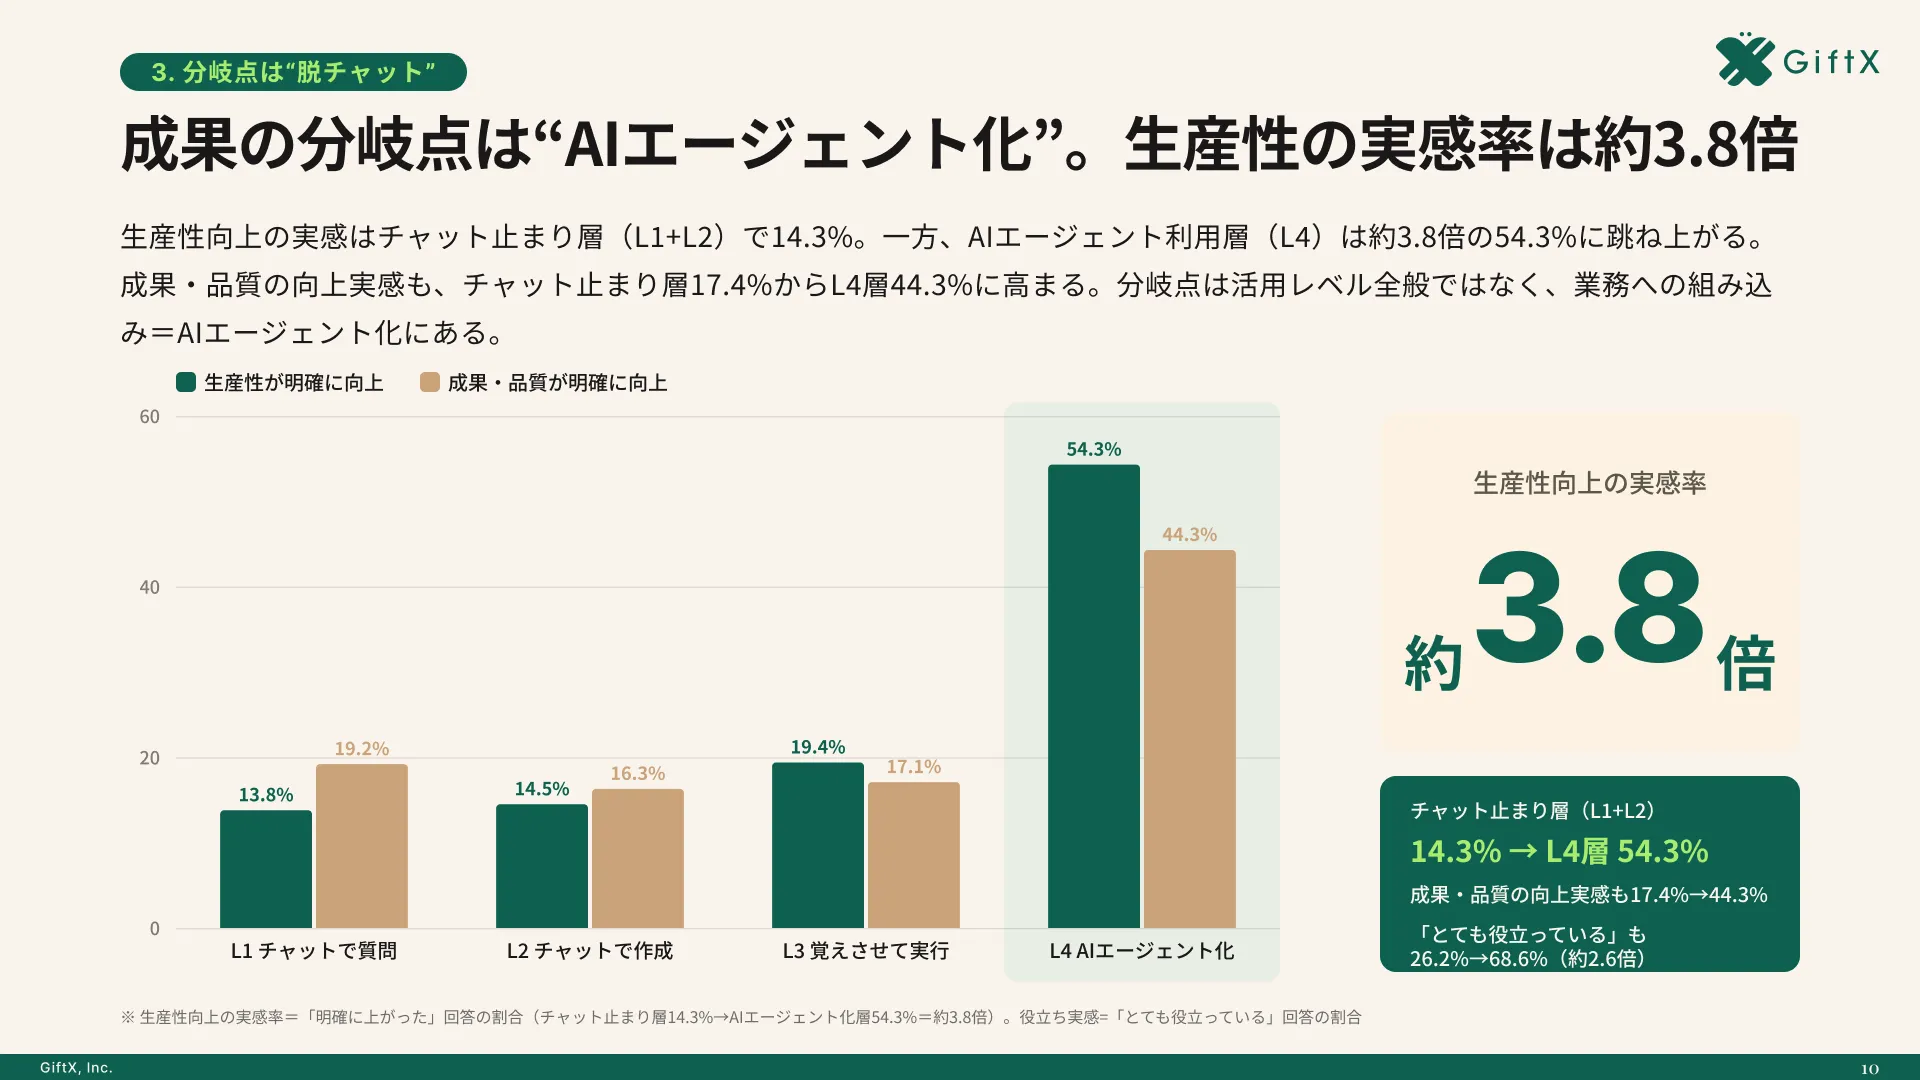
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
StandardとContributorの単価
下表は1.3の100万トークン当たりの料金です。キャッシュ入力は、再利用可能な入力に対する別の単価を指します。表示単価だけで毎月の総額が決まるわけではなく、入力・出力・追加機能の使用量を合わせて見ます(最新確認時点(2026年9月)、出典: meta.ai)。
| 項目 | Standard | Contributor |
|---|---|---|
| 入力 | 1.25米ドル | 0.10米ドル |
| キャッシュ入力 | 0.15米ドル | 0.002米ドル |
| 出力 | 4.25米ドル | 0.20米ドル |
| 入出力の学習利用 | Metaのモデル学習に使わない枠 | モデル学習への利用を許可する枠 |
例えば、短い質問でも長い回答を大量に生成すれば出力の使用量が増えます。最初は処理件数と回答の長さを限定し、実際の利用量を確認します。最新の単価と条件は公式料金ページにまとめられています。
学習利用と保存・契約条件を分けて確認する
Standardの「学習に使わない」という説明だけで、保存期間やデータ処理の全条件まで判断しないようにします。社内資料を送る前に、適用される規約、送信してよい情報、運用上の保存要件を確認します。
Contributorは、学習への利用を許可する条件を受け入れる枠です。公開済みのテスト用データで試す場合と、非公開の資料を継続処理する場合を同じ基準にせず、対象の情報ごとに利用枠を決めます。
Muse Sparkを業務で活用するときに陥りがちな3つの落とし穴
Muse Spark を導入するときは、モデルが回答できることと、業務を最後まで任せられることを分けて考えます。まず対象の作業を限定し、入力から確認までを一巡させると、追加すべき仕組みが見えてきます。
例えば資料の要点を整理する作業なら、資料を渡す人、要点に含める項目、回答を確認する人を決めます。モデルを選ぶだけで終わらせず、こうした前後の担当まで決めることが、小さく導入する準備になります。
落とし穴1|複数の作業を最初からつなぐ
資料の取得、要約、保存、通知まで一度につなぐと、失敗した場所を見つけにくくなります。まずは要約など1つの処理を取り出し、入力と期待する結果を固定して確認します。
落とし穴2|価格だけで利用枠を決める
単価だけを見てContributorを選ぶと、送信する資料の扱いと条件が合わない場合があります。最初の1業務で使うデータを洗い出し、その範囲に合う利用枠を選びます。
落とし穴3|回答できたら自動実行へ進む
回答が自然でも、資料の読み違いや処理の抜けは起こり得ます。最初は人が結果を確認する工程を残し、1業務で安定して確認できた範囲から、任せる処理を広げます。
スモールスタートで1業務をAIエージェントに任せる
最初の対象には、入力がそろい、結果の良し悪しを確認できる作業を選びます。処理前の準備、モデルへの指示、結果の確認をひとまとまりにし、例外時には人へ戻す流れも決めます。
モデルの比較だけで止めず、実際の1業務を一巡させることが次の判断につながります。小さく始めるための業務選定や実装は、GiftX AIエージェント構築支援でも相談できます。
Muse Sparkのよくある質問
Muse Sparkを無料で使えますか?
Meta AIの利用条件とMeta Model APIの課金は別に確認します。本記事で扱うAPIは従量課金の料金表が公開されています。初期発表や別製品の無料利用に関する情報だけで、APIの継続利用も無料と判断しないようにします。
Muse Sparkは自分のパソコンで動かせますか?
本記事で確認したMuse Spark は、MetaがホストするモデルをAPIや対応製品経由で利用するものです。公式モデル一覧にあるMuse Glimmerは別のオープンウェイトモデルです。名前が似ていても、Sparkのモデルをダウンロードして動かす手順と混同しないようにします。
Muse Codeの契約があればAPIも使い放題ですか?
Muse Codeのサブスクリプション説明では、月額契約はMuse Code向けの認証に適用され、追加で作成したAPIキーは従量課金とされています。月額契約の存在だけで、自作アプリからのAPI呼び出しまで定額になるとは判断できません。
OpenAIのSDKが使えるならコードはそのまま移せますか?
接続先やAPIキー、モデルIDを変更して利用できる場合がありますが、すべての機能が同じ挙動になるとは限りません。使用するAPI形式とパラメーターを公式資料で確認し、まず小さな入力で応答形式を確かめます。既存アプリ全体の移行は、その確認後に進めます。
まとめ
Muse Spark は推論を担うモデル、Meta AIは利用者が対話するアシスタントです。自分の仕組みへ組み込む場合はMeta Model APIを使い、モデルID、入出力、課金条件を確認します。
2026年9月15日時点では1.3を利用でき、StandardとContributorでは単価と学習利用条件が異なります。まず1業務をスモールスタートで試し、回答の確認と例外時の対応まで含めて、任せられる範囲を決めましょう。
AIエージェントの導入を進めたい方へ
AIを自社の業務へ組み込む方法を具体的に相談したい方は、ぜひGiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせた1業務単位のスモールスタートから本番運用まで支援します。対象業務の洗い出し、試作、運用の確認、社内で使い続けるための整備まで伴走します。
まずは、どの作業から始めるかを一緒に整理しましょう。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら