Stable Diffusionとは|文章から画像を作るオープンな画像生成AI
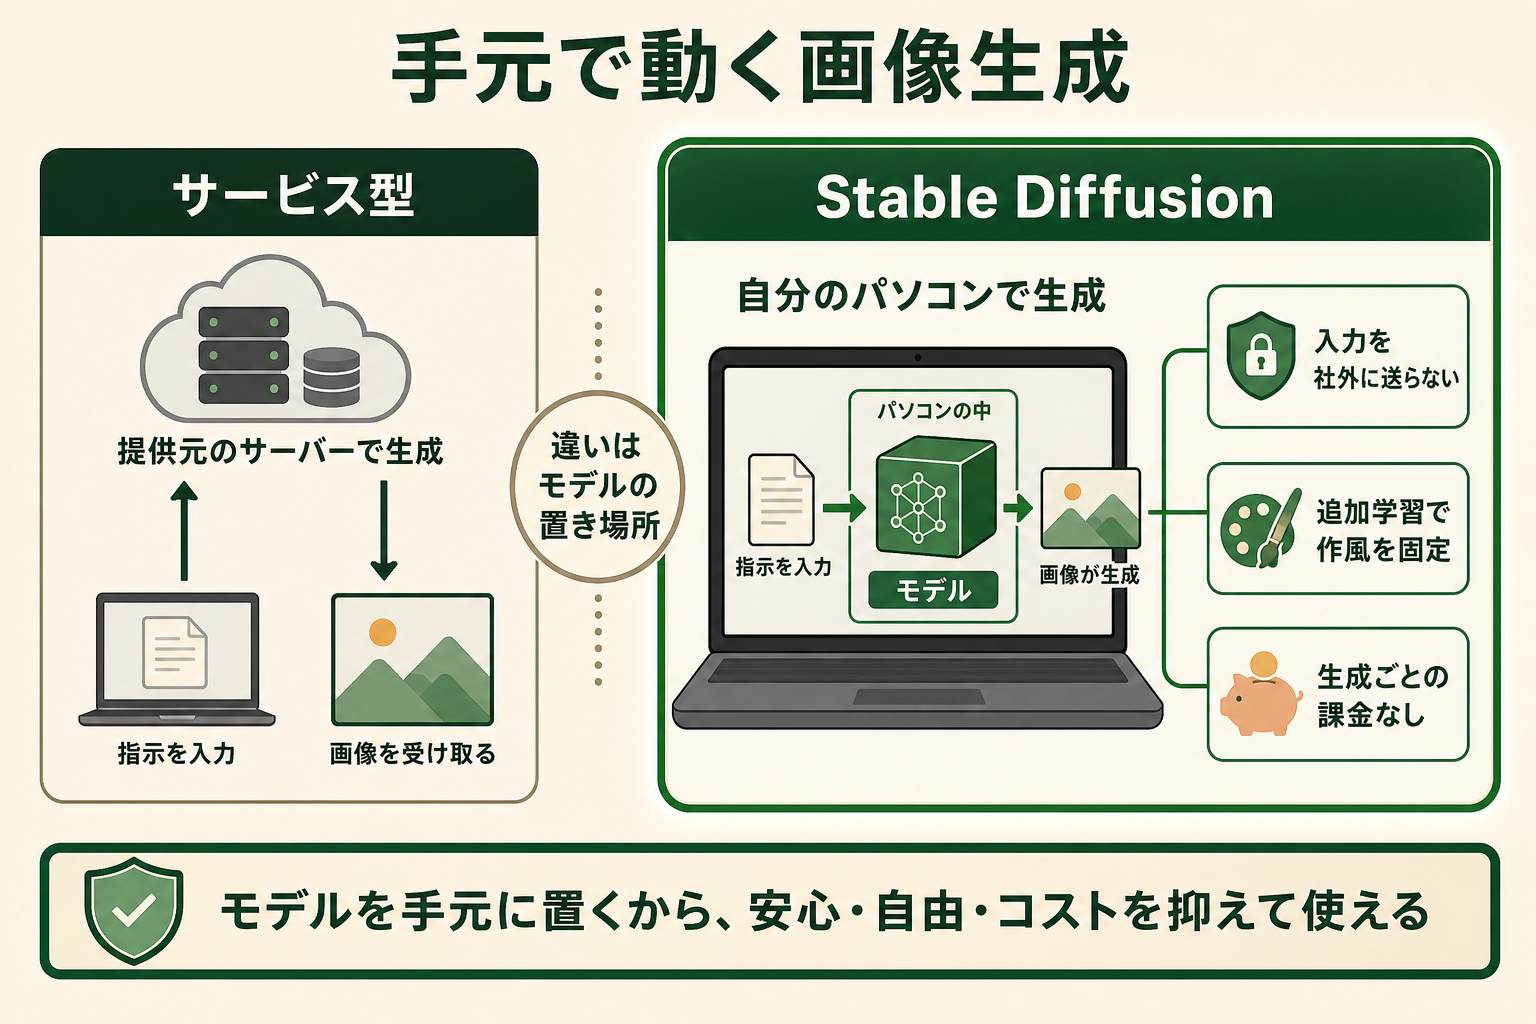
Stable Diffusionとは、英国のStability AIが開発し、モデルの重み(学習済みのデータ)を公開している画像生成AIです。
関連記事:画像生成AIの種類一覧|主要ツールの特徴・料金・選び方を比較
開発元と、モデルが公開されている意味
Stable Diffusionは2022年に最初のモデルが公開され、その後も改良版が順に出てきました。ChatGPTやMidjourneyのように提供元のサーバーでだけ動くサービスとの最大の違いは、モデルの本体をダウンロードして自分の環境で動かせる点です。
モデルが手元にあると、生成のたびに料金がかからず、入力した文章や画像を社外に送らずに済みます。さらに、自社の画像を追加で学習させて作風を固定するなど、提供元が想定していない使い方まで広げられます。この自由度の高さが、公開から数年たった今も利用者が多い理由です。
一方で、動かすにはGPU(画像処理用の半導体)を積んだパソコンと、ソフトの導入作業が必要です。ブラウザを開けばすぐ使えるサービスと比べると、最初の1枚までの手間は大きくなります。
「時代遅れ」と言われる理由と2026年の位置づけ
基盤モデルの更新が2024年で止まっている
検索候補に「時代遅れ」という言葉が出るのは、基盤モデルの更新が止まって見えるためです。Stability AIが公開した最新の画像モデルは、2024年10月22日に発表されたStable Diffusion 3.5で、2026年11月時点でもこれが同社サイトの最上位モデルとして案内されています。この間に、他社からも高性能なオープンウェイト(重みを公開した)モデルが相次いで登場しました。
同社の発表も、ここ1年ほどは音楽生成のStable Audioや、企業向けの制作基盤Brand Studioが中心です。2026年4月に発表されたBrand Studioは、Stable Diffusionに加えてGoogleのNano Bananaなど他社モデルも使い分ける仕組みと説明されています。
それでも使われ続けている理由
ただし、使えなくなったわけではありません。3.5は2025年にNVIDIA製GPU向けの高速化版やAmazon Bedrockでの提供が進み、ローカル実行の定番ソフトComfyUIも2026年11月時点で更新が続いています。
使われ続けている理由は、モデルを手元に置ける画像生成AIのなかで、解説・拡張機能・派生モデルの蓄積が最も厚いことです。困ったときに調べれば答えが見つかりやすく、目的に合う派生モデルも探しやすいため、初めてローカルで画像生成を試す人の入口として選ばれています。
最新の画質を競う道具というより、手元で自由に動かせる画像生成の基盤として使われている、と捉えると実態に近いでしょう。文字入りの画像や、すぐに完成度の高い1枚がほしい用途では、後述するサービス型のほうが合う場面も増えています。
Stable Diffusionでできること
Stable Diffusionは、文章からの画像生成を中心に、手持ちの画像の加工や作風の作り込みまで1つの仕組みで扱えます。代表的な使い方は次のとおりです。
- 文章から画像を作る:プロンプト(生成の指示文)から写真風・イラスト・3DCG風などの画像を生成する
- 画像をもとに作り直す:手描きのラフや既存の画像を下敷きにして、構図を保ったまま描き直す
- 一部だけ描き直す:インペイント(指定範囲の描き直し)で不要物を消したり、背景だけを差し替えたりする
- 画像を広げる:アウトペイントで、画像の外側を自然に描き足して縦横比を変える
- 作風を学習させる:LoRA(少ない画像で追加学習する手法)で、特定のキャラクターや画風を再現する
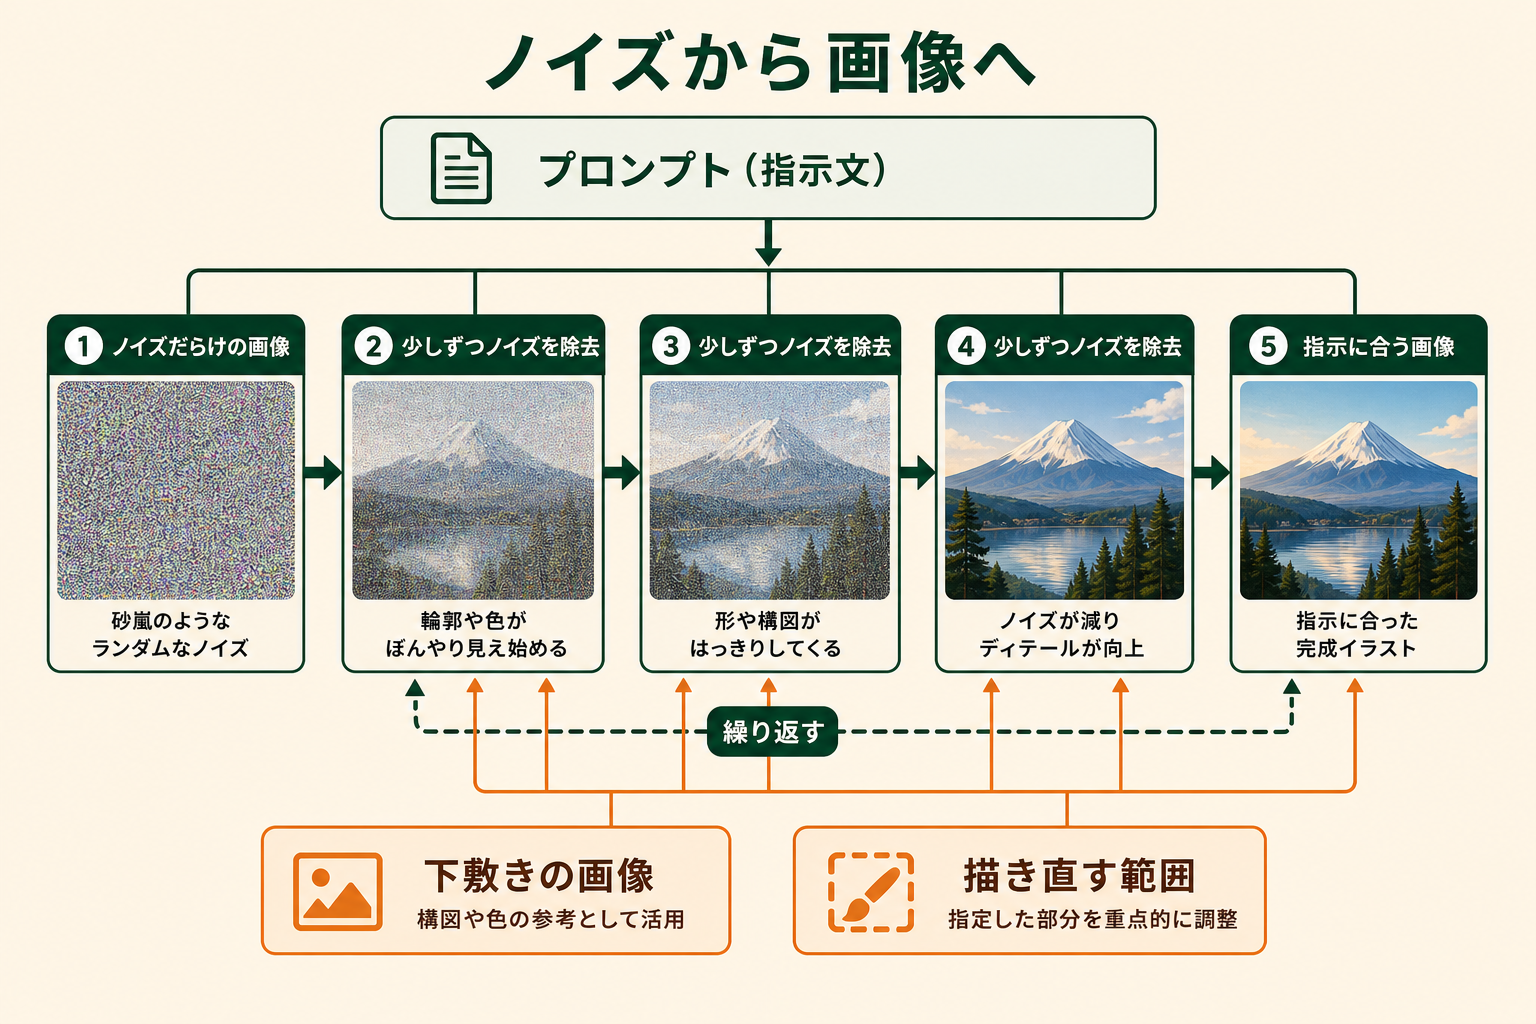
これらは拡散モデルという仕組みで動いています。ノイズだらけの画像から少しずつノイズを取り除き、指示文に合う画像へ近づけていく方式です。ノイズを取り除く途中の画像を外から操作しやすいため、下敷き画像や描き直す範囲を指定する使い方と相性がよいとされています。
最新の3.5では、指示文を読み取る部品(テキストエンコーダー)を3つ組み合わせ、MMDiTと呼ばれる構造で文章と画像を同時に扱います。モデルカードでは、旧世代より画質や画像内の文字、複雑な指示の理解が改善したと説明されています。
ローカルで動かす場合は、ControlNet(線画や人物のポーズで構図を指定する拡張)などコミュニティ製の拡張も組み合わせられます。提供元が用意した機能の範囲で使うWebサービスと違い、必要な機能を自分で足していける点が強みです。
仕事で使う場面としては、商品写真の背景だけを季節に合わせて差し替える、資料やブログに載せる挿絵を作る、広告やパッケージのデザイン案を短時間で何十案も並べる、といった使い方が代表的です。いずれも、元の画像を社外に出さずに加工できる点がローカル実行の利点になります。
Stable Diffusionのモデルの種類|1.5・XL・3.5の違い
Stable Diffusionは1つのモデル名ではなく、世代ごとに複数のモデルがあります。2026年時点で選択肢になる主なモデルを整理しました。
| モデル | 公開時期 | 特徴 | ライセンス |
|---|---|---|---|
| Stable Diffusion 3.5 Large | 2024年10月 | 81億パラメータの最上位モデル。画質と指示への忠実さを重視 | Stability AI Community License |
| Stable Diffusion 3.5 Large Turbo | 2024年10月 | Largeを軽量化し、4ステップで生成できる高速版 | Stability AI Community License |
| Stable Diffusion 3.5 Medium | 2024年10月 | 25億パラメータ。一般的なパソコンでの実行を想定 | Stability AI Community License |
| Stable Diffusion XL(SDXL) | 2023年7月 | 35億パラメータ。対応する拡張や派生モデルが多い | CreativeML Open RAIL++-M |
| Stable Diffusion 1.5 | 2022年 | 軽く動き、派生モデルが最も多い旧世代 | CreativeML OpenRAIL-M |
これから始めるなら、基本は3.5を選び、パソコンの性能に応じてLargeかMediumを決めます。Hugging FaceのStable Diffusion 3.5 Largeのモデルカードは、ローカルで使う場合の実行環境としてComfyUIを推奨しています。
公式モデルとは別に、利用者が追加学習して作風を変えた派生モデルも大量に公開されています。ローカルのWeb UIでは、こうしたモデルファイルをチェックポイントと呼び、入れ替えるだけで写真調からアニメ調まで画風を切り替えられます。派生モデルは、Hugging Faceのほか、画像生成モデルの共有サイトで配布されています。
旧世代のSDXLや1.5も、コミュニティが作った派生モデルや拡張が豊富なため、アニメ調など特定の作風では今も使われています。ただし1.5は、当初の配布元だったRunwayのリポジトリがすでに取り下げられ、有志の複製版が配布されている状態です。
Stable Diffusionの使い方・始め方|Web・ローカル・APIの3通り
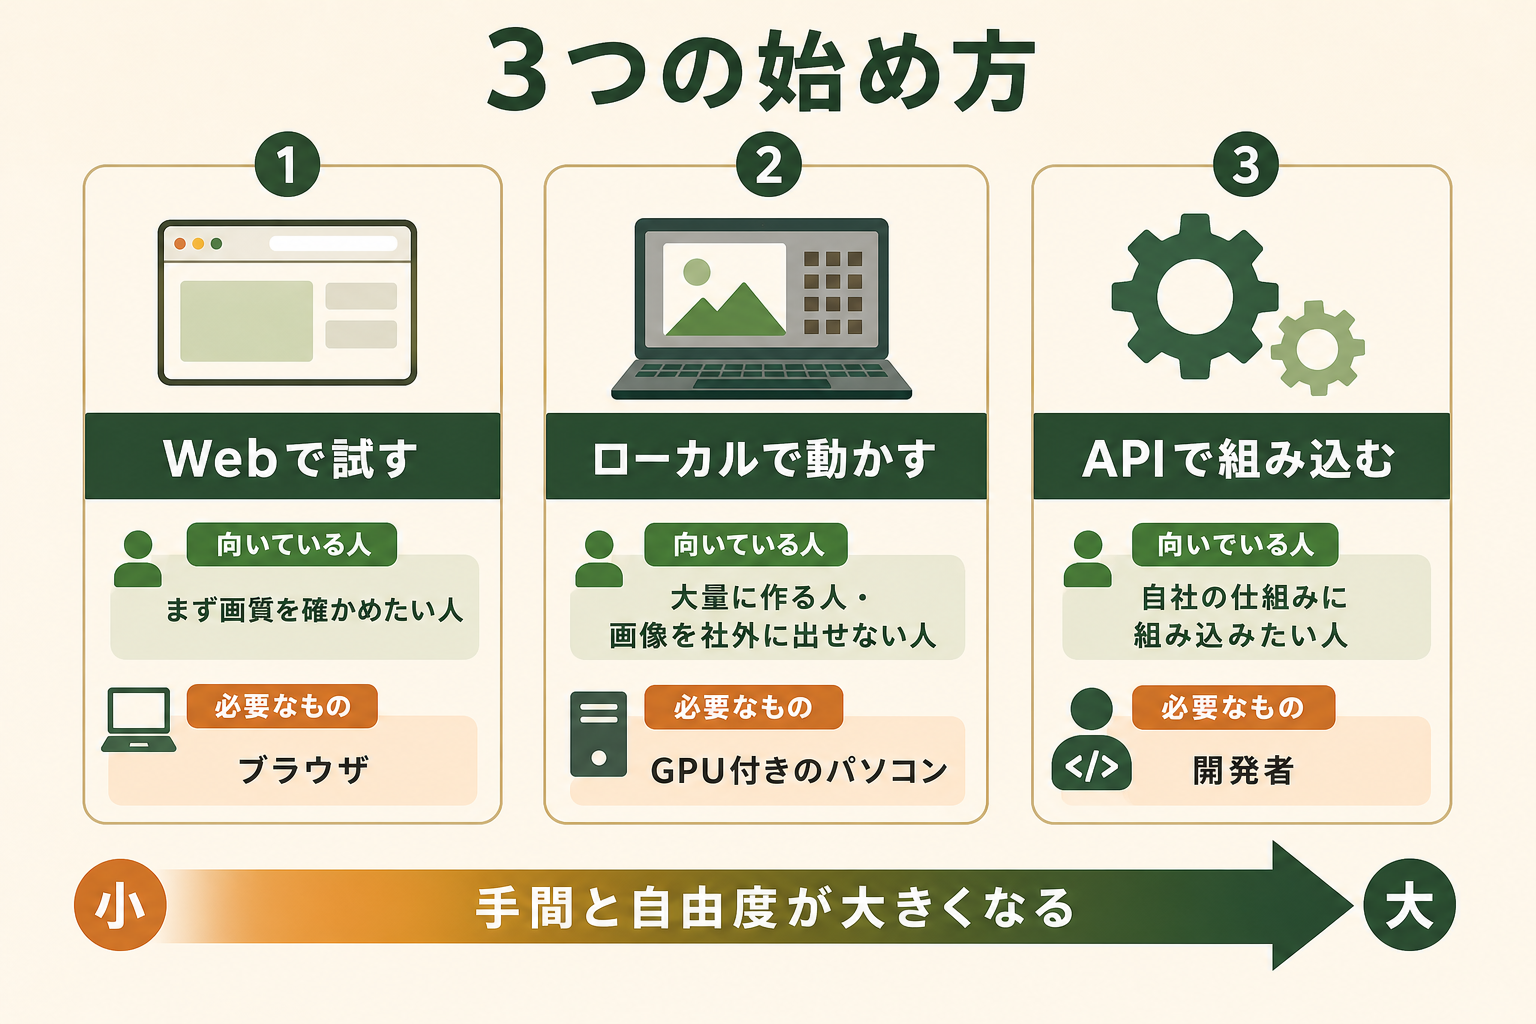
Stable Diffusionの使い方は、Webサービスで試す、自分のパソコンで動かす、APIで自社の仕組みに組み込む、の3通りです。手間と自由度の違いを先に押さえておくと、自分に合う入口を選びやすくなります。
| 始め方 | 必要なもの | 向いている人 |
|---|---|---|
| Webサービスで試す | ブラウザとアカウント | まず画質や操作感を確かめたい人 |
| ローカルで動かす | GPUを積んだパソコンと導入作業 | 費用をかけず大量に生成したい人、画像を社外に出せない人 |
| APIで組み込む | 開発者とAPIキー | 自社のサービスや業務の仕組みに画像生成を組み込みたい人 |
Webサービスで試す
手軽なのは、Webで動くサービスを使う方法です。Stability AIは以前DreamStudioというWebアプリを提供していましたが、2026年11月時点ではそのURLを開くとBrand Studioへ移動します。Brand StudioのCoreプランは無料で試せると案内されています。
このほか、Stable Diffusionのモデルを選んで使えるオンラインの画像生成サービスも多数あります。まずは数枚作ってみて、画質が用途に合うかを確かめてから、ローカルに進むかを決めると無駄がありません。
ローカルで動かす
自分のパソコンで動かす場合は、モデルファイルと、それを操作する画面(Web UI)を用意します。大まかな流れは次の4段階です。
- GPUの性能と空き容量を確認する
- ComfyUIなどのWeb UIをインストールする
- Hugging Faceで利用条件に同意し、モデルファイルをダウンロードする
- Web UIでモデルを読み込み、プロンプトを入力して生成する
パソコンの性能は、NVIDIA製GPUのVRAM(GPUに載ったメモリ)の量が目安になります。Stability AIは、3.5 Mediumの実行に必要なVRAMを9.9GB(テキストエンコーダーを除く)と案内しています。Largeはさらに多くのメモリを使うため、VRAMが少ない場合はMediumや軽量化したモデルを選びます。
Stable Diffusion Web UIの選び方
Web UIは、Stable Diffusionをマウス操作で使うための画面です。代表的なものは次の3つで、2026年11月時点では更新の状況に差があります。
| Web UI | 特徴 | 2026年11月時点の更新状況 |
|---|---|---|
| ComfyUI | 処理の部品(ノード)をつないで生成手順を組み立てる。3.5や他社の新しいモデルへの対応が早い | 2026年11月4日にv0.44.0を公開し、更新が続いている |
| AUTOMATIC1111(Stable Diffusion web UI) | 入力欄とボタンが並ぶ画面で、解説記事や拡張機能が最も多い | 最新版はv1.10.1。主要ブランチの更新は2024年7月以降止まっている |
| Forge | AUTOMATIC1111を土台に、メモリ効率と速度を改善した派生版 | 主要ブランチの最終更新は2025年6月 |
これから始めるならComfyUIが有力です。デスクトップ版のインストーラーが用意され、新しいモデルへの対応も早いためです。画面の見た目が複雑に感じる場合でも、公式が配布するワークフロー(生成手順の設定ファイル)を読み込めば、最初の1枚はすぐに作れます。AUTOMATIC1111は解説が豊富な一方、新しいモデルを使う場面では対応の遅れに注意が要ります。
思いどおりの画像に近づけるプロンプトの書き方
プロンプトは、何を描くかを先に書き、その後に画風や構図、光の当たり方を足していくと整理しやすくなります。たとえば「主題(ノートパソコンを使う女性)→画風(写真風)→構図(上半身、正面)→光(窓からの自然光)」の順に、英語で並べます。
入れたくない要素は、ネガティブプロンプトという別欄に書きます。「文字」「ぼやけ」「指の崩れ」などを指定すると、失敗作が減ります。ただし3.5は指示への忠実さが上がった分、旧世代の定番だった長い除外語の羅列は必要ないことが多く、まずは短く試します。
生成時の設定では、ステップ数(ノイズを取り除く回数)とガイダンススケール(指示文にどれだけ従わせるか)の2つが基本です。3.5 Largeのモデルカードの例では、ステップ数28、ガイダンススケール3.5〜4.5が使われています。同じ設定で数枚作り、良かった画像のシード値(乱数の起点)を固定して細部を詰めると、狙った画像に近づけやすくなります。
APIで組み込む
自社のサービスや業務の仕組みに組み込むなら、Stability AIのAPIを使います。サーバーやGPUを自前で用意せずに3.5などのモデルを呼び出せるほか、Amazon BedrockやMicrosoftのAzure AI Foundryなどのクラウドからも利用できます。料金は次の章で整理します。
Stable Diffusionの料金|無料で使える範囲と有料になる場面
Stable Diffusionは、使い方によって費用のかかり方が変わります。ローカルで動かす場合、モデルの利用料は年間売上100万ドル未満なら無料で、費用はパソコンと電気代だけです。APIを使う場合は、生成した枚数に応じてクレジットを消費します。
APIの主な料金は次のとおりです(2026年11月時点、Stability AI公式の料金ページより)。1クレジットは0.01ドルで、登録時に25クレジットが無料で付与されます。
| サービス | 1枚あたりのクレジット | 1枚あたりの目安 |
|---|---|---|
| Stable Image Ultra(3.5 Largeベースの最上位) | 8 | 0.08ドル |
| Stable Diffusion 3.5 Large | 6.5 | 0.065ドル |
| Stable Diffusion 3.5 Large Turbo | 4 | 0.04ドル |
| Stable Diffusion 3.5 Medium | 3.5 | 0.035ドル |
| Stable Diffusion 3.5 Flash | 2.5 | 0.025ドル |
| Stable Image Core | 3 | 0.03ドル |
| SDXL 1.0 | 0.9から | 0.009ドルから |
たとえば3.5 Largeで100枚作ると650クレジット、6.5ドルです。描き直しや高解像度化(アップスケール)は別料金で、4K相当まで引き上げるCreative Upscalerは1回60クレジットかかります(2026年11月時点)。
月に数百枚程度ならAPIの費用は数十ドルに収まりますが、試行錯誤を含めて数千枚単位で作るなら、1枚ごとの課金がないローカル実行のほうが総額を抑えやすくなります。反対に、GPU付きのパソコンを新たに用意する必要がある場合は、その購入費も含めて比べます。生成枚数と、手元のパソコンの性能の2つで選ぶのが現実的な考え方です。
有料になるのは、APIを使う場合と、年間売上が100万ドルを超える組織がモデルを使う場合の2つです。後者はEnterpriseライセンスの契約が必要で、料金は個別見積もりです。
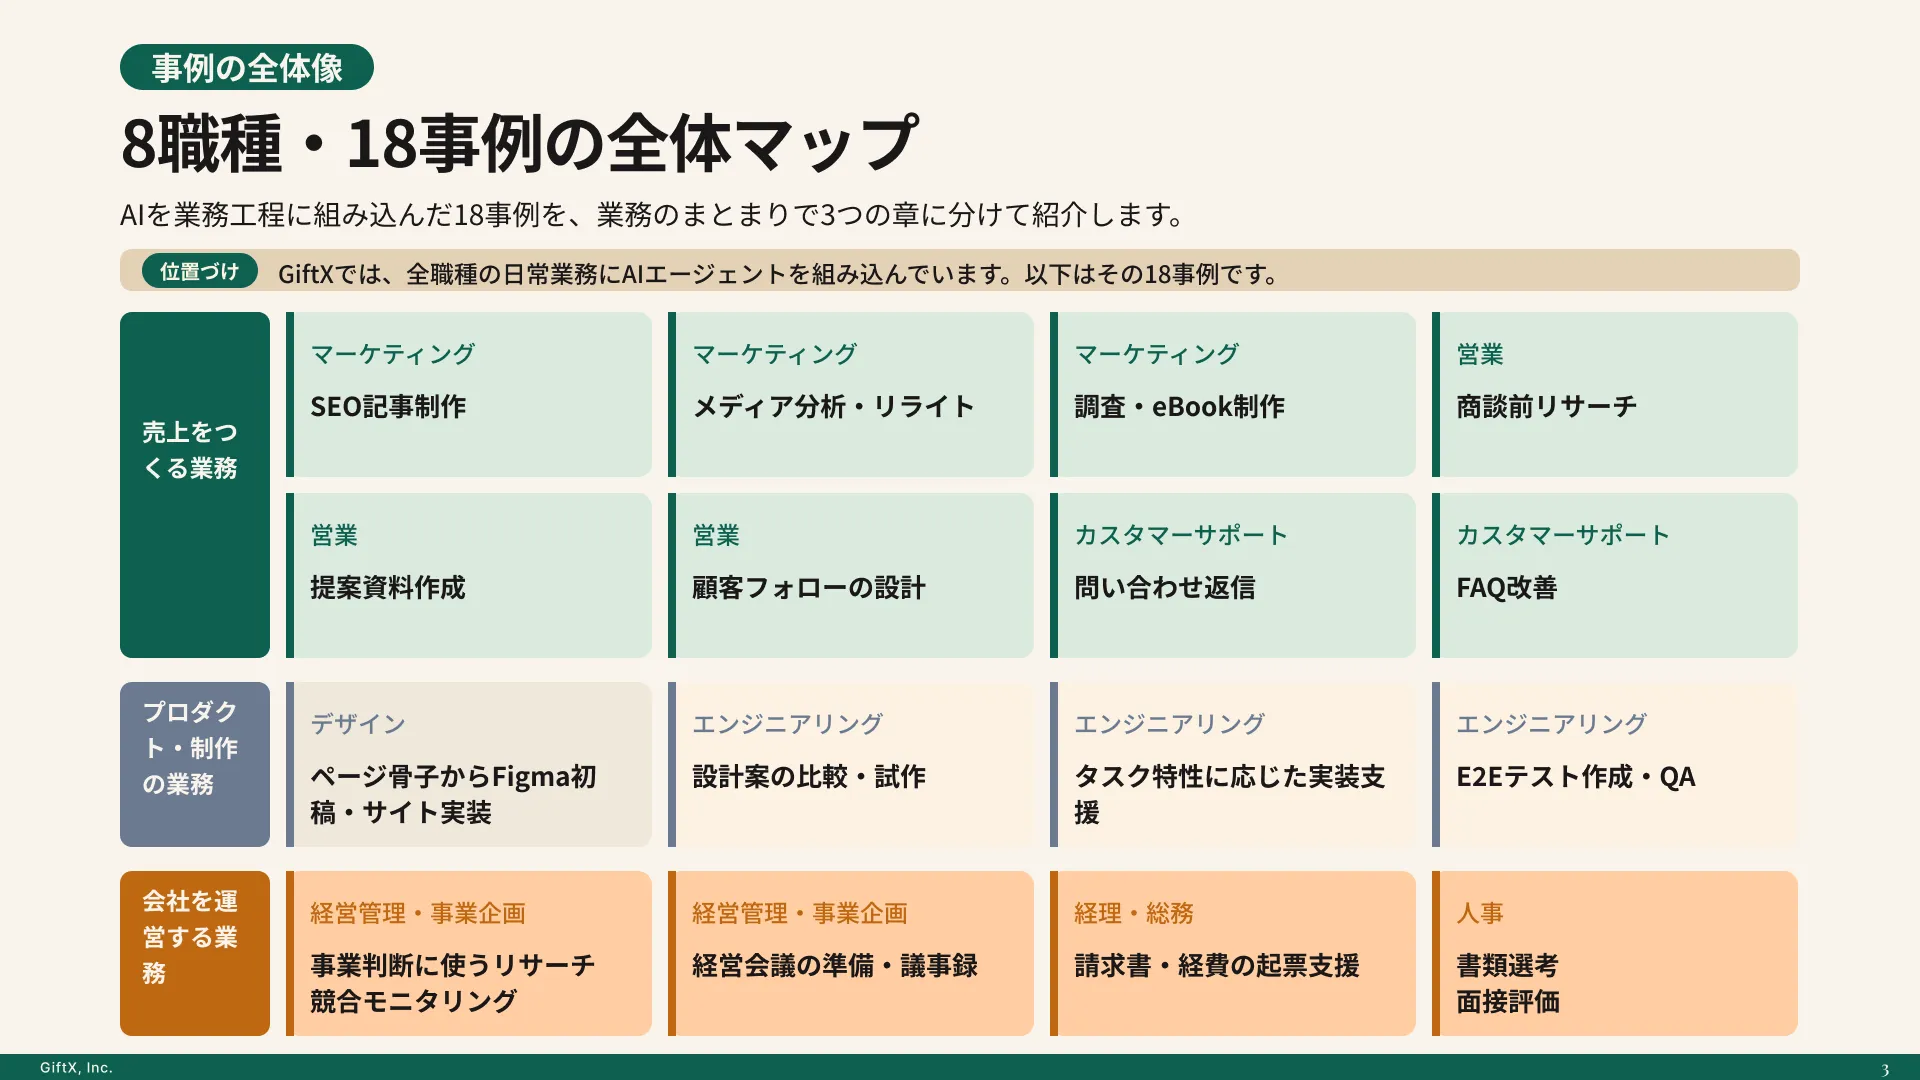
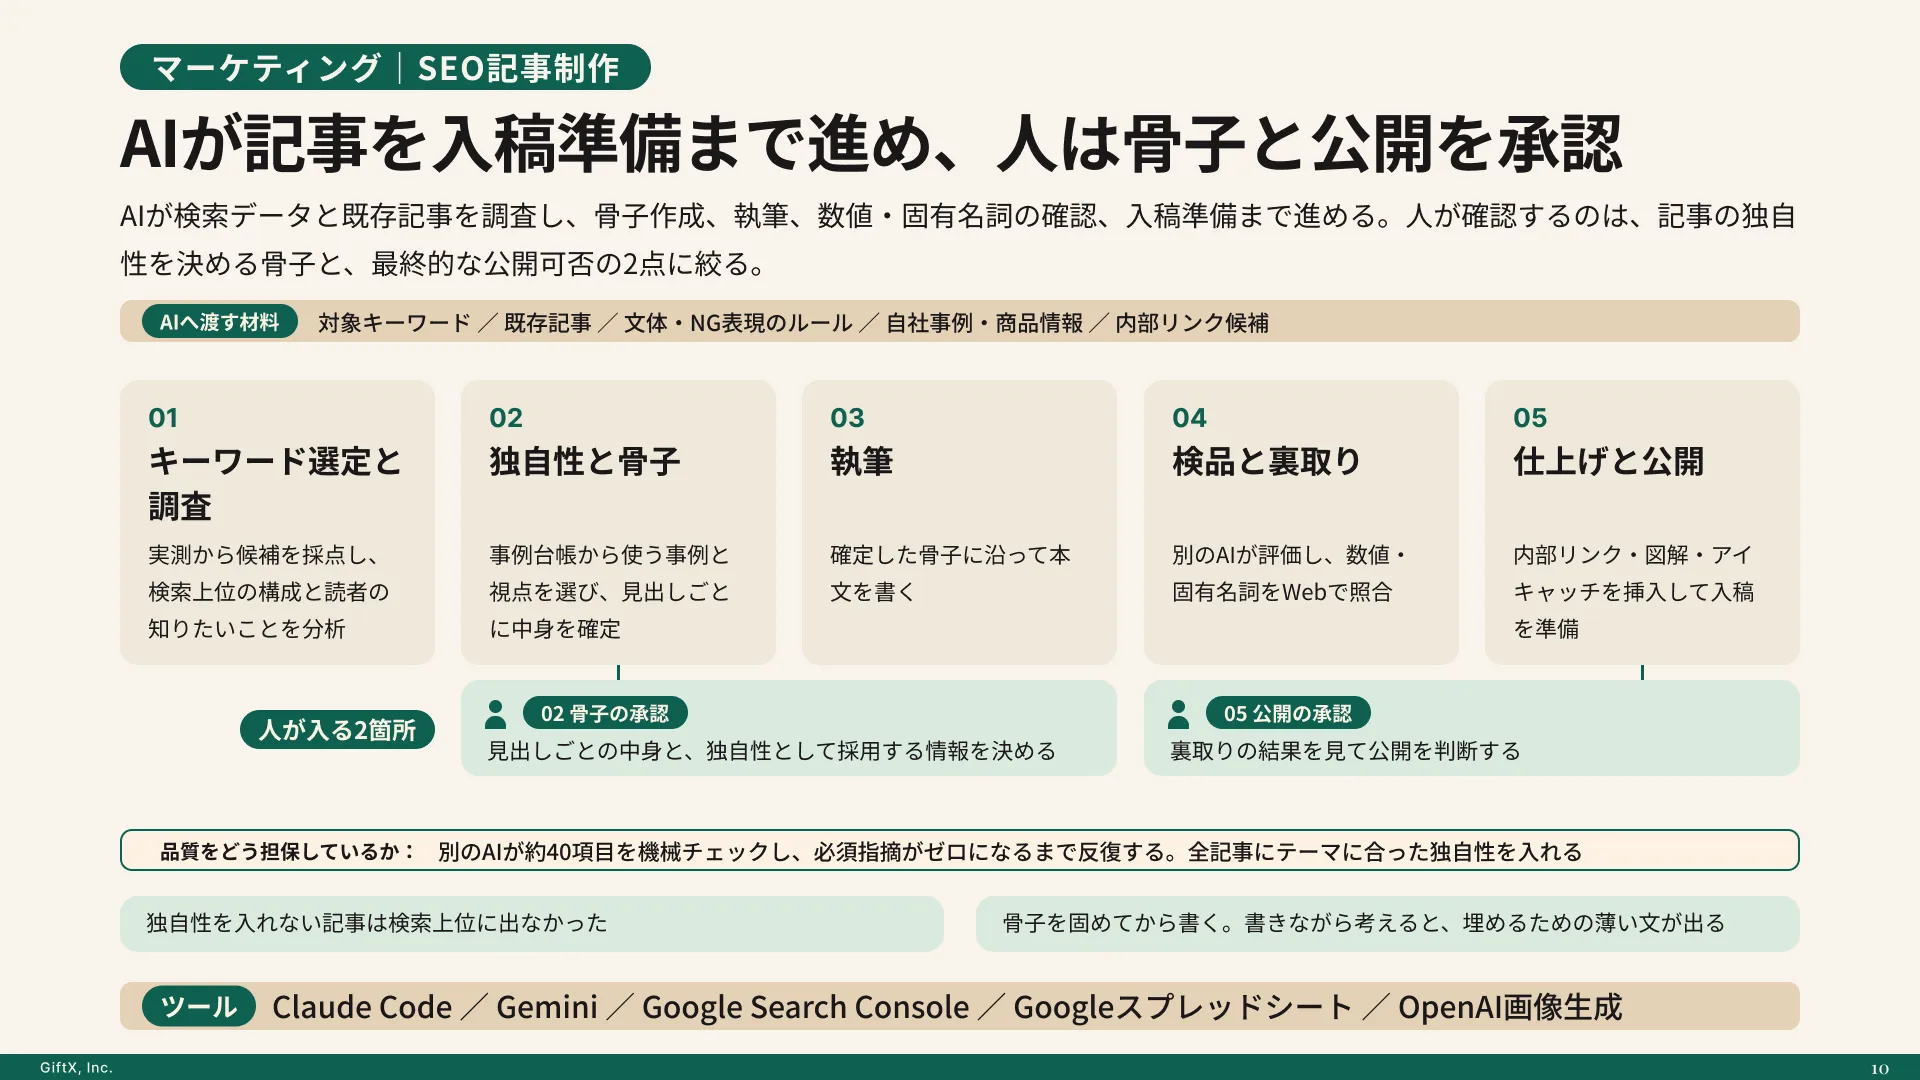
マーケ・営業から開発・経営・人事経理まで。8職種18業務のAI活用事例を無料公開中!
Stable DiffusionとMidjourney・ChatGPTの画像生成の違い
Stable Diffusionは、MidjourneyやChatGPTの画像生成と比べると、手間がかかる代わりに自由度とデータの扱いやすさで勝る位置づけです。下表は、使い始めやすさ・費用・カスタマイズ・データの扱いの4つの観点で比べたものです。
| 観点 | Stable Diffusion | Midjourney | ChatGPTの画像生成 |
|---|---|---|---|
| 使い始めやすさ | ローカルは導入作業が必要 | Webで登録後すぐ使える | ChatGPTの画面ですぐ使える |
| 費用のかかり方 | ローカルは無料、APIは枚数課金 | 有料プランへの加入が前提 | ChatGPTのプランに含まれる |
| カスタマイズ | 追加学習や拡張で大きく変えられる | 用意された設定の範囲 | 会話での指示と部分編集が中心 |
| データの扱い | 社外に送らずに生成できる | 提供元のサーバーで処理する | 提供元のサーバーで処理する |
| 日本語の扱い | プロンプトは英語のほうが安定しやすい | 日本語のプロンプトも使える | 日本語での指示と文字入れに強い |
画像に日本語の文字を入れたい、すぐに成果物がほしいという用途なら、ChatGPTのようなサービス型が向いています。GiftXの広告バナー制作でも、訴求軸の設計からバナー生成までをAIで回す工程を組み、画像生成にはサービス型であるGoogleのNano Banana Proを使っています。この工程で、1キャンペーンあたり10パターンに約3日かかっていた制作が、50パターン約4時間になりました。
一方で、Stable Diffusionが候補になるのは次のような条件があるときです。
- 作風を固定したい:自社の商品写真やキャラクターを学習させ、同じ雰囲気の画像を繰り返し作りたい
- 画像を外に出せない:未発表の商品画像や社外秘の資料を、外部のサーバーに送らずに加工したい
- 大量に作る:試作を含めて何千枚も作るので、1枚ごとの課金を避けたい
- 手順を自動化したい:ComfyUIのワークフローやAPIで、決まった加工を毎回同じ手順で回したい
どれにも当てはまらないなら、まずはサービス型で始め、条件が出てきた段階でStable Diffusionを検討する順番で問題ありません。個別のサービスについては、Midjourneyの使い方と料金やChatGPTの画像生成のやり方で詳しく解説しています。
関連記事:画像生成AIサービスおすすめ15選|特徴・料金・商用利用を横断比較
Stable Diffusionを使う前に知っておきたい注意点|商用利用・著作権・安全性
商用利用の条件はモデルごとに違う
3.5などのモデルは、Stability AI Community Licenseで提供されています。年間売上100万ドル未満の個人や組織は商用でも無料で使えますが、商用で使う場合はStability AIへの登録が必要です。売上は関連会社を含めて数えるため、親会社の売上で上限を超えるケースもあります。
SDXLや1.5は別のライセンス(CreativeML OpenRAIL系)で、商用利用は認められていますが、禁止された用途の一覧があります。コミュニティが配布する派生モデルは、作者が独自に条件を付けていることも多いので、モデルごとに配布ページの条件を確認します。
生成画像の権利と著作権
Community Licenseでは、生成した画像は法律が認める範囲で利用者のものとされています。ただし、既存の作品やキャラクターに似た画像を作れば、日本の著作権法でも侵害にあたる可能性があります。特定の作家名やキャラクター名をプロンプトに入れる使い方や、他人の作品で追加学習したモデルの使用は、商用では避けたほうが安全です。
実在の人物に見える画像の扱い
3.5のモデルカードは、実在の人物や出来事を事実どおりに表すようには学習していないと明記し、利用はStability AIの利用規定(Acceptable Use Policy)に従うよう求めています。実在の人物に見える画像を、本人の写真や報道の写真であるかのように使うのは避けます。広告などで人物の画像を使う場合は、生成画像であることを社内で記録しておくと、後から問い合わせを受けたときに説明しやすくなります。
ファイルと拡張機能の安全性
ローカルで使う場合は、モデルや拡張機能を外部から取り込む分だけ注意が必要です。モデルファイルは、実行可能なコードを含みにくいsafetensors形式のものを選び、出所の分からない拡張機能は入れないようにします。
関連記事:AIイラストの作り方|無料で使えるツールと著作権・商用利用の注意点
Stable Diffusionのよくある質問
Stable Diffusionは無料で使えますか?
年間売上100万ドル未満の個人や組織なら、ローカルで動かす限りモデルの利用料はかかりません。APIやWebサービスを使う場合は、生成枚数やプランに応じた料金がかかります。
どのくらいの性能のパソコンが必要ですか?
NVIDIA製GPUを積んだパソコンが基本です。Stability AIは、3.5 Mediumに必要なVRAMを9.9GB(テキストエンコーダーを除く)と案内しています。性能が足りない場合は、Webサービスから始めるのが無難です。
Macでも使えますか?
使えます。Hugging Faceのモデルカードには、Mac向けのアプリとしてDraw ThingsやDiffusionBeeが紹介されています。ただし、生成速度はNVIDIA製GPUを積んだパソコンに比べて遅くなる傾向があります。
インターネットにつながない環境でも使えますか?
使えます。モデルとComfyUIなどのWeb UIを一度インストールすれば、その後はオフラインでも生成できます。ComfyUIの公式サイトも、セットアップ後はインターネット接続なしで動かせると案内しています。
日本語のプロンプトは使えますか?
3.5のモデルカードで対応言語として示されているのは英語です。日本語でも一定の画像は出ますが、意図どおりにしたい場合は英語で書くほうが安定します。
Stable Diffusionは今から始めても遅くありませんか?
遅くはありません。最新モデルは2024年公開の3.5ですが、ローカルで無料かつ自由に動かせる点は今も他のサービスにない特徴です。日本語の文字入れや手軽さを重視するなら、サービス型と使い分けるのがよいでしょう。
まとめ
Stable Diffusionは、Stability AIが重みを公開している画像生成AIで、2026年11月時点の最新モデルは3.5です。基盤モデルの更新は2024年で止まっていますが、手元のパソコンで無料かつ自由に動かせる点は今も変わりません。
始め方は、Webで試す、ComfyUIなどでローカルに導入する、APIで組み込むの3通りです。まずWebで画質を確かめ、作風の学習やデータの持ち出し制限といった必要が出てからローカルやAPIへ進むと、手間をかけすぎずに済みます。商用で使う場合は、年間売上100万ドルの条件と登録、モデルごとのライセンスを最初に確認しておきましょう。
画像を含むコンテンツの制作体制まで整える段階では、GiftXが検証工程を含めた制作を1コンテンツ単位から支援しています。詳細はAI活用コンテンツ制作支援をご覧ください。