Muse Glimmerとは|MacやGPU 1枚で動くMetaのオープンウェイトモデル
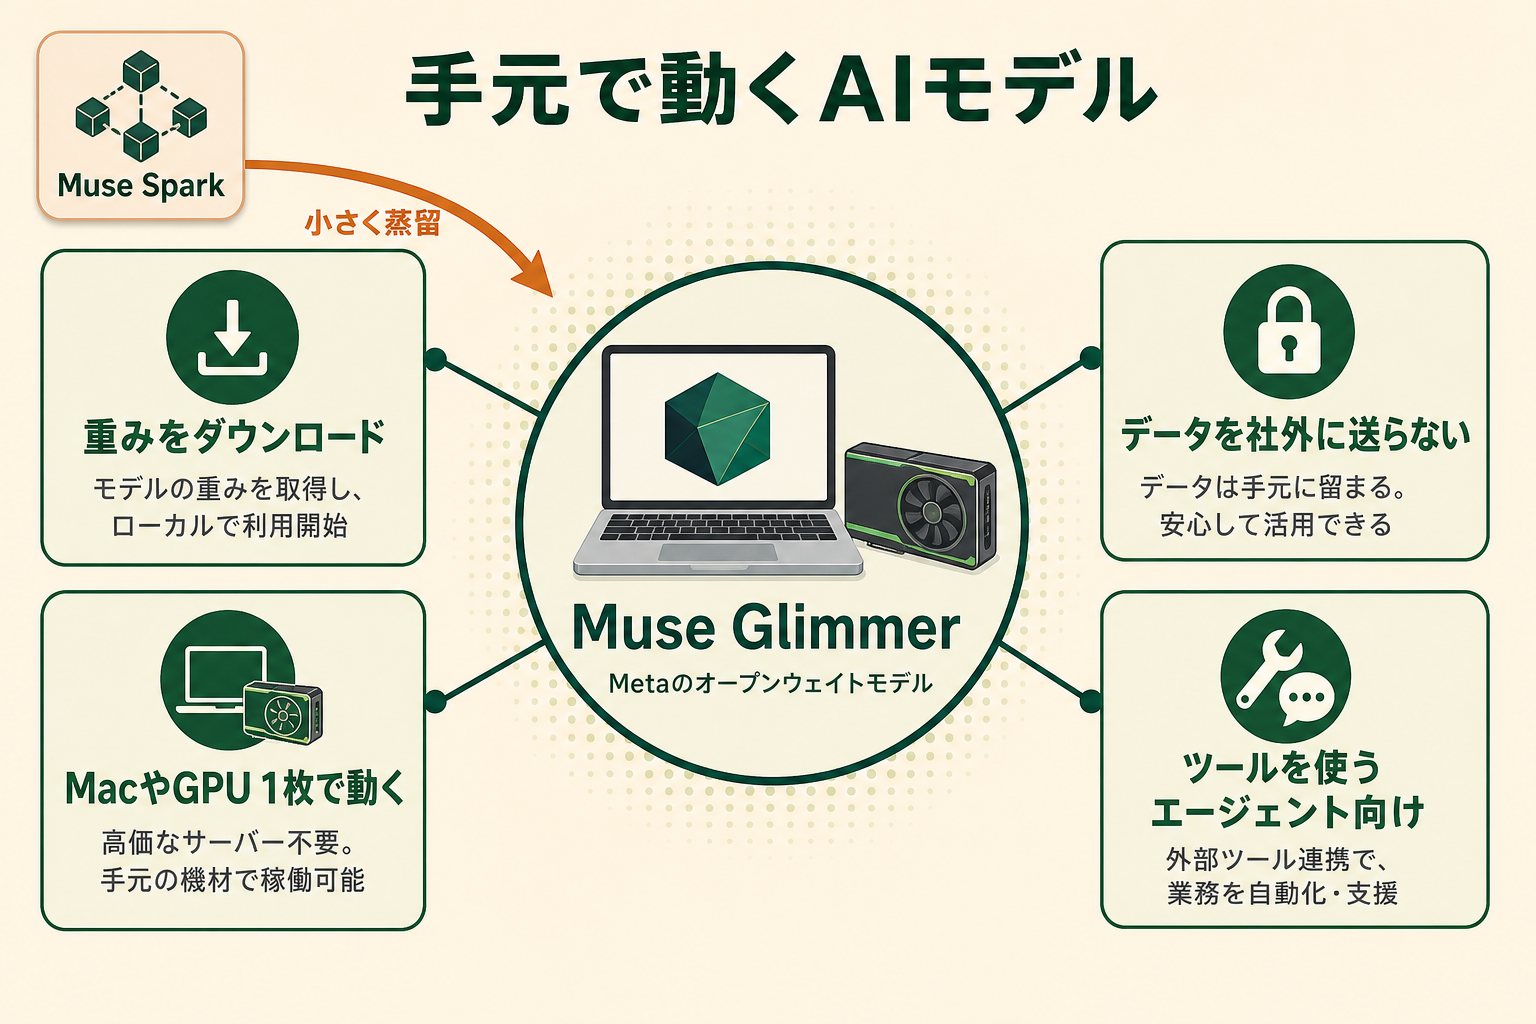
Muse Glimmerとは、Meta Superintelligence Labsが開発し、手元の機材でAIエージェントを動かす用途に絞った300億パラメータの大規模言語モデルです。
大規模言語モデルは、大量の文章から学習して文章を理解・生成するAIの中核部分です。Metaは2026年8月12日(米国時間)に開発者向けブログで公開し、2026年10月20日には学習方法と評価をまとめた技術レポートを出しました。
関連記事:Meta Museとは?できること・料金・日本での利用可否と安全性を解説
重みを配布するオープンウェイトモデル
オープンウェイトとは、学習済みのモデルの重み(AIが学習で身につけた数値の集まり)を誰でもダウンロードできる形で配る公開方法です。Muse Glimmerの重みはHugging Faceで配布されており、自社のパソコンやサーバーに置いて動かせます。
外部のAIサービスに文章を送らずに処理できるため、社外に出しにくい資料を扱う作業でも試しやすくなります。Metaは、ネットワークにつながっていない状態でも動くことを前提に設計したと説明しています。
Muse Sparkを小さくした系列のモデル
Muse Glimmerは、MetaのAIモデル「Muse Spark」から蒸留して作られています。蒸留とは、大きなモデルの振る舞いを小さなモデルに学ばせて、性能を保ちながら軽くする手法です。
Muse Sparkは、MetaのAIエージェント「Meta Muse」の計画と実行を支えるモデルです。Muse Glimmerは、その考え方を手元の機材で動く大きさに収めたモデルと位置づけられます。
主な仕様
Hugging Faceのモデルカードに記載された主な仕様は次のとおりです。
| 項目 | 内容 |
|---|---|
| パラメータ数 | 約296億(画像を読み取る部分を含む) |
| 構造 | すべてのパラメータを毎回使う密結合(Dense)型 |
| 扱える長さ | 131,072トークン以上(既定は128K) |
| 入力 | テキストと画像 |
| 出力 | テキスト |
| 学習言語 | 100を超える言語のデータ |
| 知識の範囲 | 2026年1月4日まで |
| ライセンス | Apache 2.0 |
トークンは、AIが文章を処理するときの単位です。動画はコマ送りの画像として読み込み、音声の入出力には対応していません。
Muse Glimmerの仕組みとできること|ツールの呼び出しと失敗からの立て直し
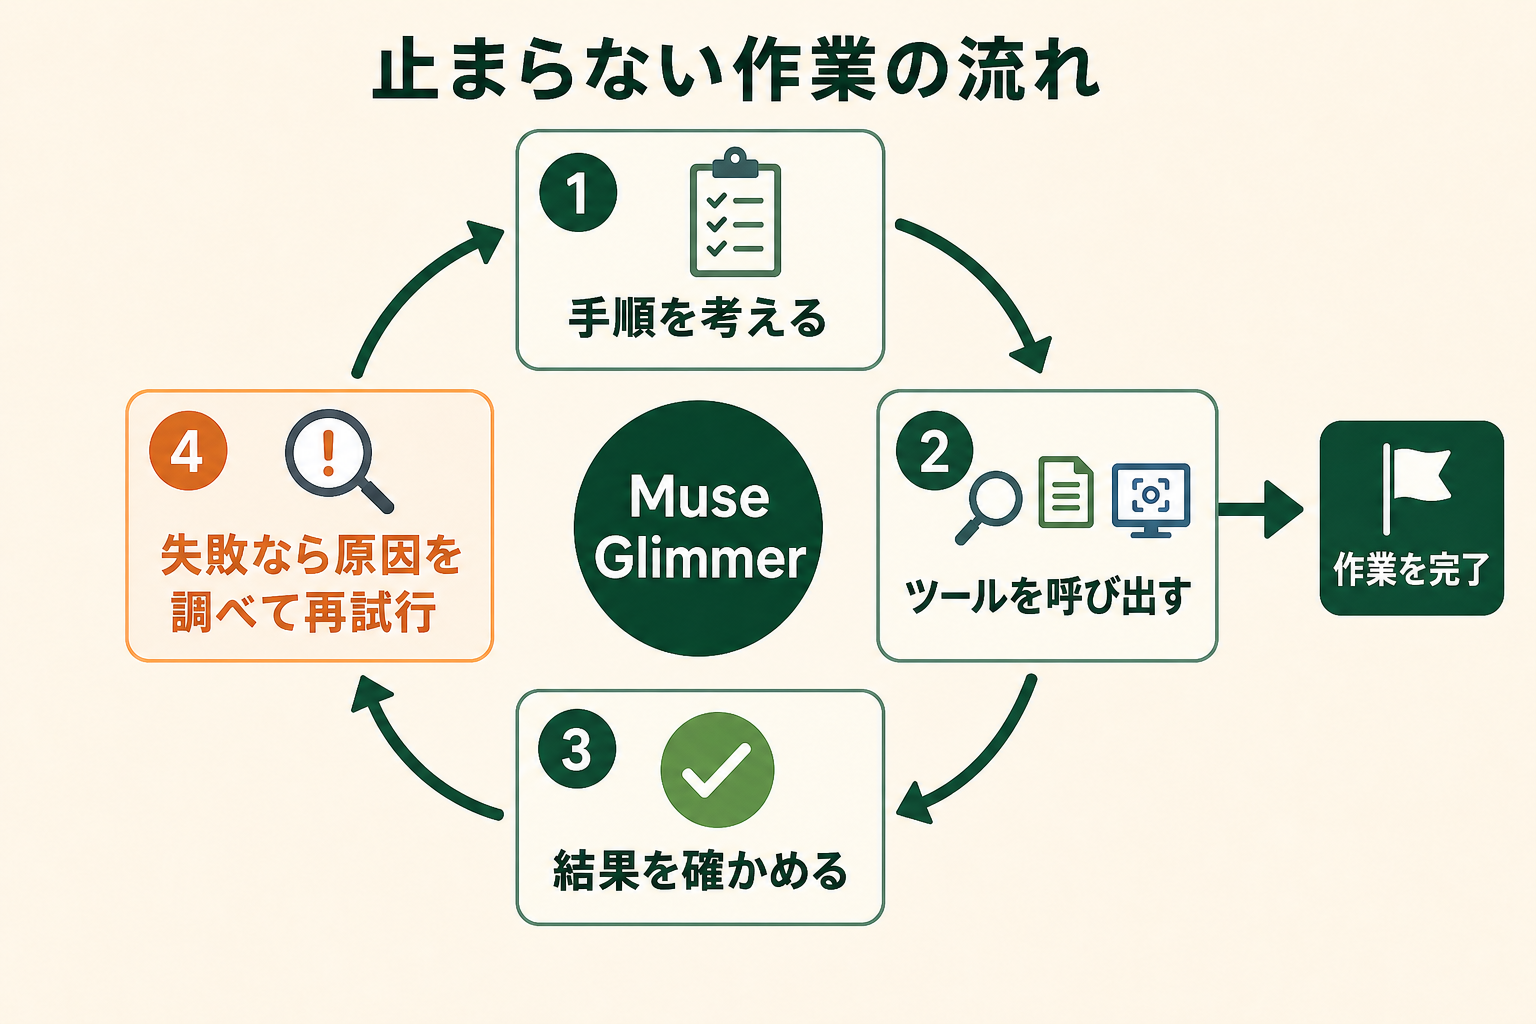
Muse Glimmerは、質問に答えるだけでなく、ツールを順番に呼び出して作業を最後まで進めるAIエージェント向けに学習されています。AIエージェントとは、与えられた目的に向けて手順を考え、外部のツールを使いながら作業を進めるAIのことです。
長い手順でもツールを正しく呼び出す
ツールの呼び出しとは、検索やファイル操作、社内システムの機能などを、決められた形式で指示して実行させることです。Metaは、呼び出しが何十回と続いても形式が崩れにくい点を強みに挙げています。
エージェントは、途中で1回でも呼び出しを誤ると、その後の手順がすべて止まります。Metaの開発者向けブログでは、デモでは動くのに実務では不安定になる原因がここにあると説明しています。
失敗しても止まらずに原因を調べ直す
ツールがエラーを返したり、想定外の結果が出たりしたとき、Muse Glimmerは原因を推測して再試行します。長い作業では途中の失敗は避けられないため、止まらずに立て直せるかどうかが完了率を左右します。
Metaの紹介例では、設定フォルダを丸ごと消す指示に対して、消える内容を説明し、バックアップを提案して確認を待つ動きを示しています。
画面のスクリーンショットや資料を読み取る
画像を読み取る専用の部品(知覚エンコーダー)を持ち、文章と画像をまとめて入力できます。画面のスクリーンショット、グラフ、スキャンした書類を読みながら判断を進められるため、画面を確認しながら操作するエージェントにも使えます。
たとえば、紙の申込書をスキャンした画像から項目を読み取り、社内システムの入力画面のスクリーンショットと照らし合わせて転記先を決める、といった流れを1つのモデルで扱えます。画像1枚あたり最大4,096トークン分の情報として読み込みます。
考える量と生成の速さを調整する
Muse Glimmerは、答える前に自分用の考える過程を書いてから回答する推論型のモデルです。考える量は「reasoning strength」でxhigh・high・medium・lowの4段階から選べ、既定はhighです。複雑な作業やコード作成にはhighかxhighが勧められています。
あわせて、次の文字列の候補をまとめて出す小さな補助モデル「DFlash」が付属しています。本体が候補を確かめて正しい部分だけを採用するため、回答の質を変えずに生成を速くできます。この仕組みを投機的デコーディングと呼びます。
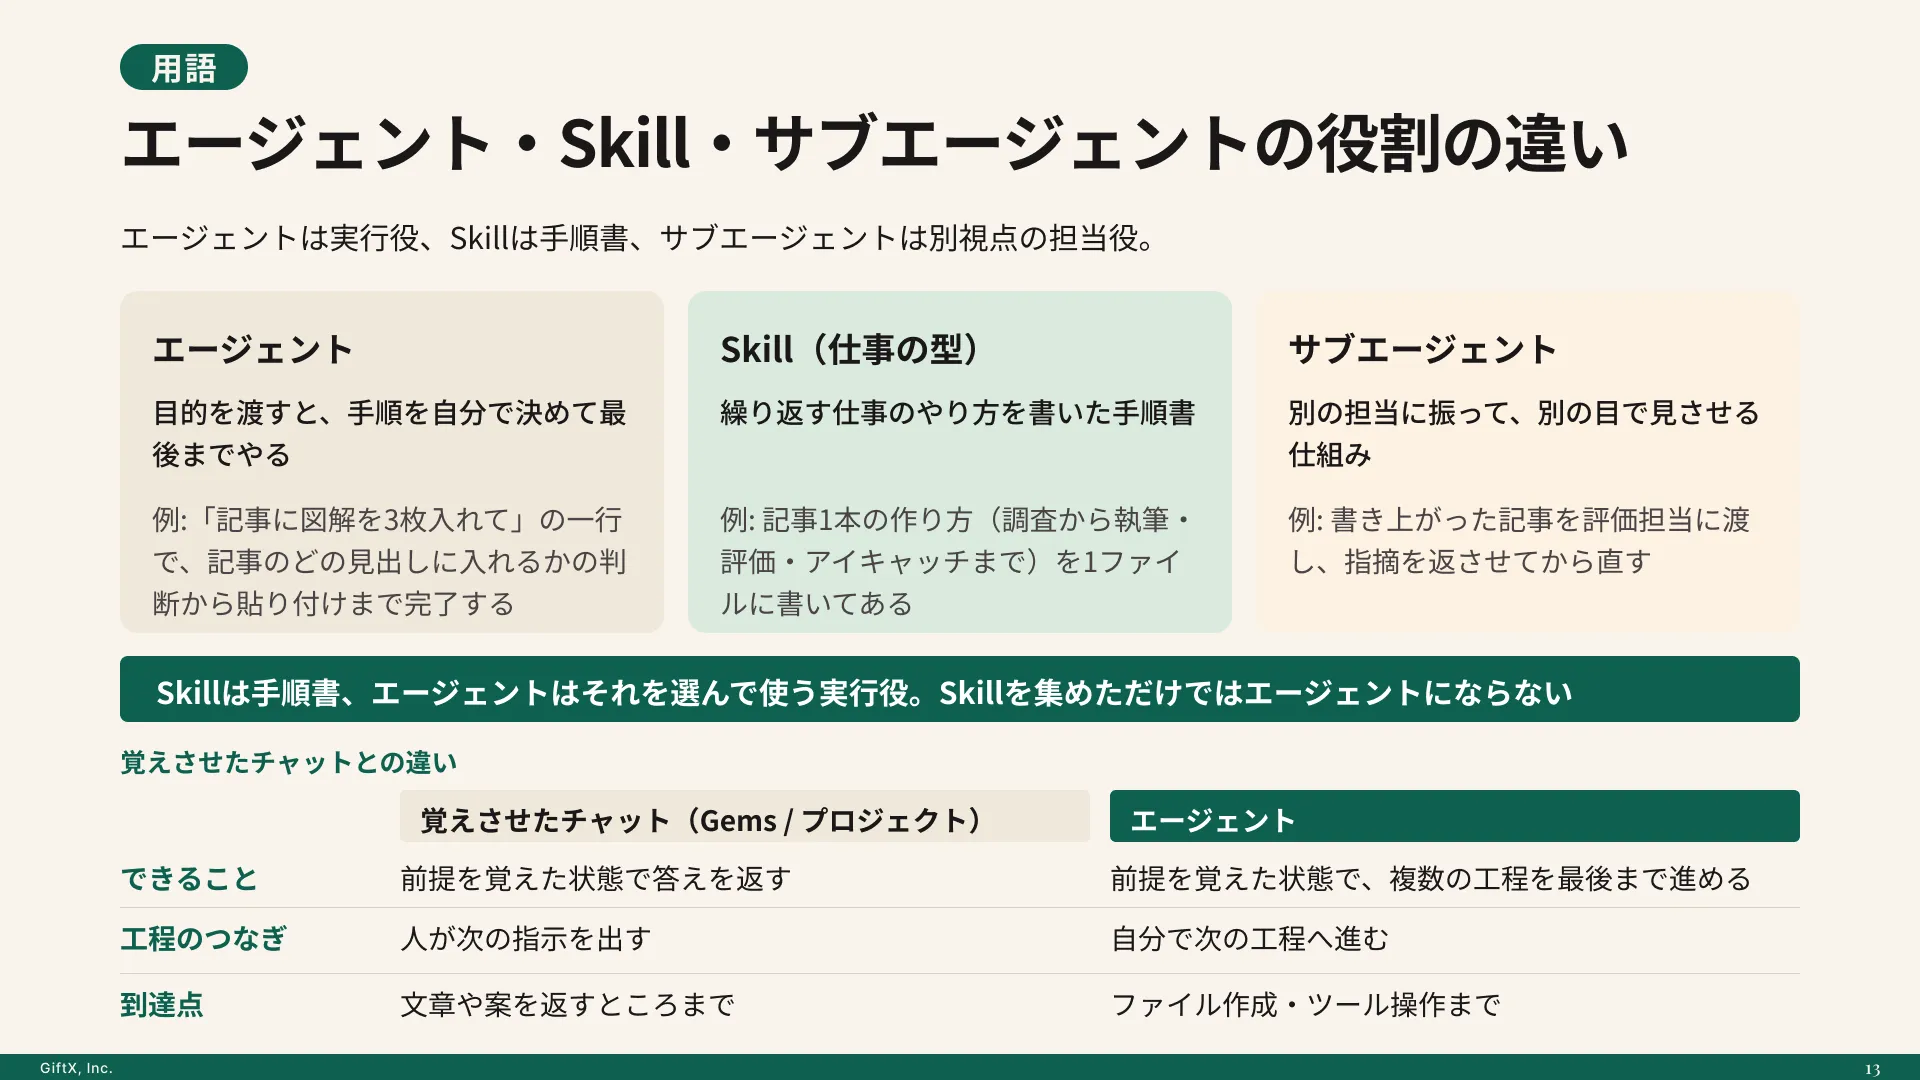
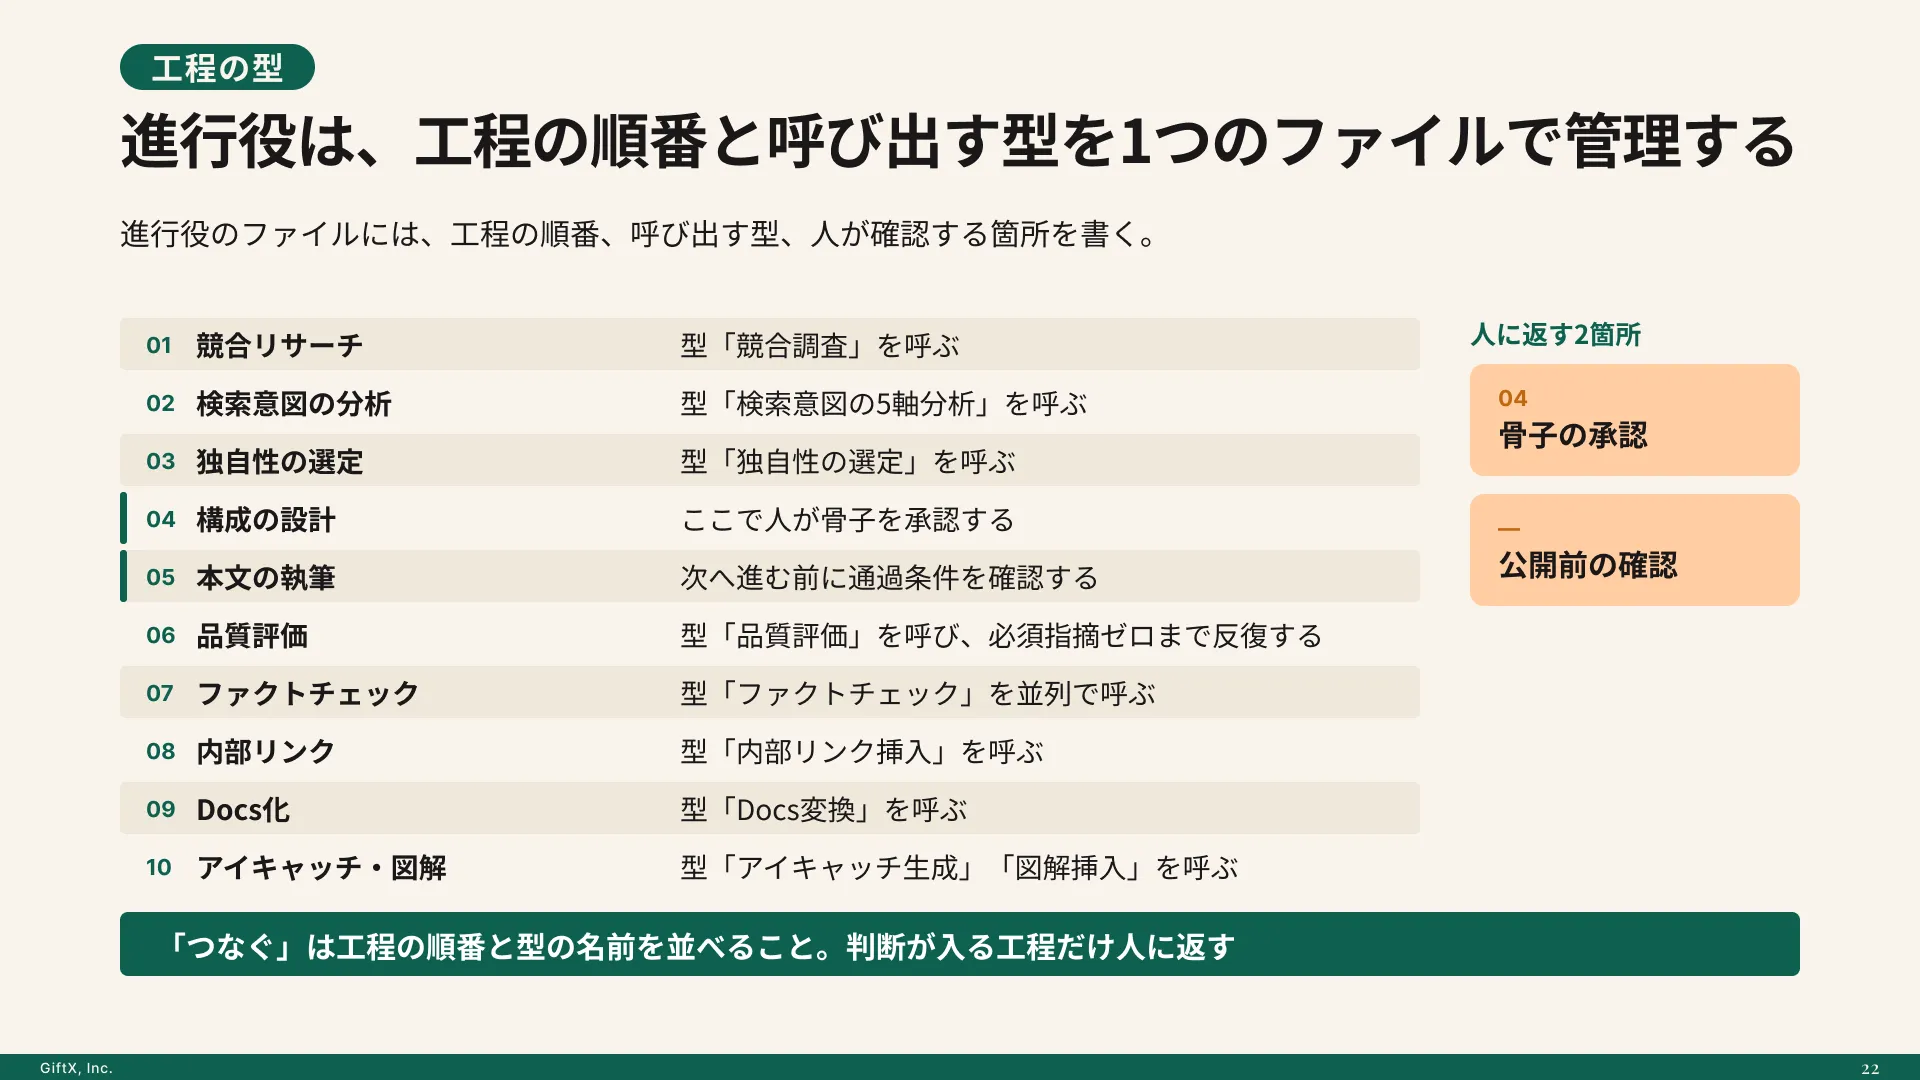
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
Muse Glimmerの性能|Gemma4・Qwen3.6とのベンチマーク比較
Metaの公式発表によると、Muse Glimmerは同じ規模のモデルと比べて、ツールの利用や複数の手順にまたがる計画の作業で高い性能を示しています(出典: ai.meta.com)。比較相手は、GoogleのGemma4-31BとAlibabaのQwen3.6-27Bです。下表はモデルカードの数値から、エージェントの作業に関わる項目を抜き出したものです。数値が大きいほど良い結果です。
| 評価項目 | 測る内容 | Muse Glimmer | Gemma4-31B | Qwen3.6-27B |
|---|---|---|---|---|
| MCP Atlas | ツール連携の作業 | 75.5 | 54.2 | 62.5 |
| DeepSearch QA | 調べて答える作業 | 74.6 | 61.7 | 71.1 |
| SWE-Bench Pro | ソフトウェア修正 | 51.2 | 36.9 | 50.2 |
| OSWorld-Verified | パソコン操作 | 65.9 | 58.5 | 75.6 |
| TerminalBench 2.1 | コマンド操作 | 51.7 | 43.4 | 60.7 |
| AA-LCR | 長い文章の読解 | 80.0 | 68.3 | 73.3 |
ツール連携や調査の作業では他の2モデルを上回る一方、パソコン操作やコマンド操作ではQwen3.6-27Bが上回っています。どの作業でも勝つモデルではないため、任せたい作業に近い項目の数値で比べると判断を誤りにくくなります。
Muse Glimmerの使い方|必要なメモリと動かし方
Muse Glimmerは、重みをダウンロードして自分の機材で動かすのが基本の使い方です。手元で試すならOllamaなどのアプリ、社内の複数人で使うならvLLMなどの推論サーバーを選びます。
必要なメモリの目安
重みを約4ビットまで圧縮する量子化を使うと、言語モデル部分は20GB未満に収まります。量子化とは、モデルの数値を少ない桁で表して、必要なメモリを減らす手法です。モデルカードが示す目安は次のとおりです。
| 版 | 必要なGPUメモリ | 精度の低下 |
|---|---|---|
| 圧縮なし(BF16) | 64GB | なし |
| K-Quant-Dynamic(約4ビット) | 32GB | 平均0.2% |
| K-Quant-17GB | 24GB | 平均1.0% |
GPUメモリ(VRAM)は、画像処理用の部品であるGPUに搭載されたメモリです。Macは本体のメモリをGPUと共有するため、搭載メモリの量で判断します。Metaが速度を測った機材はMacBookのM4 MaxとM5 Max、NVIDIAのRTX 5090です。前掲のモデルカードによると、補助モデルを使うとRTX 5090では毎秒74.9トークンから233.4トークンに速くなりました。
Ollamaで試す
いちばん手軽なのは、パソコンでAIモデルを動かすアプリ「Ollama」です。インストール後に ollama run muse-glimmer を実行すると、約18GBの重みをダウンロードして会話を始められます。Apple Silicon搭載のMacでは、Mac向けに最適化した ollama run muse-glimmer:30b-mlx も用意されています。
Ollamaは、Claude CodeやOpenClawなどのエージェント用ツールからMuse Glimmerを使う起動コマンドも案内しています。たとえば ollama launch openclaw --model muse-glimmer で、Metaが参考実装に選んだOpenClawと組み合わせられます。
関連記事:OpenClawとは?できること・使い方・料金・セキュリティを解説
llama.cppやLM Studioで動かす
llama.cppは、CPUとGPUのどちらでもAIモデルを動かせる推論ソフトです。Metaは量子化したGGUF形式の重みも配布しており、llama.cppや画面から操作できるLM Studioで読み込めます。スマートフォンなどの端末で動かす場合は、端末向けの推論環境ExecuTorchの版を使います。
vLLMやSGLangで社内サーバーにする
社内の複数人やシステムから使うなら、推論サーバーのvLLMやSGLangで起動します。vLLMでは vllm serve "meta-models/Muse-Glimmer-30B" で、OpenAIのAPIと同じ形式で呼び出せる窓口ができます。既存のアプリの接続先を差し替えるだけで試せる点が利点です。
自前で機材を用意する前に試したい場合は、Together AI・Fireworks AI・OpenRouterといった外部の事業者経由でも呼び出せます。この場合は文章が事業者のサーバーに送られる点に注意が必要です。
Muse Glimmerを活用できる業務のケース|社外に出せないデータを扱う作業
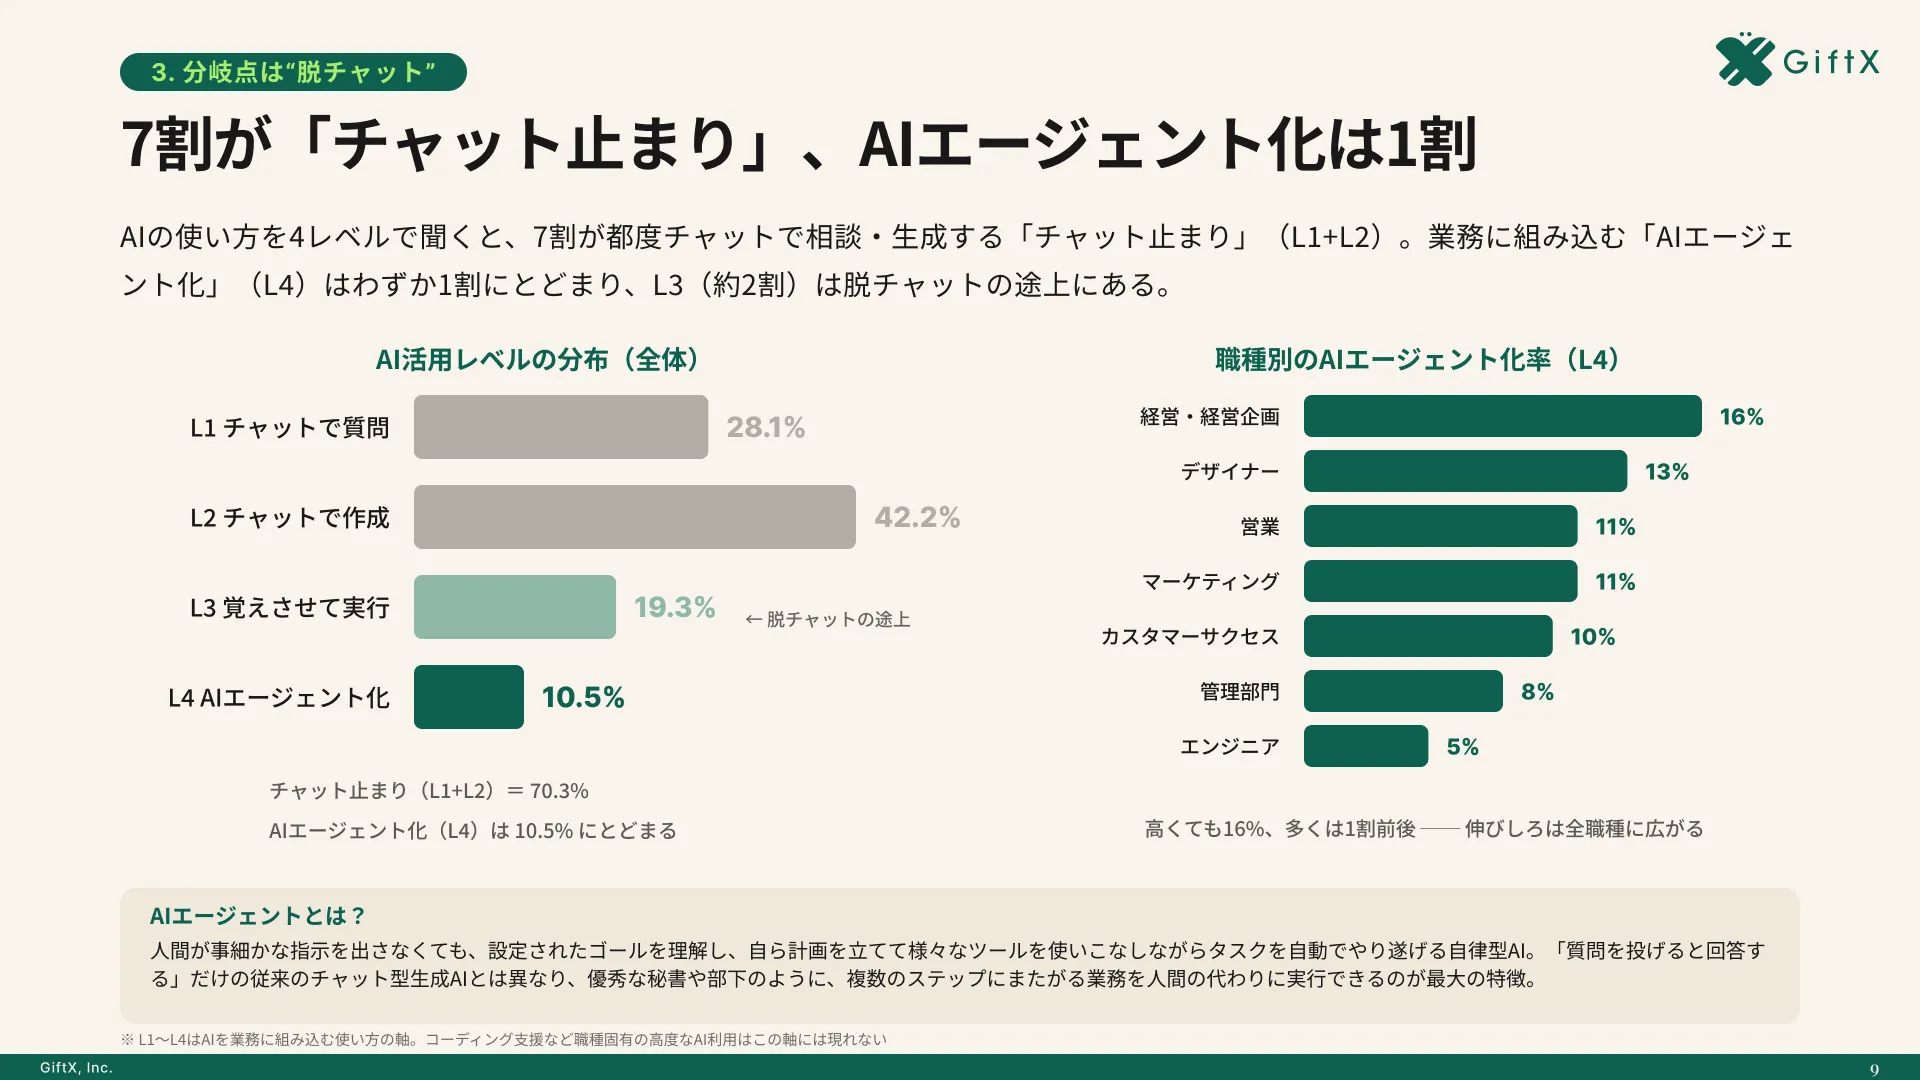
Muse Glimmerが向いているのは、外部のAIサービスにデータを送れないために、AIの活用が止まっている作業です。GiftXがビジネス職のAI利用者を対象に行った調査では、組織の課題として「セキュリティ制限でツールが使えない」が19.6%(複数回答)を占めました。
詳細な調査データは「ビジネス職生成AI活用実態調査(2026年版)」にてご覧ください。
たとえば、規程や議事録、過去の提案書を横断して探せる社内検索のAIチャットのようなケースが考えられます。資料を社外に出さずに済むため、クラウドのAIでは利用が認められなかった文書も対象にしやすくなります。
社内のソースコードを外に出さずに修正する使い方も候補です。ソフトウェアの修正を測るSWE-Bench Proでは51.2と、同規模の2モデルを上回っています。社内のPCで動くコード修正のエージェントとして、外部サービスの利用が認められていない開発チームでも試せます。
いずれの使い方も、まず1つの作業に絞り、正しく終わる割合を測ってから対象を広げます。
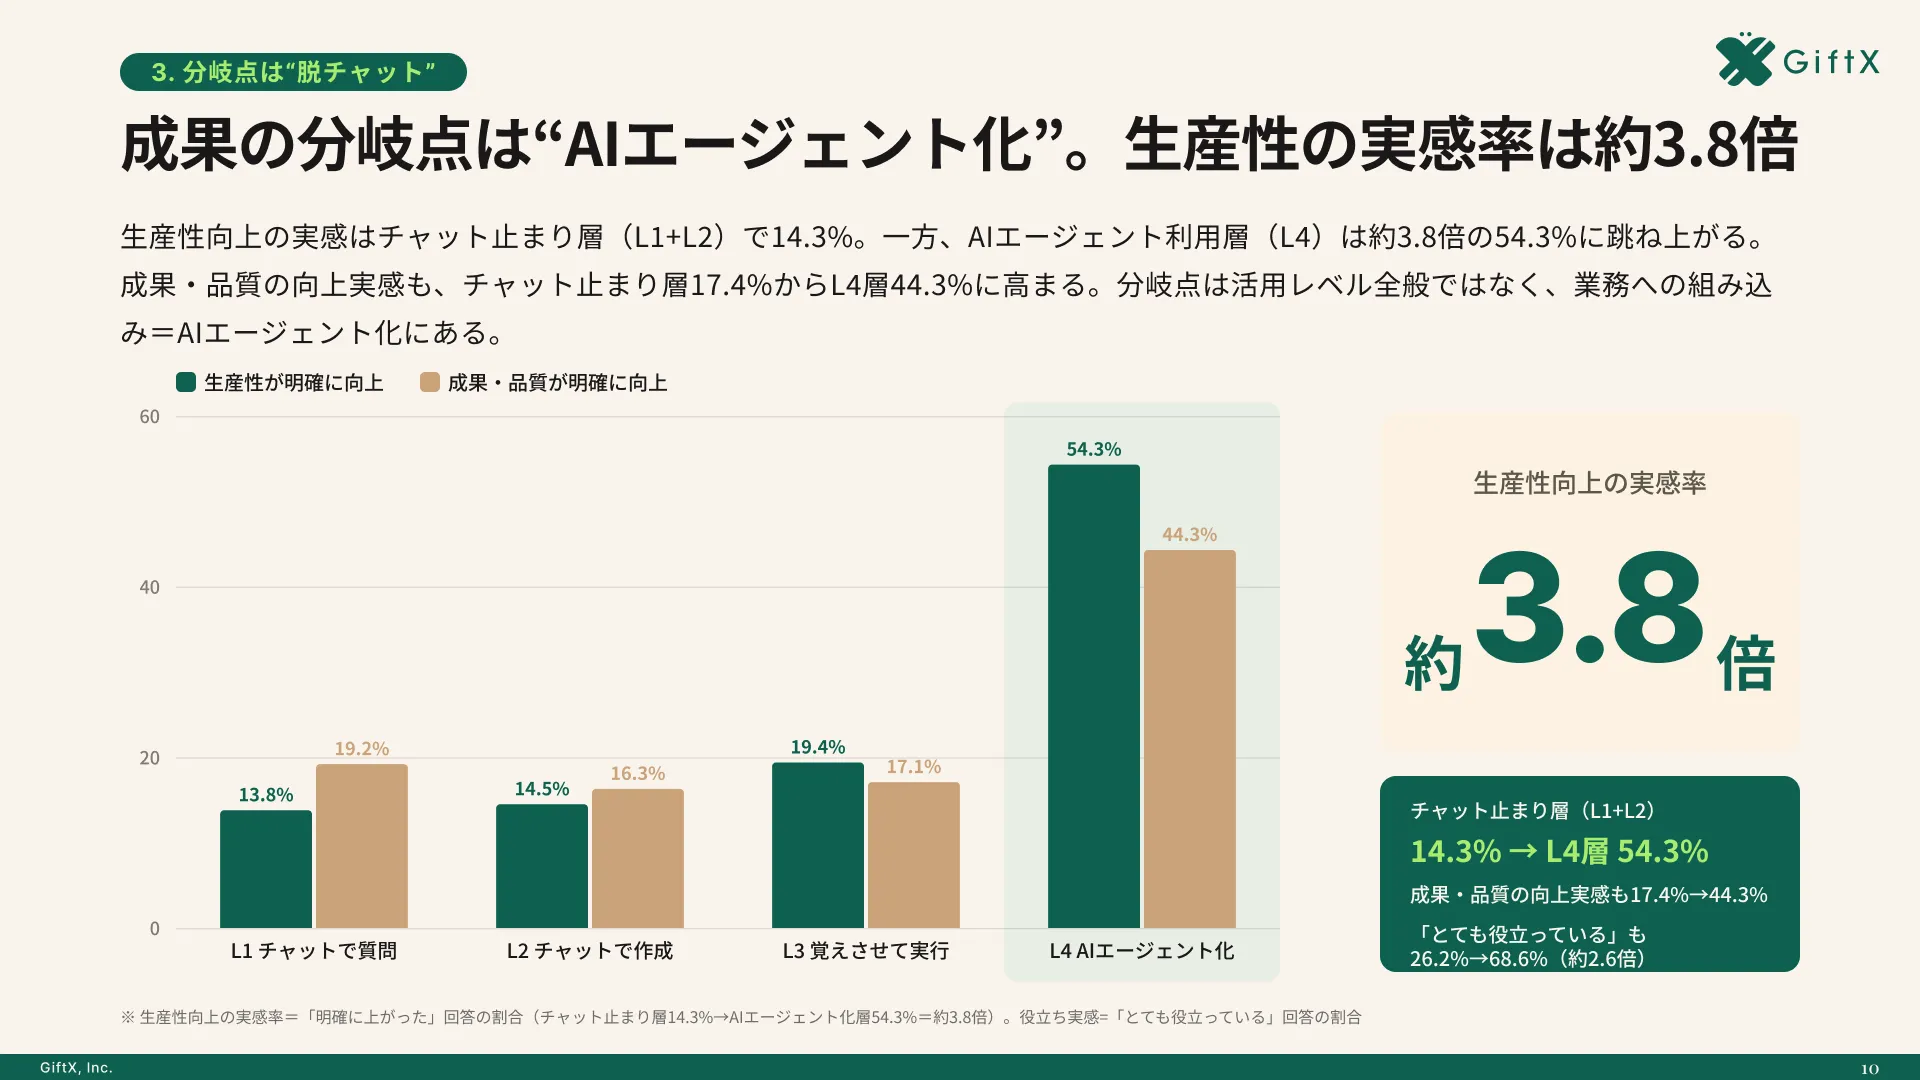
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
Muse GlimmerとMuse Spark Open・Muse SparkのAPIの違いと選び分け
Metaは、Muse Glimmerとは別に、Muse Sparkの重みを公開した「Muse Spark Open」も2026年10月に公開しています。名前が近いものの、規模と必要な機材が大きく異なる別のモデルです。下表では、APIで使うMuse Sparkも含めて並べました。
| 観点 | Muse Glimmer | Muse Spark Open | Muse Spark(API) |
|---|---|---|---|
| 提供形態 | 重みをダウンロード | 重みをダウンロード | MetaのAPIで呼び出す |
| 規模 | 約296億 | 総数8,160億 | ー(APIで利用) |
| 必要な機材 | 24〜32GBのGPU 1枚 | Mac Studio 2台やGPUサーバー | 不要 |
| 入力 | テキスト・画像 | テキスト・画像・動画・音声 | テキスト・画像・動画・PDF |
| ライセンス | Apache 2.0 | Muse Model License | APIの利用規約 |
Muse Spark Openは、4ビットに圧縮しても重みが約537GBあり、一般的なパソコンでは動きません。最大100万トークンの入力や音声・動画を扱いたい場合はMuse Spark Open、手元の1台で常に動かすエージェントにはMuse Glimmerが向いています。機材を持たずに高い性能を使いたい場合は、APIのMuse Sparkが選択肢になります。
関連記事:Muse Spark Openとは?必要な機材と動かし方、商用利用のライセンス条件
Muse Glimmerのライセンス|Apache 2.0で商用利用するときの確認点
Apache 2.0は、商用利用・改変・再配布を認める代表的なオープンソースライセンスです。Metaは、これまでのオープンモデルで最も制限の少ないライセンスだと説明しています。
使える範囲と守る条件
社内業務での利用や、自社製品に組み込んで販売することもできます。再配布する場合は、ライセンス文と著作権表示を同梱し、変更したファイルにはその旨を記します。Muse Spark Openのような「Built with」の表示義務や、売上に応じた別契約の条件はありません。
利用ポリシーと18歳未満の利用
モデルカードでは、法令違反への利用を対象外とし、Metaの利用ポリシーを参照するよう求めています。18歳未満の利用は想定されておらず、未成年が使うサービスに組み込む場合は提供者がリスクを評価する必要があります。
Muse Glimmerを試す前に知っておきたい注意点
手元で動かせる分、性能の確認や安全対策は利用者の側で行う必要があります。
量子化で精度がわずかに下がる
圧縮した版は、まれな入力で圧縮なしの版と結果が変わることがあります。Metaも、自社の作業で確かめてから本番に使うよう勧めています。
日本語の精度は自社の業務で確かめる
100を超える言語のデータで学習していますが、すべての言語で評価したわけではないとMetaは説明しています。日本語の文書を扱う場合は、実際の資料で回答の質を確認します。
操作を任せる範囲を絞る
Metaは、取り消せない操作の前に人が確認する仕組みを組み合わせるよう勧めています。ファイルの削除や外部への送信は、承認を挟む設定にしておきます。
Muse Glimmerに関するよくある質問
Muse Glimmerは無料で使えますか?
重みは無料でダウンロードでき、手元で動かす分にはAPIキーも利用料もかかりません。必要なのは動かす機材と電気代です。外部の事業者経由で使う場合は、各事業者の料金がかかります。
Muse Glimmerは日本語で使えますか?
100を超える言語のデータで学習していますが、Metaは日本語の性能を個別には公表していません。業務で使う前に、実際の資料で試して確認するのが確実です。
MacでMuse Glimmerを動かせますか?
動かせます。Ollamaにはモデルを最適化したMac向けの版があり、MetaもM4 MaxとM5 Max搭載のMacBookで速度を測っています。圧縮版の目安は24〜32GBのメモリです。
Muse Glimmerを使うのにAPIキーは必要ですか?
自分の機材で動かす場合は不要です。外部の事業者のAPIで呼び出す場合だけ、その事業者のAPIキーが必要になります。
Muse Spark Openとどちらを選べばよいですか?
パソコン1台やGPU 1枚で動かしたいならMuse Glimmerです。最大100万トークンの入力や音声・動画を扱いたい場合で、Mac Studio 2台やGPUサーバーを用意できるならMuse Spark Openを検討します。
まとめ
Muse Glimmerは、Metaが公開した300億パラメータのオープンウェイトモデルで、圧縮版なら24〜32GBのメモリを持つGPU 1枚やMacで動きます。ツールの呼び出しと失敗からの立て直しに強く、Apache 2.0で商用利用もできます。
OllamaやvLLMで手軽に試せる一方、日本語の精度や操作を任せる範囲は自社で確かめる必要があります。社内のデータを外に出さずにAIエージェントを動かす段階では、GiftXが1業務単位のAIエージェント構築を伴走支援しています。詳細はAIエージェント構築支援サービスをご覧ください。
社内環境で動かすAIエージェントの構築をご検討の方へ
本記事で紹介したMuse Glimmerのようなモデルを、自社の業務でも具体的に活用したい・相談したいとお考えの方は、ぜひGiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせて1業務単位のスモールスタートから本番運用まで、AIエージェント構築をワンストップで支援します。ユースケースの洗い出しから、PoC、本番運用、社内ナレッジ化まで伴走します。
AI活用にご関心のある方は、ぜひ一度ご相談ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら