オンプレミスLLMとは?クラウド型LLMとの違いを一言で
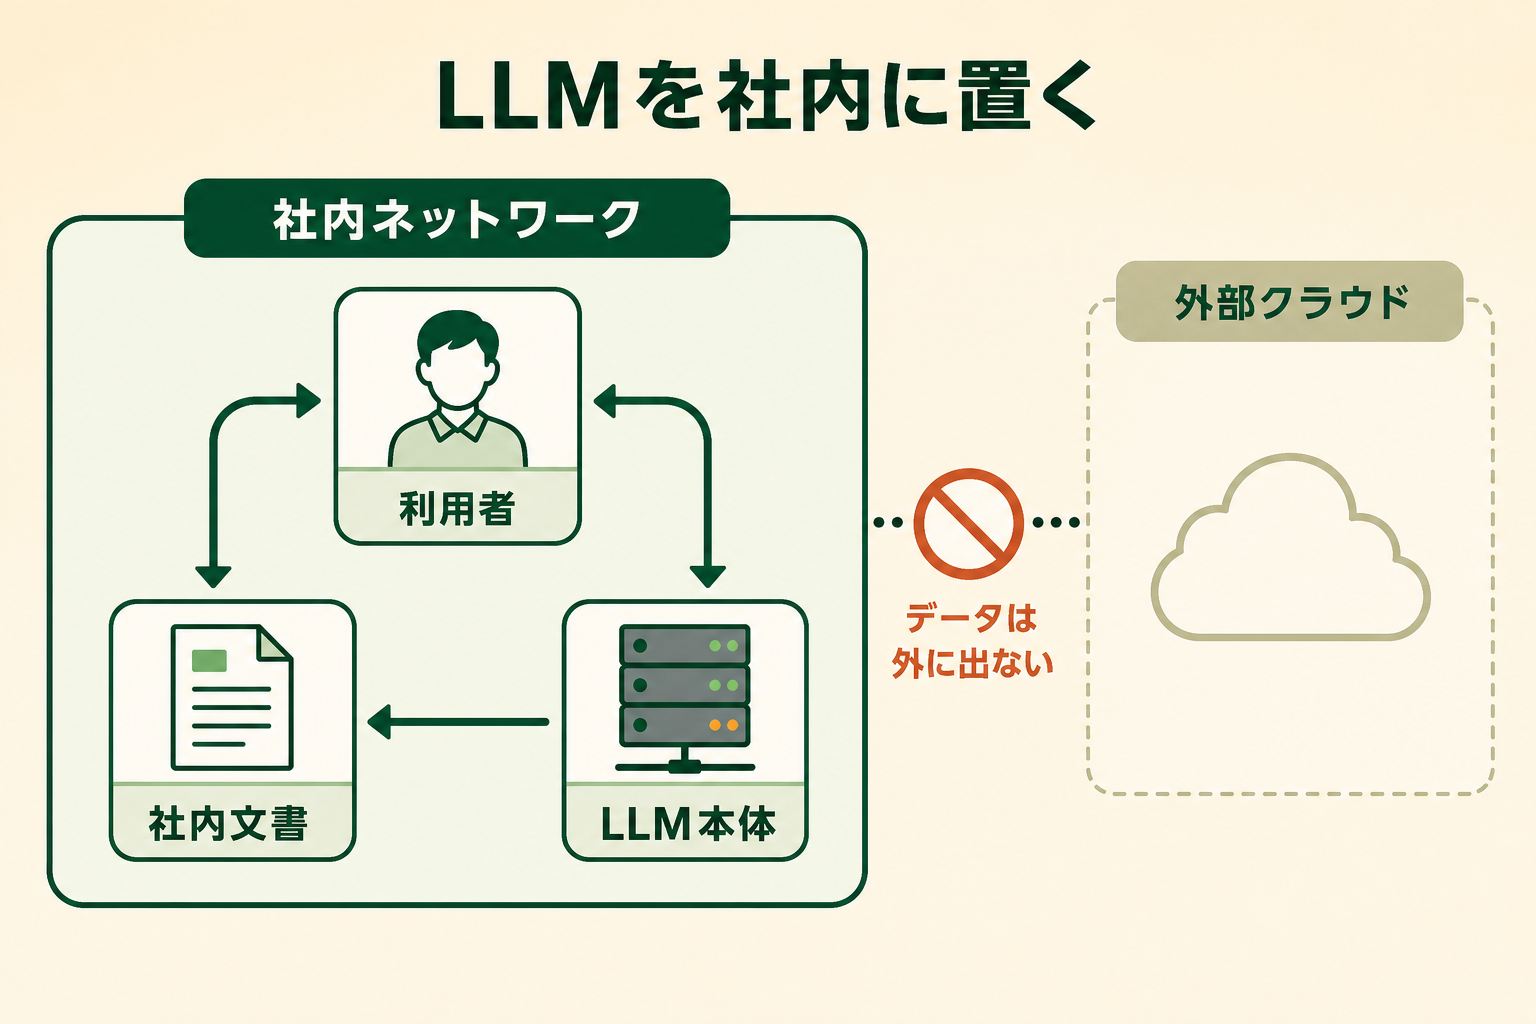
オンプレミスLLMとは、自社が管理するサーバーの中で大規模言語モデルを動かす方式です。
LLM(Large Language Model、大量の文章を学習して人の言葉を扱えるようにしたモデル)は、通常ベンダーのクラウドサービスにAPI経由で問い合わせて使います。この場合、質問文や添付した文書は社外のサーバーへ送信されます。オンプレミスLLMはこの流れを変え、モデル本体を自社のデータセンターやサーバールームに置いて、社内ネットワークの中だけで推論を完結させます。
成立の前提になっているのが、オープンモデル(重みが公開され、自社環境へ配置して動かせるモデル)の性能向上です。以前は最先端のクラウドモデルとの差が大きく、自社に置く選択肢が現実味を持ちませんでした。現在は中規模のオープンモデルでも多くの業務で必要な品質に届くようになり、機密性の高い領域から順に自社環境へ寄せる構成が採れるようになっています。
「オンプレミス」が指しているのは設備の置き場所です
オンプレミスは、システムを動かす設備を自社が所有・管理する形態を指す言葉です。サーバーが自社ビルの中にあるか、データセンターの自社専用ラックにあるかは問いません。判断の軸は物理的な距離ではなく、その設備の管理権限を自社が持っているかどうかです。
LLMの文脈でこの言葉が使われるとき、実務上の意味は「推論のためのデータが社外へ出ない」ことに集約されます。ソースコード、設計図、患者情報、審査中の契約書といった、外部送信そのものが規程で禁じられている情報を扱えるかどうかが分かれ目になります。オンプレミスLLMが解こうとしているのはこの一点です。
ローカルLLMとの違いは、個人のPCか企業のサーバーか
オンプレミスLLMとよく併記されるのがローカルLLMです。両者は「自分の管理下でモデルを動かす」という点で同じですが、想定している規模と利用者が異なります。
ローカルLLMは、個人のPCやワークステーションでモデルを動かす使い方を指すことが多い言葉です。手元で試す、1人で使う、といった範囲が中心になります。一方のオンプレミスLLMは、部署や全社の複数人が同時に使う前提で、認証・ログ・可用性まで含めた業務システムとして構築します。同時に何人が使うのか、落ちたときに誰が復旧するのかを設計に含めるかどうかが分かれ目です。
プライベートクラウドとの違いは、設備を誰が所有するか
似た選択肢にプライベートクラウドがあります。クラウド事業者の設備の一部を専有し、他社と共有しない形で使う構成です。データが他社と混ざらない点はオンプレミスと共通しますが、設備そのものは事業者の所有物で、契約が続く限りにおいて専有できる関係にあります。
自社の規程が「他社と共有しないこと」までを求めているのか、「自社の管理下にあること」までを求めているのかで、選ぶべき構成は変わります。規程の文言を読み直すと、プライベートクラウドで足りるケースは少なくありません。オンプレミスは選択肢の中で最も自由度が高い代わりに、設備の調達と運用も自社で持つことになります。
オンプレミスLLMとクラウドLLM・ローカルLLMの違い
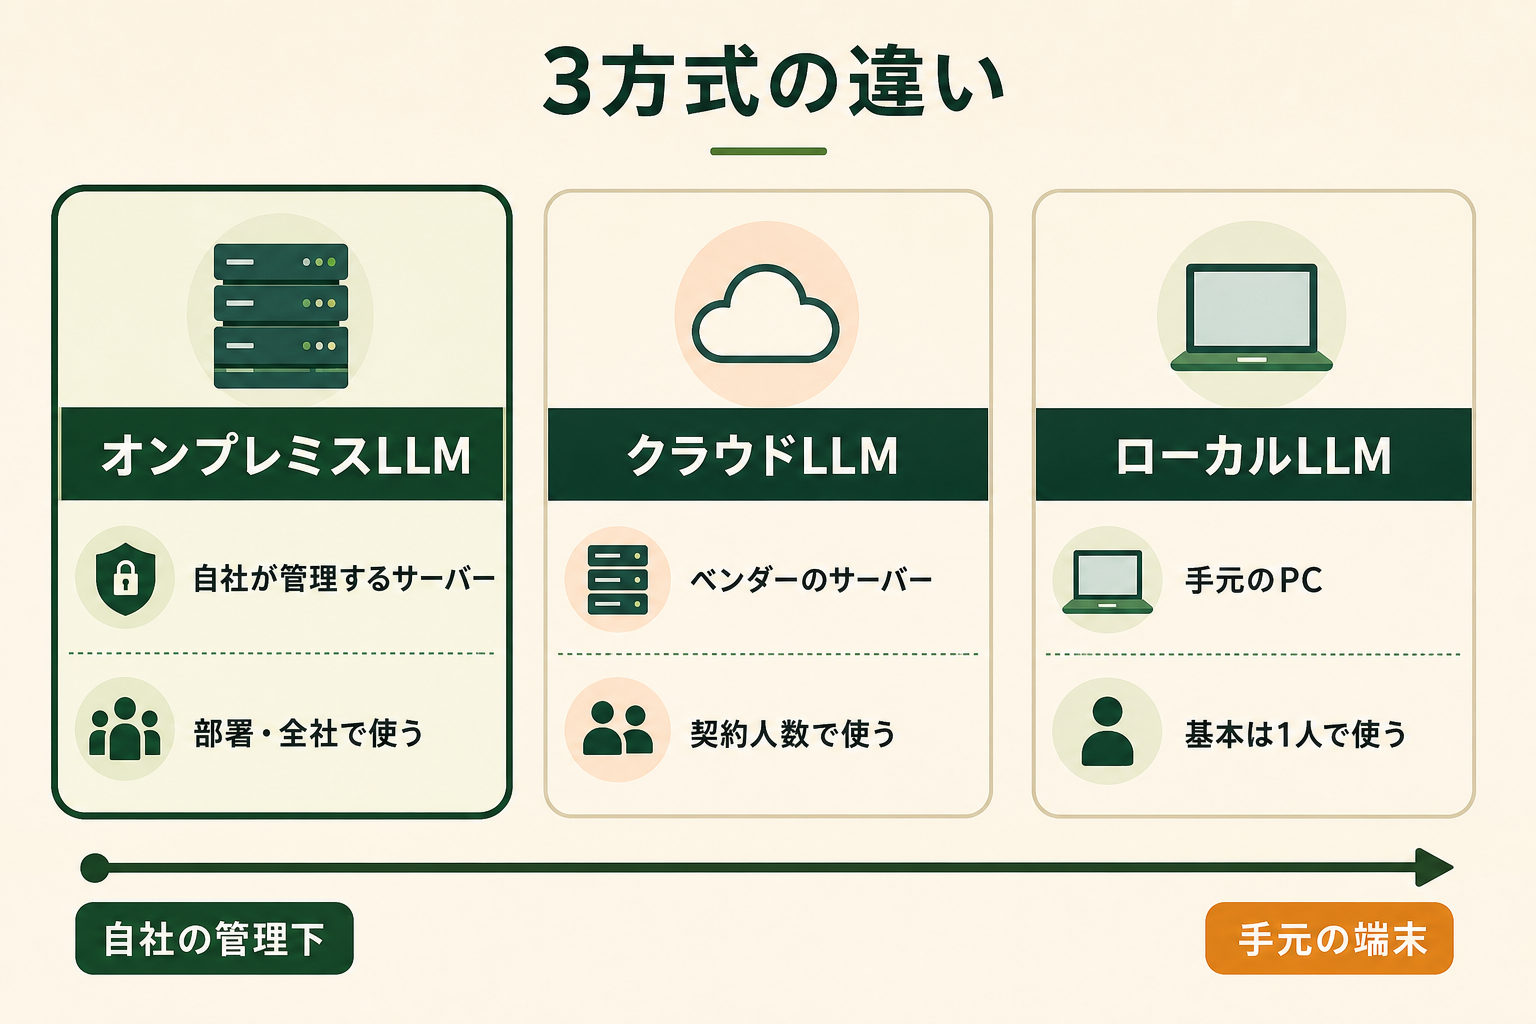
3つの方式は、データの置き場所だけでなく、費用のかかり方とモデルの選び方まで性質が異なります。下表は、導入判断で見るべき7つの観点で3者を整理したものです。自社にとってどの観点が譲れないかを先に決めてから、表を上から当てはめると判断が速くなります。
| 観点 | オンプレミスLLM | クラウドLLM | ローカルLLM |
|---|---|---|---|
| データの送信先 | 自社ネットワーク内で完結 | ベンダーのサーバーへ送信 | 手元の端末内で完結 |
| 初期費用 | GPUサーバーの調達費が発生 | ほぼ不要 | 端末のスペック増強分 |
| 継続費用 | 電力・保守・運用人件費(利用量に比例しない) | 利用量に応じた従量課金 | ほぼ不要 |
| 使えるモデル | オープンモデルから選択 | ベンダーが提供するモデル | オープンモデルから選択 |
| モデルの更新 | 自社の判断とタイミングで実施 | ベンダーの提供終了に追随 | 自分の判断で実施 |
| 同時利用 | 部署・全社規模を想定した設計が可能 | 契約人数に応じて拡張 | 基本的に1人 |
| 向く用途 | 機密情報を扱う定常業務 | 幅広い業務の立ち上げ | 検証・個人の試用 |
表で最も差が出るのは費用の性質です。クラウドLLMは使った分だけ支払う従量制で、利用が増えるほど月額も伸びます。オンプレミスLLMは先に設備を用意する代わりに、その後の費用は利用量に比例しません。例えば全社で毎日使う定型業務に載せる場合、従量課金では読みにくかった年間費用が予算化しやすくなります。逆に、使うかどうかがまだ分からない段階では、初期費用が回収できないまま設備だけが残ります。
見落とされやすいのが「モデルの更新」の行です。クラウドLLMでは、ベンダーが旧モデルの提供を終了すると利用者は後継モデルへ移らざるを得ません。出力の傾向が変わるため、業務に組み込んだプロンプトや後段の処理を検証し直す作業が、こちらの都合と関係なく発生します。オンプレミスLLMでは、一度動かし始めたモデルを自社の判断で使い続けられます。数年単位で運用する業務ほど、この差は実務の負荷として表れます。
一方で、更新しない限り性能が上がらないのも同じ構造です。新しいモデルの恩恵は自動的には入ってきません。
なぜいまオンプレミスLLMが検討されるのか
きっかけは各社の内部にあります。GiftXが実施したビジネス職の生成AI活用実態調査では、組織側の課題として「セキュリティ制限でツールが使えない」が19.6%で3位に挙がりました(複数回答)。使いたい人がいて、使える業務もあるのに、送信の可否を決められずに止まっている状態が一定数あるということです。
供給側の動きも重なっています。2026年9月9日には、PKSHA Technologyが国産LLMを含むオープンモデルを企業のオンプレミス環境で動かすAIエージェント「PKSHA Private AI Agents」の提供を開始しました。同社は、機密性の高い業務でクラウド経由の生成AI利用が制限される状況を背景に挙げ、ソースコードや設計情報を外部に出せない開発現場を主な想定利用シーンとしています(出典: prtimes.jp)。
自前でサーバーを組む以外に、製品として導入する経路が増えつつあります。
詳細な調査データは「ビジネス職生成AI活用実態調査(2026年版)」にてご覧ください。
関連記事:生成AIで気をつけるセキュリティとは?主要リスクと企業がとるべき対策を解説
オンプレミスLLMでできること|4つの代表ユースケース
オンプレミスにすると何ができるようになるのかは、「クラウドに送れなかった情報を扱える」という一点から派生します。ここでは、外部送信の制約が特に強く、かつ効果が出やすい4つの使い方を挙げます。
ユースケース1: 社内文書を横断検索して答えさせる
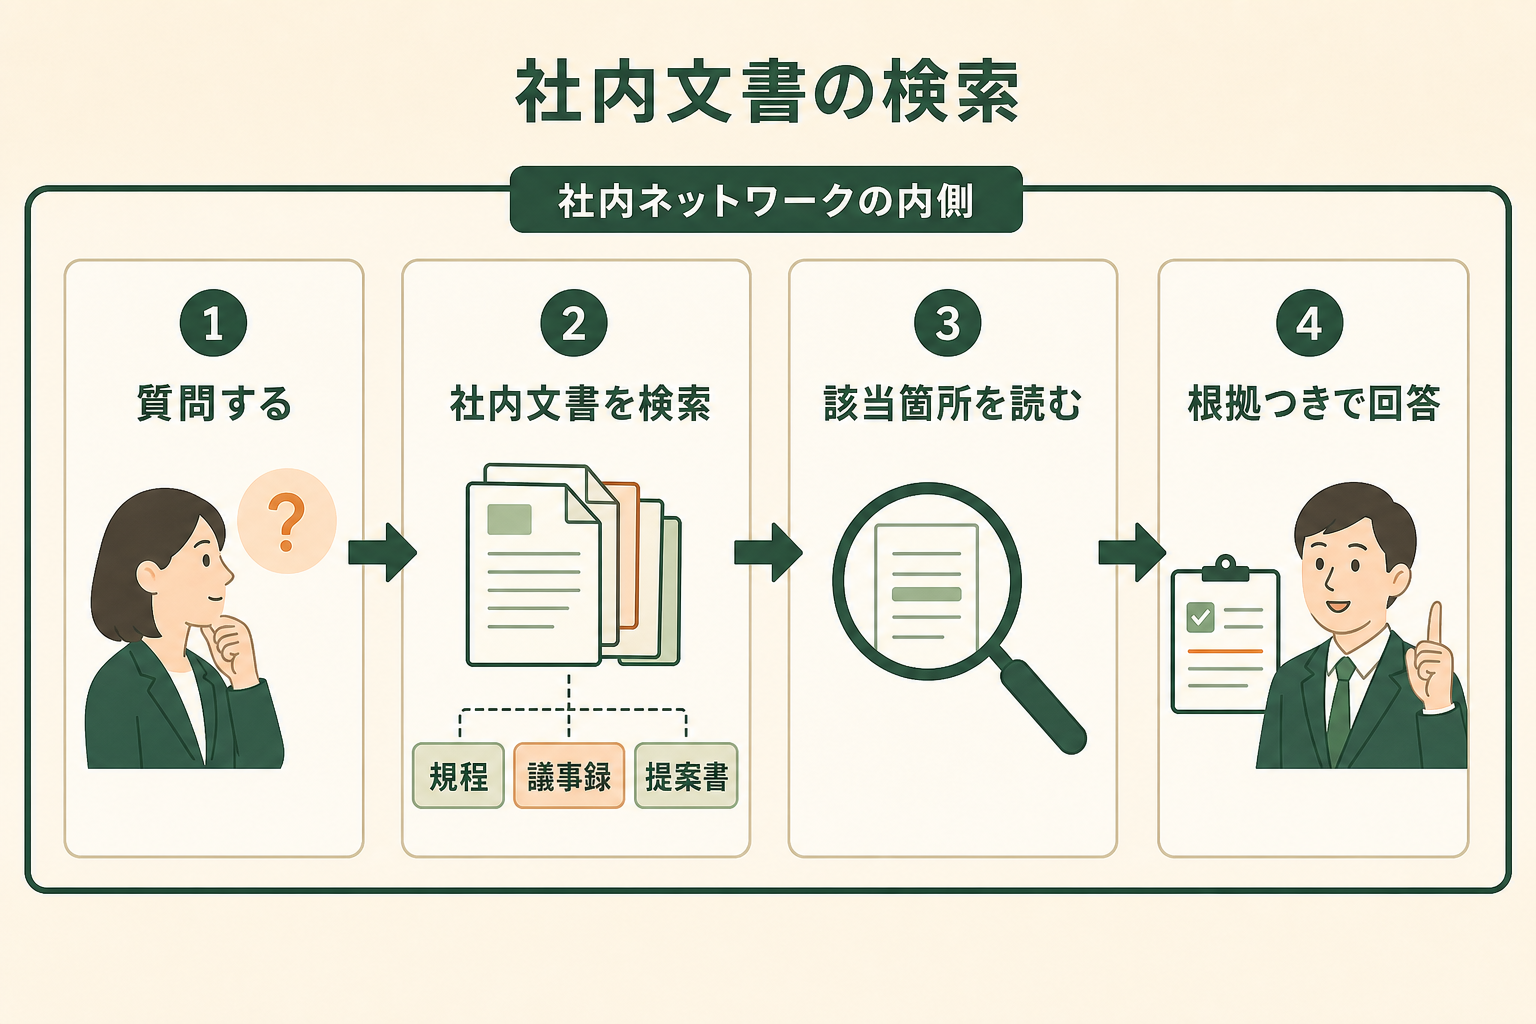
規程、議事録、過去の提案書、設計基準書といった社内ドキュメントを検索対象にして、質問に対して該当箇所と要約を返す使い方です。RAG(Retrieval-Augmented Generation、外部の文書を検索して回答に取り込む手法)と呼ばれる構成で実現します。
探し物にかかる時間は、担当者の記憶とフォルダ構成に依存します。例えば資料を1回探すのに15分かかっていたところが1分程度まで縮み、見つからずに作り直していた重複も減る、といったケースが考えられます。この領域は文書そのものを検索対象に載せるため、外部送信の制約と最も強くぶつかります。
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
ユースケース2: ソースコードや設計情報を扱う開発支援
コード補完、レビュー、テストの生成といった開発支援は、扱う対象がそのまま自社の資産になります。クラウド型のコーディング支援を検討したものの、リポジトリの内容を送信できないという理由で見送った、という判断は多くの現場で起きています。
オンプレミスに置くと、自社のコーディング規約やレビュー観点をモデルに読み込ませたうえで生成させられます。長期にわたって保守される大規模なコードベースを抱える領域ほど、既存の書き方に沿った出力が返ることの価値が大きくなります。
関連記事:開発の生成AI活用事例 | 設計・プログラミング・テストでの利用事例
ユースケース3: 個人情報を含む問い合わせの一次対応
氏名や連絡先、契約内容を含む問い合わせ内容を参照しながら、回答の下書きを作らせる使い方です。過去の対応履歴とFAQを合わせて参照させると、担当者ごとに揺れていた文面のトーンも揃います。
この用途では、個人情報を外部へ送らないことが前提条件になります。同意の取得や委託先の管理といった手続きを積み上げるより、そもそも社外に出さない構成にするほうが早い、という判断が成り立ちます。
ユースケース4: 閉域ネットワーク内の設備・製造データの分析
外部ネットワークと接続していない環境で、稼働ログや検査データを扱う使い方です。閉域ネットワーク(外部と物理的・論理的に切り離されたネットワーク)では、そもそもクラウドAPIへ到達できないため、選択肢はオンプレミス一択になります。
この領域は「クラウドと比べてどうか」ではなく「AIを使えるか使えないか」の分かれ目になります。制約が最も強い分、導入したときの差も大きく出ます。
オンプレミスLLMの費用|GPUサーバー構成と初期投資の目安
費用の話は、金額そのものより先に「何が費用を決めているか」を押さえたほうが見積もりを取りやすくなります。オンプレミスLLMの初期費用を決めるのは、動かすモデルの規模と、そこから逆算される必要なGPUメモリの量です。
モデルの大きさはパラメータ数で表され、必要なGPUメモリはおおむねパラメータ数に比例します。ここで効いてくるのが量子化(モデル内部の数値表現を圧縮して軽くする技術)で、精度をある程度保ったまま必要なメモリを大きく減らせます。下表は、量子化を適用した場合のモデル規模と構成の対応関係です。
| モデル規模 | パラメータ数の目安 | 必要なGPUメモリ(4bit量子化時) | GPU構成の例 | 主な用途 |
|---|---|---|---|---|
| 小規模 | 7〜8B | 約6〜8GB | 24GBクラス1枚 | 分類・要約・定型文の生成 |
| 中規模 | 14〜32B | 約10〜20GB | 48GBクラス1枚 | 社内文書の検索・回答、下書き生成 |
| 大規模 | 70B前後 | 約40GB | 48GBクラス2枚または80GBクラス1枚 | 長文の読解、コード生成 |
多くの業務は中規模で足ります。最先端の大規模モデルを前提に見積もると構成が跳ね上がりますが、社内文書の検索や下書き生成といった用途では、中規模モデルで必要な品質に届くことが増えています。
応答速度の面でも、限られたGPUで実用的な速度を出す技術が進んでいます。投機的デコーディング(Speculative Decoding、応答の続きを軽いモデルで先読みして本体のモデルが検証する手法)と量子化を組み合わせると、同じ構成でも待ち時間を短縮できます。オンプレミスは応答が遅いという前提は、以前ほど当てはまらなくなりました。
初期費用のほかに、継続的にかかる費用があります。サーバー本体の見積もりだけを社内に提示すると、稼働後に想定外の負担が出ます。
- 電力と空調: GPUサーバーは消費電力が大きく、設置場所の電源容量と冷却能力が足りるかを事前に確認します
- 保守契約: 故障時の交換対応をどこまでカバーするか、ハードウェアの保守年数をどう設定するか
- 運用の人件費: 監視、障害の一次対応、モデルの入れ替え判断にかかる工数
- 検証環境: 本番と別に、モデル更新を試す環境を持つかどうか
この4つは初期費用と違って毎年かかります。クラウドLLMとの比較を社内でする際は、初期費用だけを並べると実態を映しません。想定する利用年数(3年か5年か)を先に決めて、その期間の総額で比べると議論がかみ合います。
関連記事:AI導入にかかる費用の相場は?3つのパターンと主要ツール料金を整理
導入・構築の進め方|5つのステップ
オンプレミスLLMの構築は、サーバーを買ってから考え始めると手戻りが大きくなります。載せる業務を先に決め、そこから必要な構成を逆算する順序で進めます。
ステップ1: クラウドを使えない理由を3つに切り分ける
最初にやることは、機材の検討ではなく制約の棚卸しです。「クラウドが使えない」と一言で語られている状態を、次の3つに分解します。
- 通信経路の問題: 外部ネットワークへ到達できない、または接続が許可されていない
- 学習利用の問題: 入力したデータがモデルの学習に使われることを規程が禁じている
- 保管場所の問題: データが国外や他社設備に保管されることを規程が禁じている
この切り分けが要るのは、2番目と3番目は契約や設定で解決できる場合があるからです。学習利用を行わない契約プランや、保管リージョンを指定できるサービスは既に提供されています。オンプレミスが本当に必要になるのは、1番目に該当する場合と、規程が「自社の管理下にあること」まで求めている場合です。ここを飛ばすと、契約の見直しで済んだはずの案件にサーバーを買うことになります。
関連記事:生成AIの社内ルールを作るテンプレート|公開ひな形の入手先と書き換える4条項
ステップ2: 最初に載せる1業務を決める
制約を確認したら、次は対象業務を1つに絞ります。全社の生成AI基盤として設計を始めると、要件が発散して構成が決まりません。
選ぶ基準は3つあります。1つ目は、外部送信の制約が実際に効いている業務であること。制約がない業務から始めると、オンプレミスにする理由が説明できません。2つ目は、対象となる文書やデータが既に電子化され、どこにあるか分かっていること。3つ目は、成果を測れることです。1回あたりの所要時間や処理件数など、導入前の数字が取れる業務を選びます。
ステップ3: モデルを選定して品質を検証する
載せる業務が決まると、必要な品質の水準が決まります。ここで初めてモデルの選定に入ります。
検証で見るのは、汎用のベンチマークの点数ではなく、自社の実データで期待どおりの出力が返るかどうかです。実際の文書を20〜30件用意して、複数のモデルに同じ質問を投げ、出力を並べて比較します。日本語での読解や敬語の扱いに差が出る場面では、国産のオープンモデルが選択肢に入ります。この段階ではまだ本番用のサーバーを用意する必要はなく、クラウド上のGPUを時間借りして検証する進め方が一般的です。
ステップ4: 推論基盤とサーバー構成を決める
モデルが決まると、必要なGPUメモリが決まります。ここに同時利用者数と許容できる応答時間を掛け合わせて、サーバー構成を確定させます。
推論基盤は、モデルを動かして複数のリクエストをさばくソフトウェアの層です。複数人が同時に使う前提では、リクエストをまとめて処理する仕組みや、待ち行列の管理が必要になります。ここを自前で組むか、既製の基盤を使うか、製品として導入するかで、必要な人員と期間が変わります。
自前で組む場合は、推論の高速化やGPUメモリの配分まで自社で調整することになり、その分の知見が社内に要ります。近年は、この層をあらかじめ組み込んだオンプレミス型の製品も出てきており、モデルの選定と自社データの接続だけに集中できる構成を選べます。自社にGPUやインフラの専門人材がいない場合は、この層を外部に任せる前提で計画を立てるほうが現実に沿います。
ステップ5: 社内データを接続して運用に乗せる
最後に、社内文書やデータベースをモデルにつなぎます。RAGを使う場合は、対象文書を検索できる形に変換して保存する工程が入ります。
ここで決めておくことが2つあります。1つは権限の設計で、誰がどの文書を参照した回答を受け取れるのかを、既存のアクセス権限と揃えます。もう1つは更新の運用で、文書が改訂されたときに検索対象をどう更新するかを決めます。この2つを後回しにすると、見えてはいけない情報が回答に混ざる、あるいは古い規程に基づいた回答が返る、という形で表面化します。
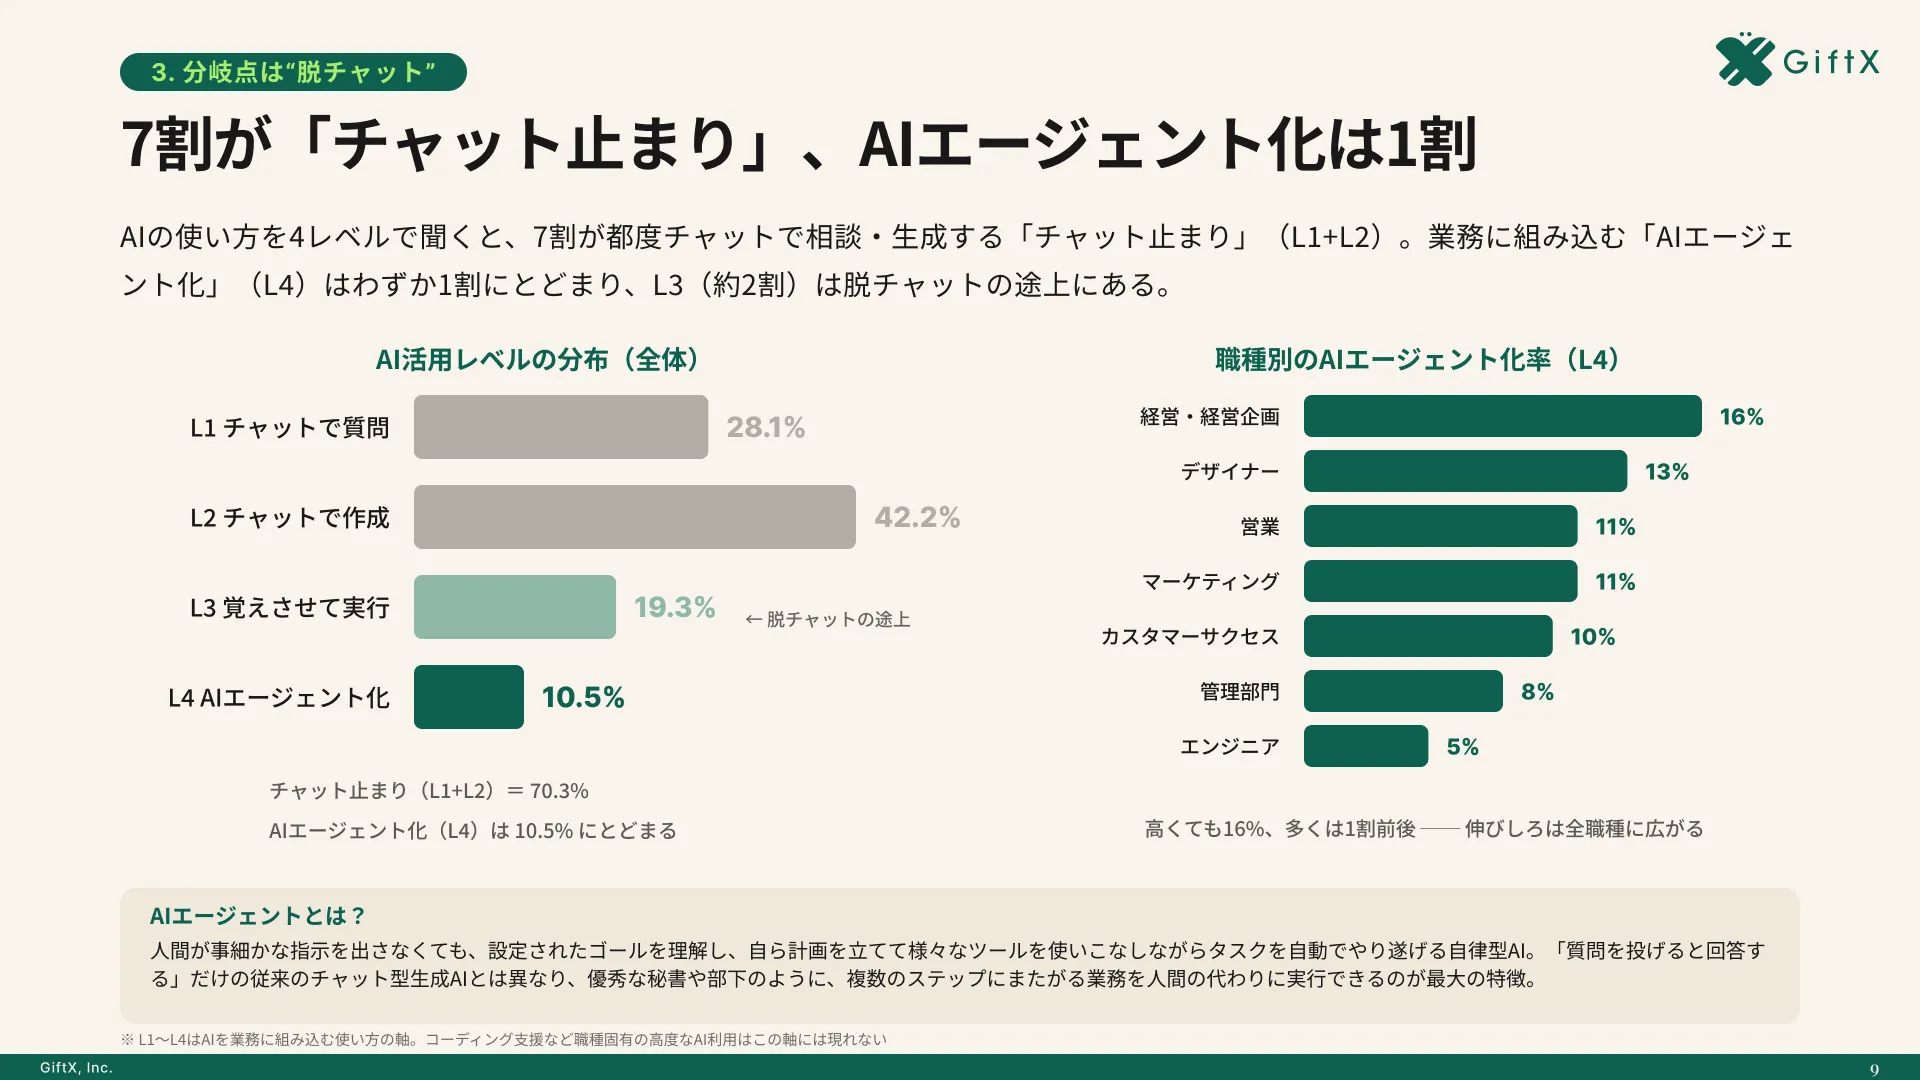
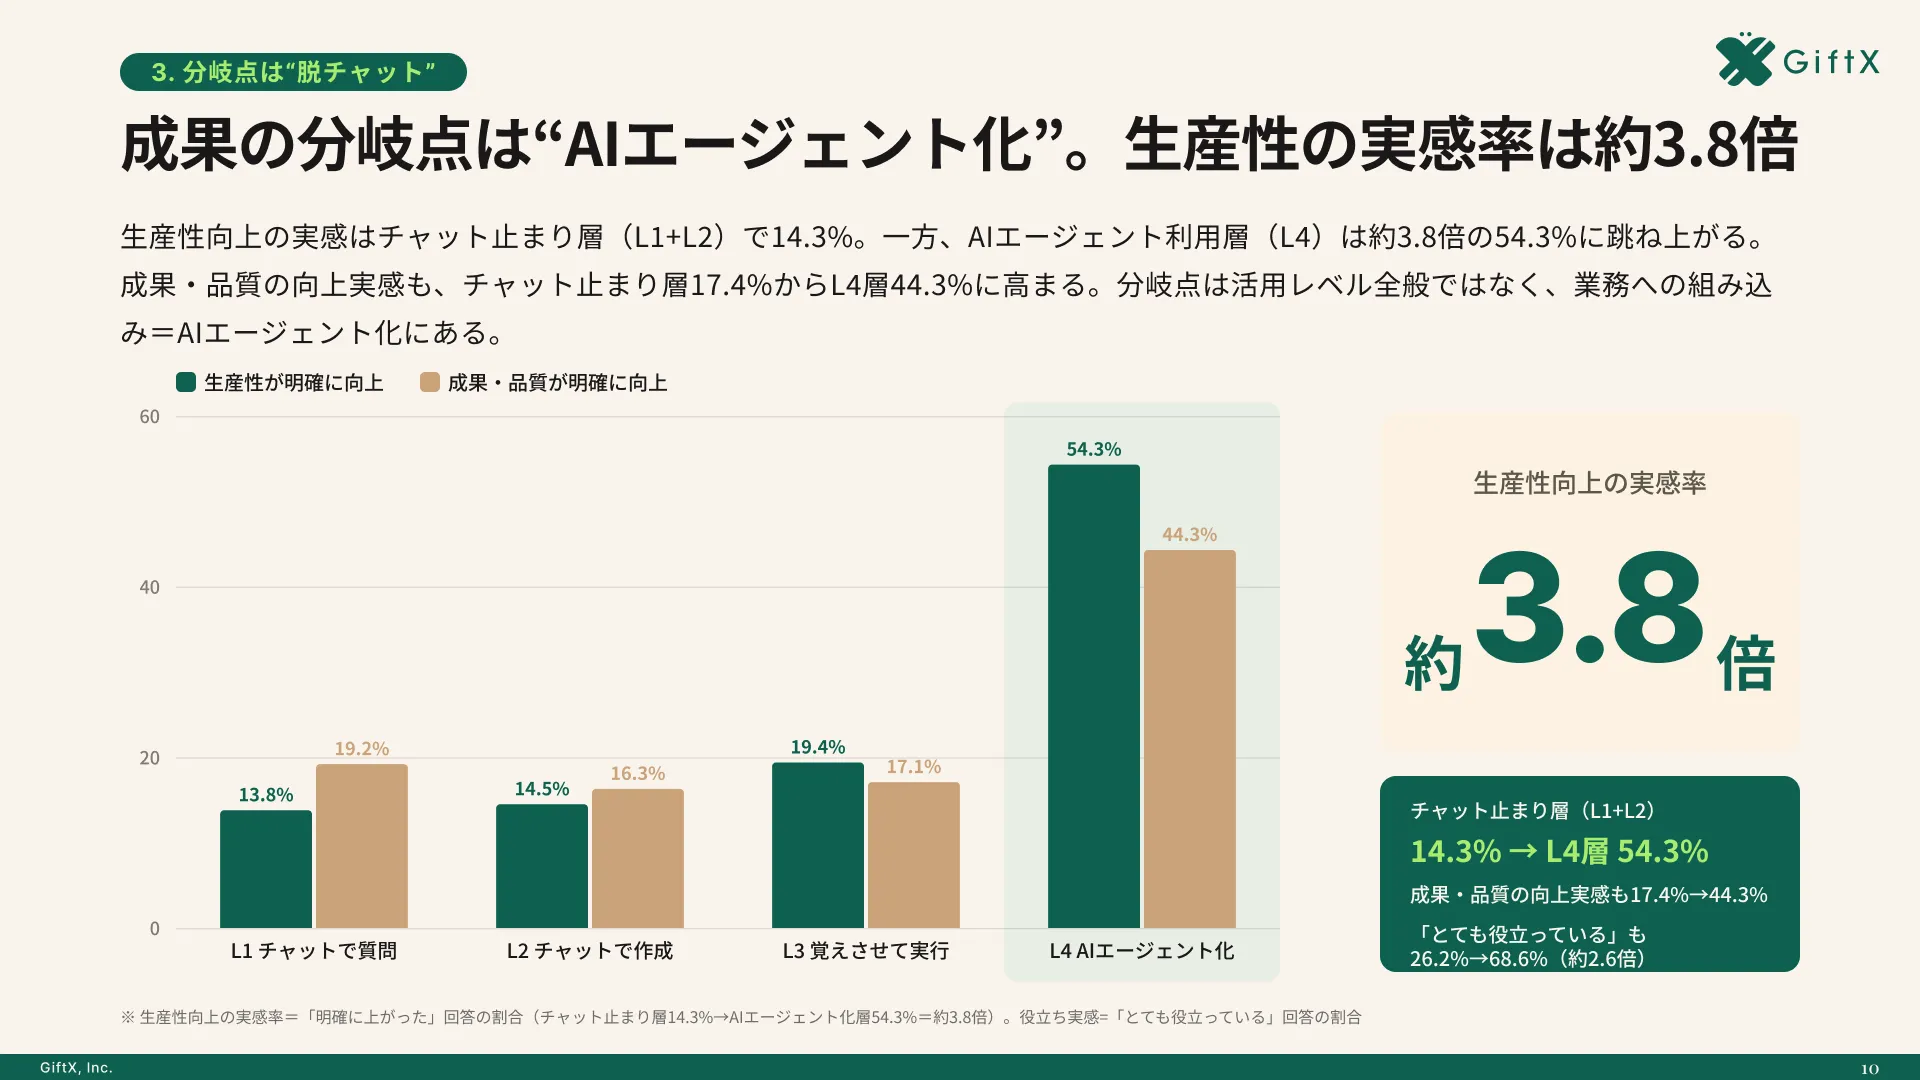
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
オンプレミスLLMに向いている企業・向かない業務
向いているのは、外部送信の制約が実際にかかっていて、かつその制約下の業務でAIを使い続ける見込みがある企業です。金融機関の基幹系システム、閉域環境を持つ製造業の開発・生産部門、患者情報を扱う医療分野などが典型例になります。利用量が多く、従量課金だと年間費用が読みにくい場合も、費用を予算化しやすいという理由で候補に入ります。
一方で、向かない使い方もはっきりしています。まだ使うかどうかを見極めている段階の検証、利用者が数人にとどまる用途、最先端モデルの性能がそのまま成果に直結する用途は、クラウドで進めるほうが合理的です。特に「とりあえず全社で使えるAI基盤を作る」という立て付けは、対象業務が決まっていないためサーバー構成も決められず、投資だけが先行します。
制約のある業務とない業務が混在している場合は、両方を使い分ける構成も選べます。機密性の高い業務はオンプレミスに置き、それ以外はクラウドを使う形です。すべてを一方に寄せる必要はありません。
運用でつまずきやすいポイント
オンプレミスLLMは、構築が終わった時点が運用の始まりです。止まりやすいのは、作ったあとに誰が何を持つのかを決めていないケースです。
モデルの入れ替えを誰が判断するか
オープンモデルは新しいバージョンが継続的に公開されます。自社の判断で更新できるのは利点ですが、裏を返せば誰も判断しなければ古いまま動き続けます。更新の判断を誰が持つのか、検証にどれだけの工数を割くのかを、導入時に決めておきます。
構築した人が抜けたあとに誰が直すか
構築時にGPUや推論基盤に詳しい人が関わっても、その人が異動したあとに障害対応ができる体制が残っていなければ、業務が止まったときに復旧できません。構築を外部に任せる場合も、運用を誰が持つのかは契約に含めて確認します。
社外に出さないことと、社内で把握できることは別
誰がどの文書を参照した回答を受け取ったかを記録していないと、不適切な出力が出たときに影響範囲を特定できません。オンプレミスにしたことで外部の事業者に関する確認事項は減りますが、社内の説明責任はむしろ自社に寄ります。取得するログの項目と保存期間は、既存の情報システムの基準に合わせて決めておきます。
関連記事:生成AI利用ガイドラインの作り方|必須項目と5ステップの策定手順
性能の基準を導入前に共有しておく
オンプレミスに置いたモデルは、クラウドの最新モデルと同じ出力を返すわけではありません。導入前の検証で「この業務ではこの水準」という基準を関係者と共有しておかないと、使い始めてから性能への不満が出て定着しません。
オンプレミスLLMの導入で陥りがちな3つの落とし穴
制約を外す手段として妥当な判断でも、進め方を誤ると設備だけが残ります。実際に止まりやすいのは、次の3つのパターンです。
落とし穴1|全社基盤として一度に作ろうとする
「社内のあらゆる業務で使えるAI基盤」を目標に置くと、要件が定まらないまま構成の議論が続きます。対象業務が決まっていなければ必要なモデル規模も同時利用者数も決まらず、サーバー構成を確定できません。結果として、検討が長期化するか、余裕を見た過大な構成を買うことになります。
落とし穴2|サーバーの調達から入ってしまう
予算の都合で機材の稟議が先に立つと、載せる業務が後付けになります。買ったGPUに合わせて使い道を探す順序では、制約が効いていない業務が対象に選ばれ、オンプレミスにした意味が説明できなくなります。
落とし穴3|既製のチャット型AIをそのまま社内に置こうとする
モデルを自社環境に置いただけでは、社内の文書も業務のルールも参照されません。既製のチャット型のまま使うと出力の手直しが増え、業務フローに組み込める水準に届きません。社内文書の接続と、自社の基準の読み込みまでを設計に含める必要があります。
スモールスタートで1業務をAIエージェントに任せる
3つに共通しているのは、対象を絞らずに始めていることです。外部送信の制約が実際に効いている業務を1つ選び、そこで成果を測れる状態を作ってから広げます。この順序であれば、必要な構成が決まり、投資の判断根拠も揃います。1業務で型ができれば、2つ目以降は同じ構成を再利用できます。GiftXでは、こうしたスモールスタート前提のAIエージェント構築を1業務単位から伴走支援しています。詳細は AIエージェント構築支援サービス をご覧ください。
オンプレミスLLMのよくある質問
オンプレミスLLMはクラウドより性能が低いのですか
最先端の大規模モデルと比較すると差はあります。ただし、社内文書の検索や下書きの生成といった業務では、中規模のオープンモデルでも必要な品質に届くことが増えています。判断は汎用ベンチマークではなく、自社の実データで比較して決めるのが確実です。
中小企業でも導入できますか
規模よりも、外部送信の制約が実際に効いているかどうかで判断します。制約がある業務が限られているなら、小規模モデルを1台のサーバーで動かす構成から始められます。制約がないのであれば、クラウドのほうが立ち上げも運用も軽くなります。
社内に専門人材がいなくても運用できますか
構築だけでなく運用まで含めて外部に任せる前提であれば可能です。ただし障害時の一次対応と、モデル更新の判断は社内に残ります。契約時に、どこまでを任せてどこからを自社で持つのかを明確にしておきます。
ファインチューニングは必要ですか
多くの場合は不要です。自社の情報を反映させたいだけであれば、RAGで文書を参照させる構成のほうが早く、文書を更新すれば回答も追随します。ファインチューニング(自社データでモデルを追加学習させること)が要るのは、出力の形式や文体を細かく揃えたい場合に限られます。
導入までにどれくらいの期間がかかりますか
対象業務の絞り込みとモデルの検証に数週間、サーバーの調達に納期分、社内データの接続と検証にさらに数週間、という積み上げになります。調達の納期が全体を左右するため、検証はクラウド上のGPUを借りて先行させ、機材の到着を待たない進め方が取られます。
まとめ|オンプレミスLLMは1業務から始める
オンプレミスLLMは、外部送信の制約があってクラウド型の生成AIを使えない業務に対して、社内で完結する実行環境を用意する方式です。判断の起点は機材ではなく制約で、通信経路・学習利用・保管場所のどれが効いているかを切り分けると、そもそもオンプレミスが必要かどうかが見えます。
そのうえで必要と判断したら、対象を1業務に絞って始めます。載せる業務が決まれば必要なモデル規模が決まり、モデルが決まればサーバー構成が決まります。この順序を守ることが、設備だけが残る事態を避ける唯一の方法です。1業務で型ができてから、同じ構成を横に広げていきます。
自社業務でのAI活用を進めたい方へ
本記事で紹介したオンプレミスLLMの検討を含め、自社の業務でAI活用を具体的に進めたい・相談したいとお考えの方は、ぜひGiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせて1業務単位のスモールスタートから本番運用まで、AIエージェント構築をワンストップで支援します。ユースケースの洗い出しから、PoC、本番運用、社内ナレッジ化まで伴走します。
AI活用にご関心のある方は、ぜひ一度ご相談ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら