Gemini TTSとは|3.8 Flash TTSとFlash-Lite TTSの2モデル
Gemini TTSは、GoogleのGeminiモデルでテキストを音声に変換する音声合成(TTS、Text-to-Speech)の機能です。2026年9月に発表された最新世代は、次の2モデルで構成されています。
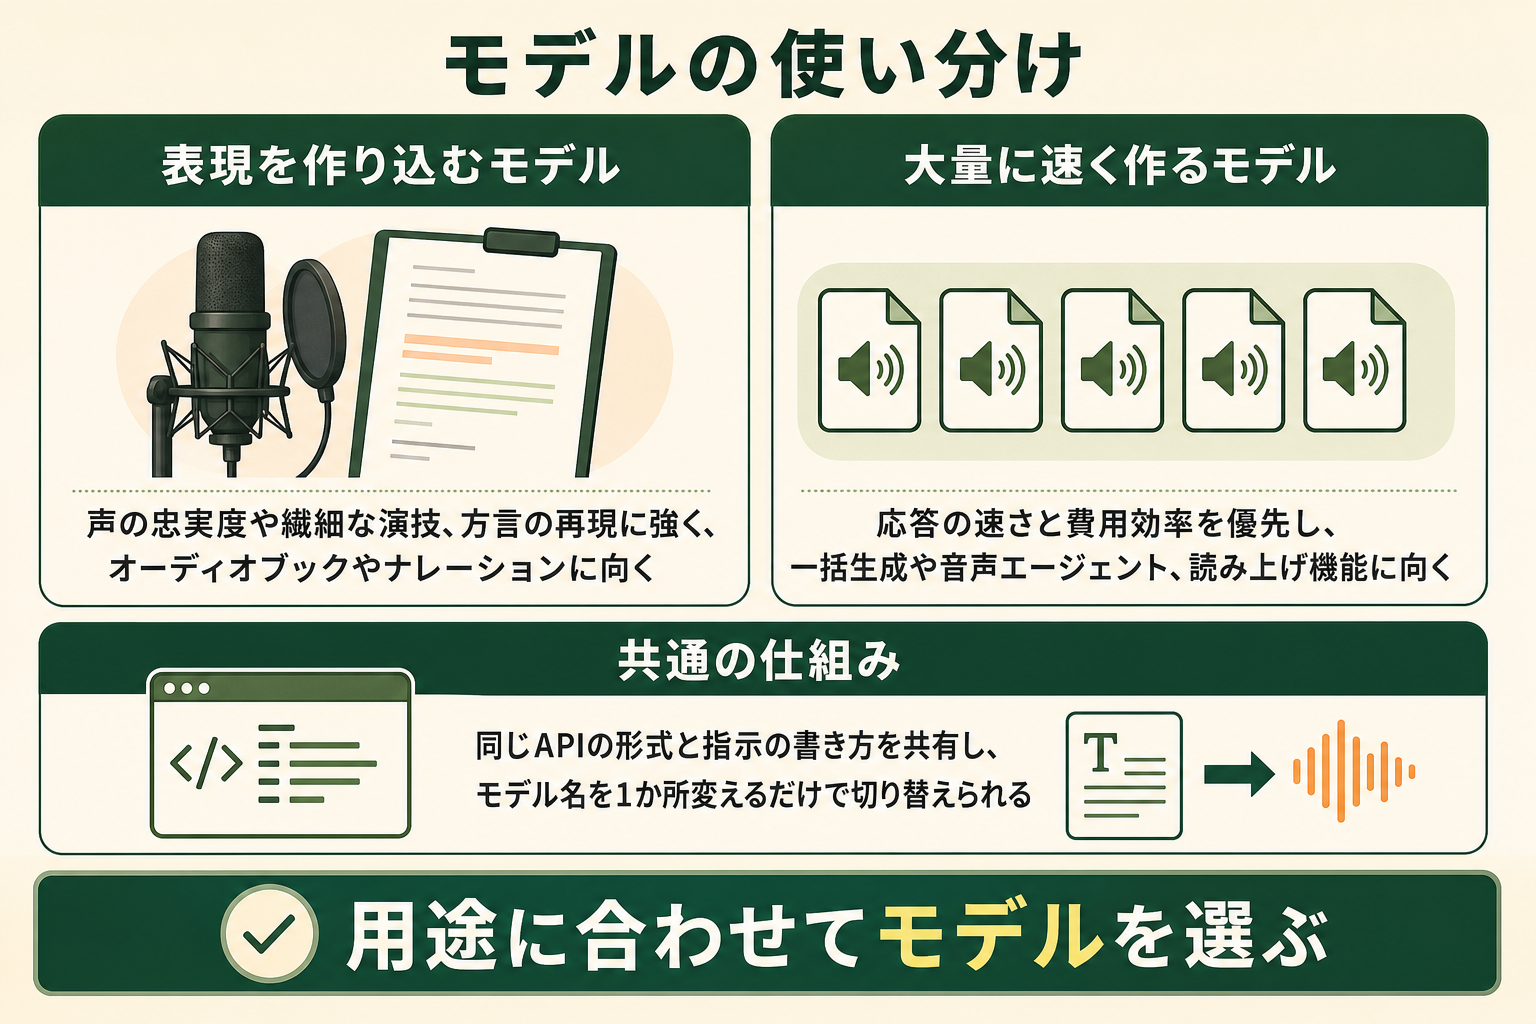
- Gemini 3.8 Flash TTS:声の作り込みや細かな演技指示に向く、創作・キャラクター向けのモデル
- Gemini 3.8 Flash-Lite TTS:大量生成や音声エージェントに向く、速度と費用を優先したモデル
どちらも入力はテキストだけ、出力は音声だけという音声合成専用のモデルです。Googleの公式発表によると、2モデルは同社で最も表現力の高い音声生成モデルと位置づけられ、発表と同時にGemini APIとGoogle AI Studioで提供が始まりました(出典: blog.google)。企業向けにはGemini EnterpriseのAPI経由での提供が予告されています。
関連記事:Geminiとは?できること・料金プラン・モデル体系とChatGPTとの違い
Flash TTSとFlash-Lite TTSの違い
2モデルは同じAPIの形式とプロンプトの書き方を共有しており、モデル名を1か所変えるだけで切り替えられます。下表は、モデル名・得意なこと・向く用途・対応言語・一般向けの提供先の5観点で両者を整理したものです。品質を詰めたい制作物にはFlash TTS、本数や応答速度が効く用途にはFlash-Lite TTS、という分け方が出発点になります。
| 観点 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| モデル名(API) | `gemini-3.8-flash-tts` | `gemini-3.8-flash-lite-tts` |
| 得意なこと | 声の忠実度、繊細な演技、方言やアクセントの再現 | 大量処理、低遅延、費用効率 |
| 向く用途 | オーディオブック、ナレーション、複雑な2話者の会話、難しい発音 | 一括の大量生成、リアルタイムの音声エージェント、読み上げ機能、声の複製 |
| 対応言語 | 130言語(日本語を含む) | 101言語(日本語を含む) |
| 一般向けの提供先 | Gemini Notebook | Google Vids |
たとえば、1本の解説動画に感情のこもった語りを付けるならFlash TTS、商品説明の読み上げ音声を数百本そろえるならFlash-Lite TTSが候補になります。迷う場合は、同じ台本を両方で生成して聞き比べると判断が早まります。
前世代のGemini 3.1 Flash TTSから変わったこと
これまでのGemini 3.1 Flash TTS(プレビュー版)は、1人または2人の話者で読み上げる機能までの提供でした。3.8世代では、自然文で声を作る「ボイスデザイン」と、手持ちの音声から声を再現する「ボイスレプリケーション」が両モデルで使えるようになっています。公式ドキュメントでは、Flash-Lite TTSを3.1 Flash TTSプレビューの後継として推奨しています(出典: Google AI for Developers)。
Googleの公式発表によると、Flash TTSはHume AIのVoice Design Benchmarkで総合1位(71.4)を獲得し、長尺の読み上げや2話者の台本演出も3.1 Flash TTSから大きく改善したとされています(出典: blog.google)。いずれもGoogle側の発表値のため、自社の台本での聞き比べとあわせて判断材料にします。
日本語への対応
日本語はFlash TTSとFlash-Lite TTSの両方が対応しており、入力テキストの言語は自動で判別されます。Googleの公式発表では、ブラインド形式で人が聞き比べるVoice Arenaの評価で、日本語を含む主要言語において上位に入ったと説明されています(出典: blog.google)。
日本語の台本で使うときの注意点は、笑い声や間を指示する音声タグを英語のまま書くことです。公式ドキュメントは、英語以外の台本でも英語のタグを使うと最適な結果になると案内しています。
Gemini TTSでできること|声の用意と演技指示の仕組み
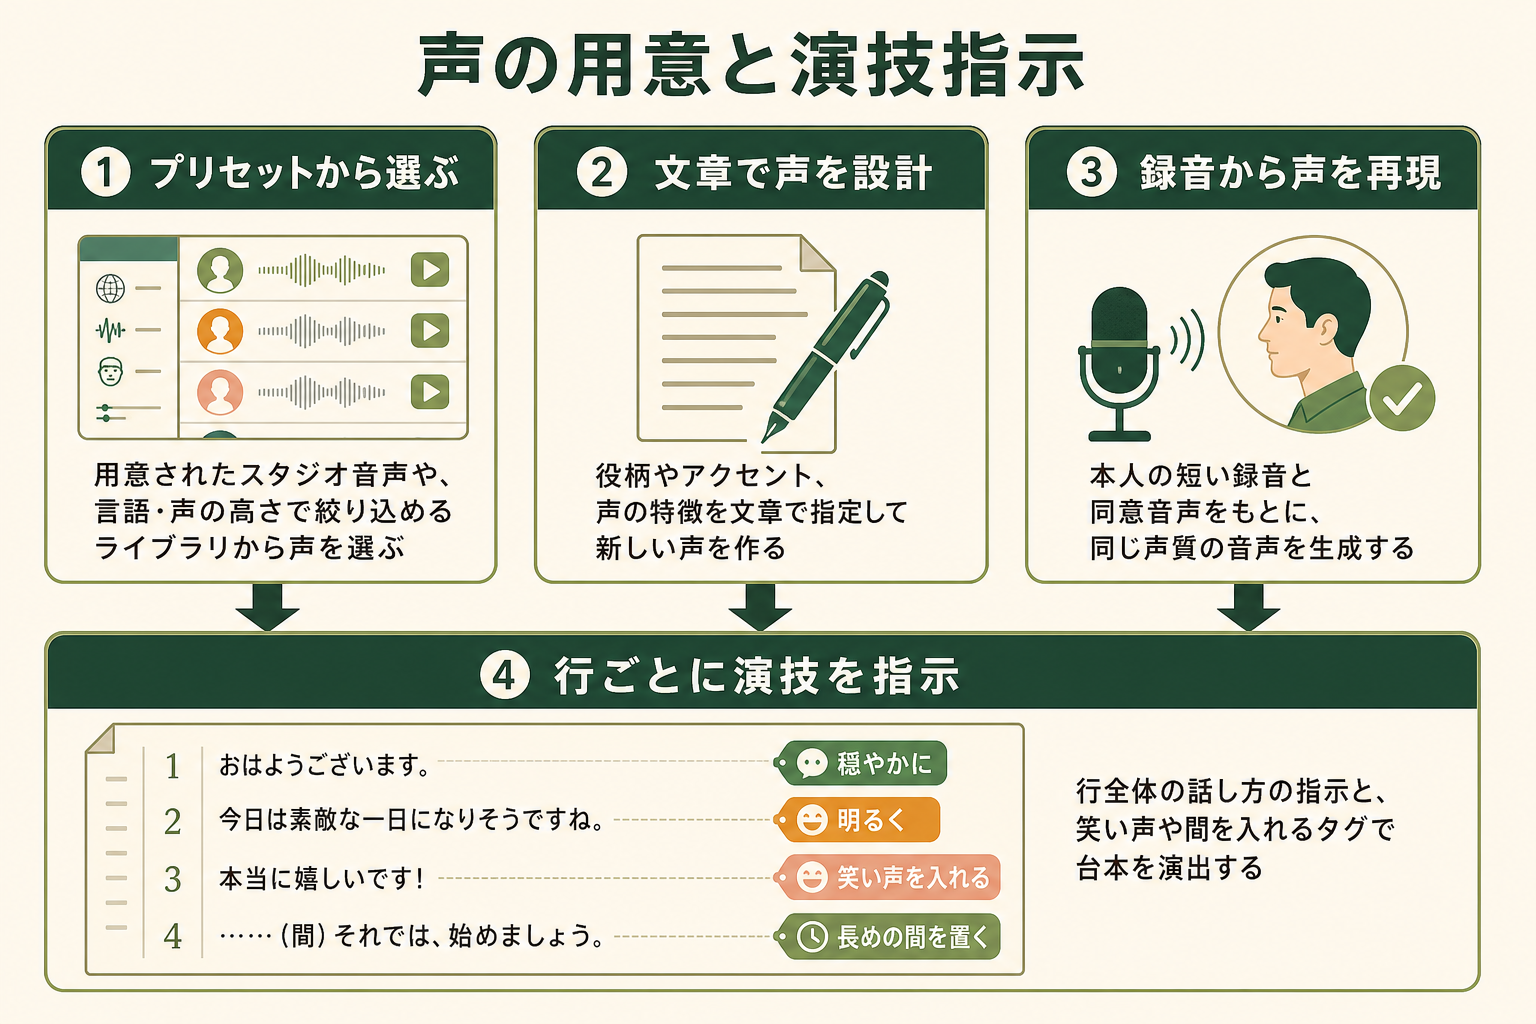
Gemini TTSでは、声を「選ぶ・作る・再現する」の3通りで用意し、そのうえで台本の行ごとに話し方を指示します。声の用意の仕方によって、使えるモデルや話者の組み合わせ方が変わります。
プリセット音声とボイスライブラリから選ぶ
最も手軽なのは、あらかじめ用意された30種類のスタジオ音声から選ぶ方法です。「Kore(Firm)」「Puck(Upbeat)」「Charon(Informative)」のように、声ごとに落ち着き・明るさといった性格が付けられています。
これに加えて、拡張ボイスライブラリから言語・地域のアクセント・性別・声の高さ・用途(オーディオブック、会話、ニュースなど)で絞り込んで声を探せます。Googleの公式発表では、すぐに使える声が2,000以上あるとされています(出典: blog.google)。
自然文で声を設計する(ボイスデザイン)
「落ち着いた低めの声で、語尾をはっきり話すナレーター」のように、役柄・アクセント・声の特徴を文章で指定すると、新しい声を作れます。作った声には「voice_」で始まるIDが付き、以降のリクエストで同じ声を呼び出せます。保存できる声は1プロジェクトあたり最大200個、保持期間は1年です(出典: Google AI for Developers)。
公式発表では、声の設計はFlash TTSの強みとして紹介されています。ライブラリの声を選んだうえで声質や話す速さを文章で微調整する「ボイスリミックス」は、近日提供と予告された段階です。
手持ちの音声から声を再現する(ボイスレプリケーション)
自分の声や使用権を持つ声の録音から、同じ声質の音声を生成できます。公式ドキュメントでは、再現したい話者の10〜30秒の音声と、同じ話者が所定の同意文を読み上げた音声の2つが必要とされています(出典: Google AI for Developers)。本人の同意音声が必須で、AI Studioで声を複製できない地域もあるため、使う前に条件を確認します。
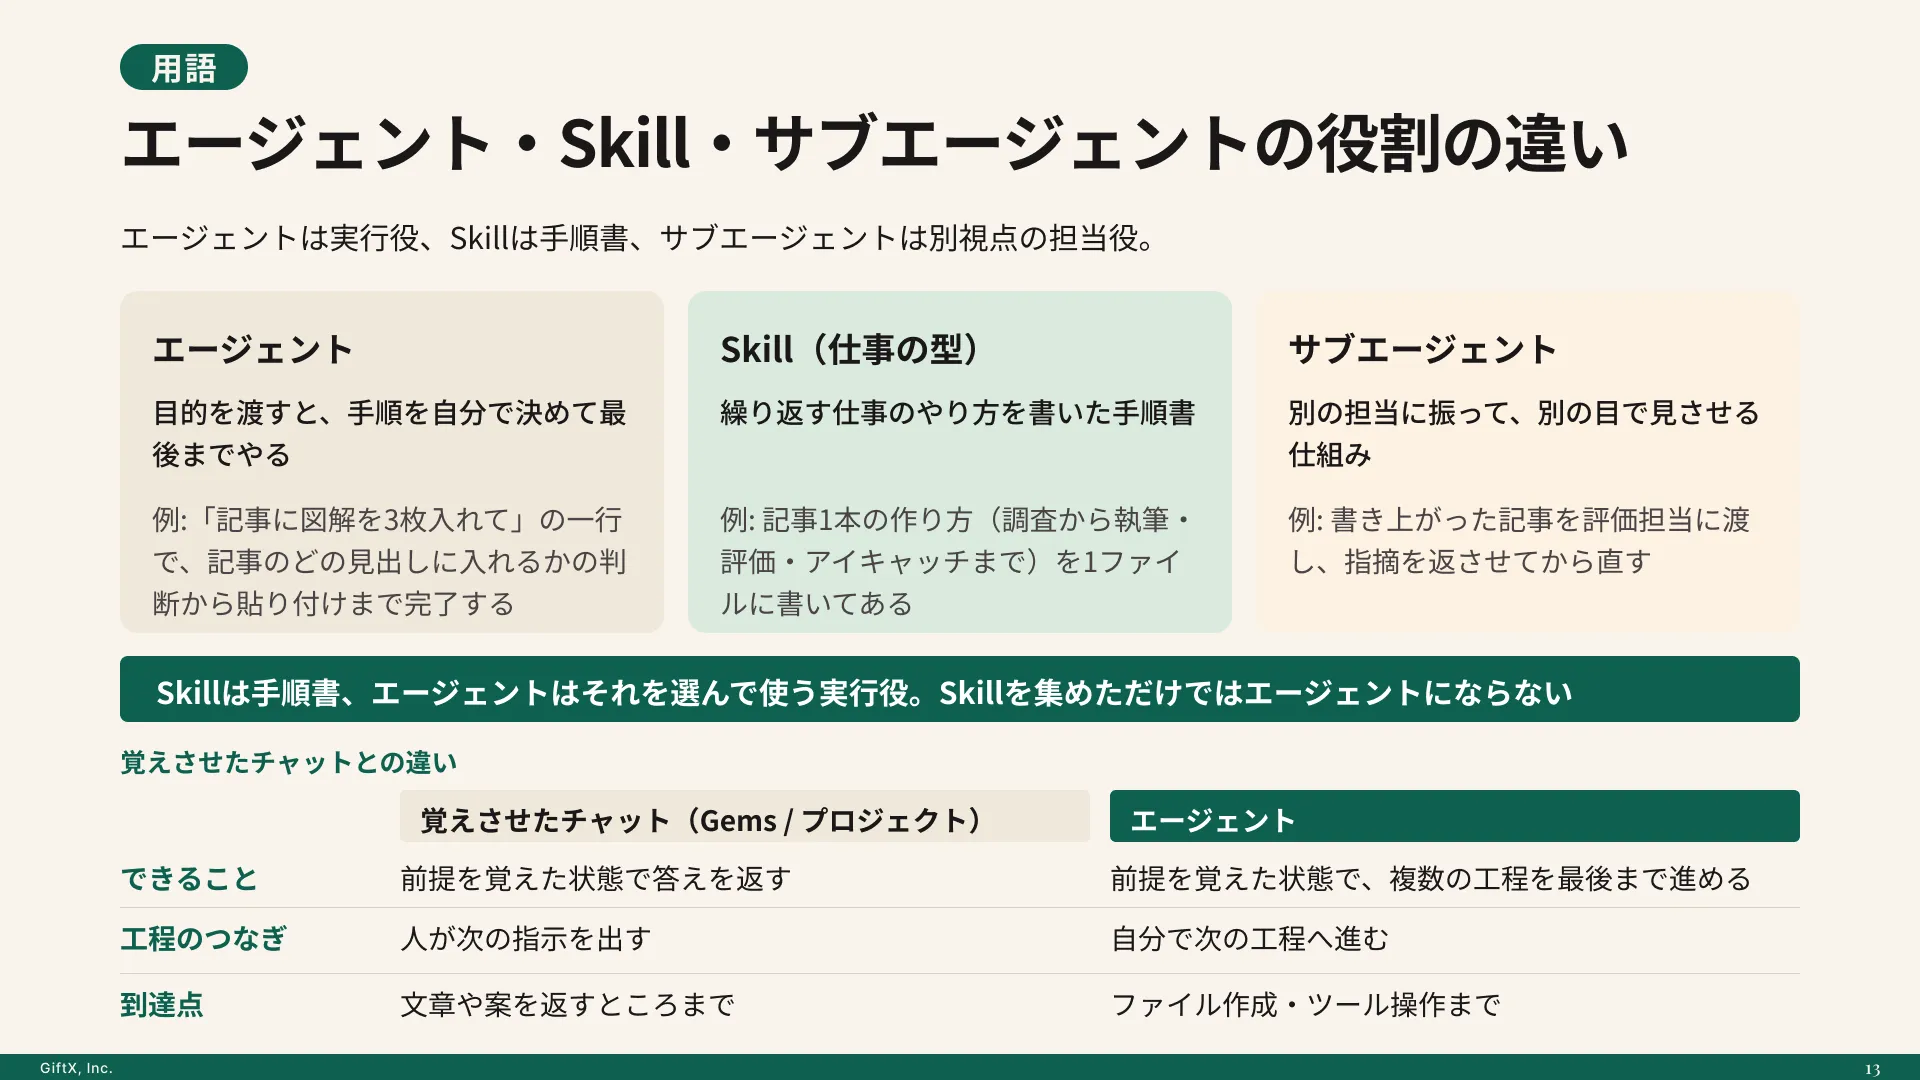
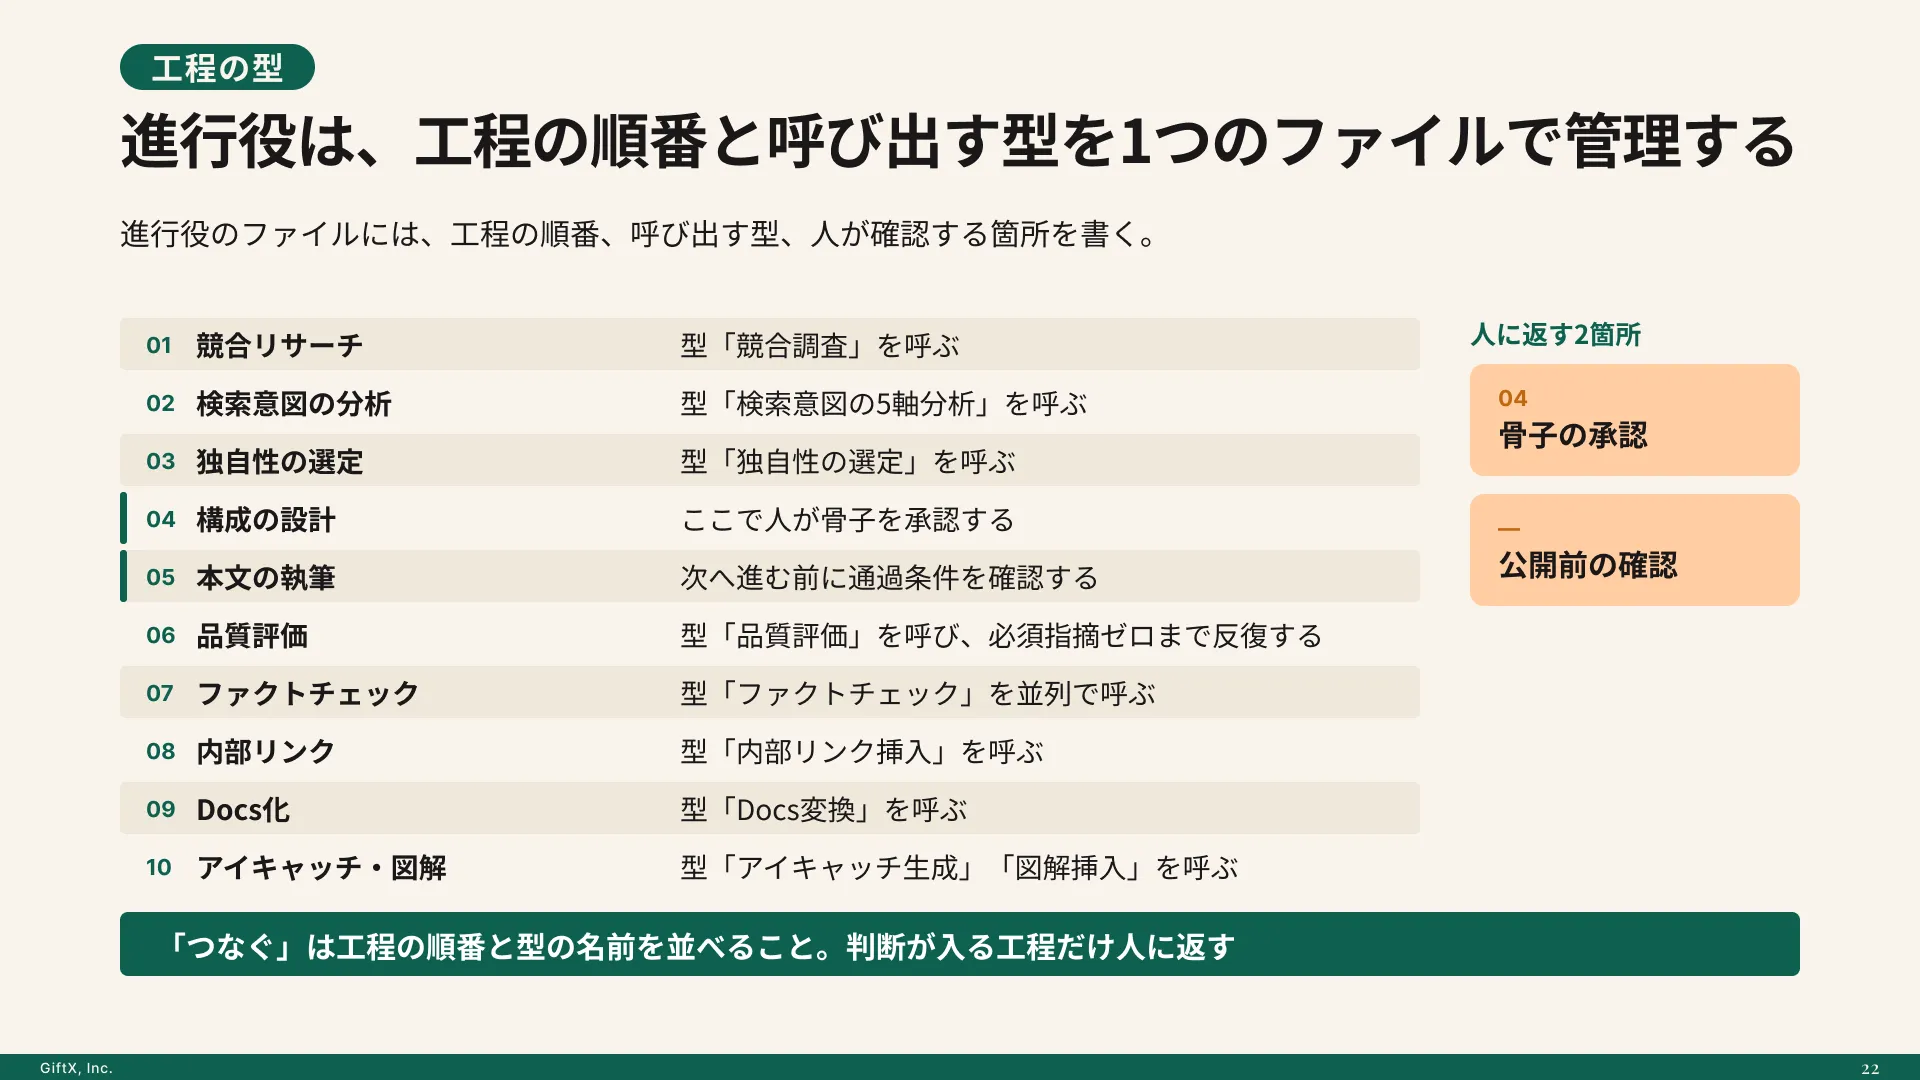
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
行ごとの演技指示と音声タグ
話し方の指示は、台本の本文とは分けて書きます。3.8世代は入力テキストを「読み上げる原稿」として厳密に扱うため、本文に「明るく言って:」と書くと、その指示まで読み上げられる場合があります。
- 行全体の話し方:
speech_metadataのstyle欄に「warm and enthusiastic」「speaking slowly」のような指示を入れる - 一瞬の反応や間:本文の該当位置に
<laugh><sigh><short pause>のようなタグを差し込む - 相づち:2話者の会話で、相手の発言中に
|mhm|のようにパイプ記号で囲んだ短い反応を入れる
公式ドキュメントは、まず指示を空にして素の読み上げを試し、必要な行にだけ短い指示を足す進め方を推奨しています。長い演出メモを毎回送ると、かえって声のぶれが増えるためです。
2話者の会話と長尺の読み上げ
1回のリクエストで、2人の話者による会話を生成できます。ポッドキャストの掛け合いや対談形式の解説を、1本の台本から声を分けたまま作れる点が特徴です。ただし2話者を同時に扱えるのはプリセット音声の場合で、自分で作った声や複製した声を組み合わせるときは、話者ごとに生成してつなぎ合わせます。
1回のリクエストで出力できる上限は16,384トークンで、音声は1秒あたり25トークンとして数えるため、単純計算では約11分に相当します。公式発表では数時間の連続音声でも声質のぶれを抑えられるとされており、オーディオブックのような長尺は章ごとに分けて生成する設計になります。
Gemini TTSの料金|Flash TTSとFlash-Lite TTSを比較
Gemini APIの有料枠では、入力したテキストと出力した音声のそれぞれに、100万トークンあたりの料金がかかります。3.8世代の2モデルは2026年12月31日までの価格が設定されており、2027年1月1日から入出力とも2倍に改定される予定です(最新確認時点(2026年9月)、出典: Google AI for Developers)。
| モデル | 入力(テキスト) | 出力(音声) | 2027年1月1日以降 |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 0.50ドル | 9.00ドル | 入力1.00ドル/出力18.00ドル |
| Gemini 3.8 Flash-Lite TTS | 0.50ドル | 6.00ドル | 入力1.00ドル/出力12.00ドル |
| Gemini 3.1 Flash TTS(プレビュー) | 1.00ドル | 20.00ドル | 記載なし |
音声は1秒あたり25トークンなので、1時間の音声は9万トークンです。出力料金だけで試算すると、1時間あたりFlash TTSは0.81ドル、Flash-Lite TTSは0.54ドルで、3.1 Flash TTSの1.80ドルより低くなります(最新確認時点(2026年9月)、出典: Google AI for Developers)。2027年以降はそれぞれ1.62ドルと1.08ドルになる計算です。
無料枠でも入力・出力とも料金はかかりませんが、無料枠で送った内容はGoogleの製品改善に使われる扱いです(最新確認時点(2026年9月)、出典: Google AI for Developers)。有料枠では製品改善に使われないため、公開前の台本や社外秘の原稿を扱う段階では有料枠へ切り替えるのが安全です。
関連記事:Gemini API の料金を3ケースで試算|無料枠の範囲とコストを抑える設定
Gemini TTSの使い方|Google AI Studioで日本語の音声を作る手順
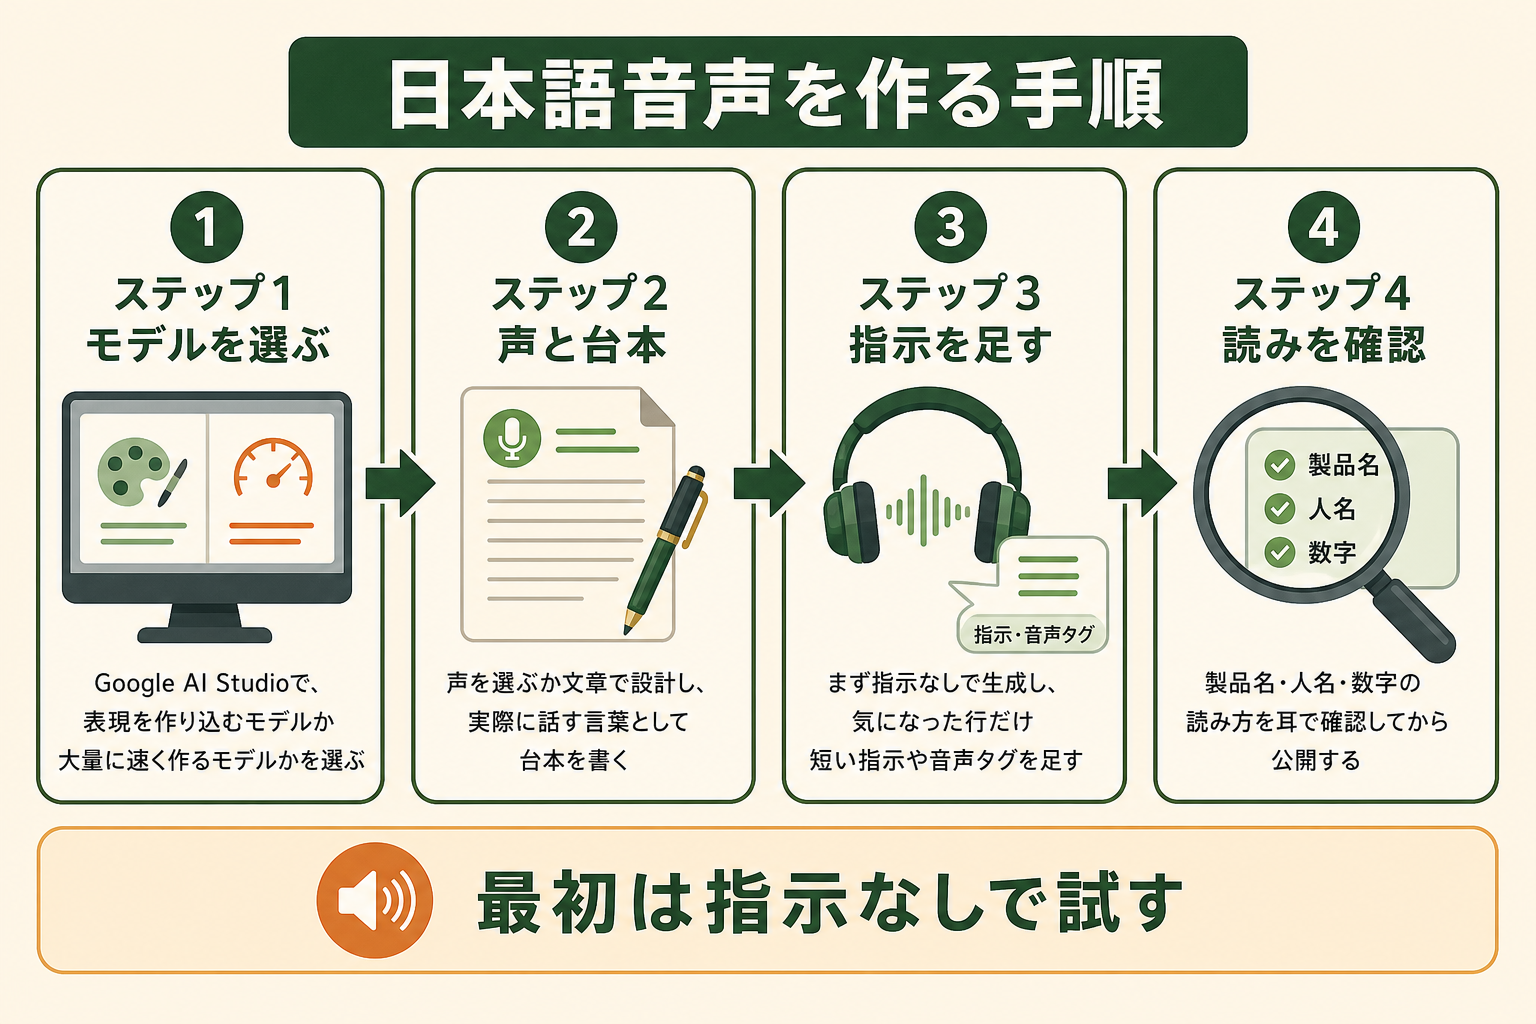
開発者が試すなら、ブラウザで使えるGoogle AI Studioから始めるのが近道です。公式ドキュメントも、アプリに組み込む前にAI Studioでモデルを試すことを勧めています。
ステップ1: Google AI StudioでTTSモデルを選ぶ
Google AI Studioを開き、モデルの一覧から「Gemini 3.8 Flash TTS」または「Gemini 3.8 Flash-Lite TTS」を選びます。AI Studioには声の設計から台本の演出までを1か所で試せる音声用の作業画面が用意されており、2話者の台本を行ごとに編集できるエディターも備わっています。
ステップ2: 声を決めて台本を入れる
プリセットやライブラリから声を選ぶか、文章で声を設計します。台本は、実際に話す言葉として書くのが基本です。公式ドキュメントでは、言いよどみやためらいも含めて話し言葉として書くと自然さが増すとされています。
ステップ3: 必要な行にだけ指示を足して聞き比べる
最初は話し方の指示を空にして生成し、聞き直して気になった行にだけ短い指示やタグを足します。製品名・人名・数字の読み方は誤りが出やすい箇所なので、公開前に必ず耳で確認します。
APIに組み込むときに押さえる設定
アプリに組み込む場合は、API(Application Programming Interface、ソフトウェア同士をつなぐ接続仕様)で上記のモデル名を指定します。押さえておきたい設定は次のとおりです。
- 出力形式:通常のリクエストは24kHz・モノラルのWAVファイルで返り、そのまま保存できる
- ストリーミング:生成と同時に受け取る設定では、ヘッダーなしの音声データが少しずつ届く
- 電話向けの形式:日本や北米の電話・自動音声応答で使われるμ-law形式などにも変換して出力できる
- 大量処理:Batch APIに対応しており、まとめて投入する運用も組める
音声エージェントに組み込むときは、応答文が1ターン分届くごとにTTSを1回呼び出す構成が推奨されています。Flash-Lite TTSは、この会話型の用途に最適化されたモデルとして案内されています。
Gemini NotebookとGoogle Vidsで使う場合
開発者以外の利用者向けには、Flash TTSはGemini Notebookで提供が始まっています。Flash-Lite TTSのGoogle Vidsへの組み込みは、TTSの発表では2026年9月23日(米国時間)から順次展開とされる一方、同日のGoogle Vidsの発表では近日提供と案内されています(詳しくはGoogle Vidsの解説を参照)。APIを触らずに音声を作りたい場合はこれらの製品が入口になりますが、利用できるプランや機能の範囲は各製品の案内で確認が必要です。
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
関連記事:Gemini Notebookとは?できること・料金とAIチャットとの違い
Gemini TTSとLive APIの違い|読み上げと会話で使い分ける
Geminiで音声を扱う手段には、TTSのほかにリアルタイムの会話向けのLive APIがあります。下表は、主な用途・入力・話し方の制御の3観点で両者を整理したものです。決まった台本を正確に読ませるならTTS、相手の発話に応じて返すならLive APIと考えると選びやすくなります。
| 観点 | Gemini TTS | Live API |
|---|---|---|
| 主な用途 | 台本の正確な読み上げ(ポッドキャスト、オーディオブック、ナレーション) | 双方向のリアルタイム会話 |
| 入力 | テキストのみ | 音声を含むマルチモーダル入力 |
| 話し方の制御 | 行ごとのスタイル指示と音声タグで細かく指定 | 会話の流れに合わせて動的に応答 |
なお、音声エージェントでも、応答文を別のモデルで作ってからTTSで声にする構成なら、声質や読み方を細かく管理できます。会話の自然な間合いを優先するか、声の管理を優先するかで選び分けます。
Gemini TTSで声を複製・公開するときの注意点
声の複製と生成音声の公開は、技術面より先に権利と同意の確認が求められます。公式情報で明記されている条件は、同意音声・電子透かし・提供地域・無料枠の扱いの4点です。
本人の同意音声がないと声は作れない
声を複製するには、同じ成人の話者による2つの録音が必要です。1つは10〜30秒の自然な話し声、もう1つは所定の同意文を読み上げた音声で、日本語を含む30の言語・地域の組み合わせで同意文が用意されています。同意音声の話者と参照音声の話者が一致しないと、声は作成されません。
生成した音声には電子透かしが入る
Gemini系の音声モデルで生成した音声には、耳では聞き取れないSynthIDの電子透かしが埋め込まれます。声の複製には、コンテンツの来歴を示すC2PAの認証情報も組み合わされています(出典: blog.google)。
提供地域と保存期間を確認する
AI Studioでの声の複製は、米国イリノイ州・テキサス州、EEA(欧州経済領域)、英国、スイス、インドでは提供されていません(2026年9月時点)。保存した声は1年で期限を迎えるため、長く使う声は管理台帳を作っておくと安心です。
無料枠で機密性の高い台本を扱わない
Gemini APIの無料枠で送った台本は、Googleの製品改善に使われる扱いです。社外秘の情報を含む原稿や、実在の人物の声を扱う検証は、有料枠に切り替えてから進めます。
音声コンテンツをAIで内製するときに陥りがちな3つの落とし穴
Gemini TTSのように手軽な音声合成が使えるようになると、録音や外注に頼っていた音声づくりを社内に取り込みやすくなります。一方で、進め方を誤ると公開できる品質に届かず、結局は録り直しに戻ることがあります。
落とし穴1|すべてのナレーションを一度にAI音声へ切り替える
過去の動画や資料の音声を一斉に置き換えると、読み間違いの確認が追いつかず、修正箇所がどこにあるのかも追えなくなります。
落とし穴2|台本と読みの確認を兼任の担当者に任せきりにする
製品名や数字の読み方は、台本ごとに聞いて確かめる必要があります。兼任の担当者が片手間で聞き直す体制では、確認が後回しになります。
落とし穴3|生成した音声を聞き直さずにそのまま公開する
AIが作る音声は自然に聞こえても、固有名詞の読みや間の取り方に誤りが残ることがあります。そのまま公開すると、視聴者の信頼を損ねかねません。
検証工程を持ったうえで、まず1コンテンツを型にする
まずは製品紹介動画1本、マニュアル1章のように対象を1つに絞り、台本・声・話し方の指示・聞き直しのチェック項目を1セットの型としてまとめます。検証工程まで含めた型ができれば、2本目以降は同じ手順で本数を増やせます。聞き直しで見つかった誤りは、その都度チェック項目に書き足して型を育てます。
GiftXでは、検証工程を含めたコンテンツ制作を1コンテンツ単位から伴走支援しています。詳細は AI活用コンテンツ制作支援 をご覧ください。
Gemini TTSのよくある質問
Gemini TTSは無料で使えますか?
Gemini APIの無料枠では、Flash TTSとFlash-Lite TTSを入出力とも無料で使えます。ただし無料枠で送った内容はGoogleの製品改善に使われるため、機密性の高い台本は有料枠で扱います。一般向けにはGemini Notebookから使え、Google Vidsへの組み込みも案内されていますが、利用条件は各製品の案内で確認が必要です。
Gemini TTSで日本語の音声は作れますか?
作れます。Flash TTSとFlash-Lite TTSはどちらも日本語に対応し、入力した言語を自動で判別します。日本語の台本でも、笑い声や間を指示する音声タグは英語で書くのが推奨されています。
ElevenLabsなどの音声生成サービスとどちらを選べばよいですか?
自社のアプリやワークフローにGemini APIを組み込む予定があるなら、同じAPIで扱えるGemini TTSから試すと構成がシンプルになります。専用の音声生成サービスは、機能や料金体系がサービスごとに異なるため、同じ台本で音質と費用を比べて判断します。
Gemini 3.1 Flash TTSから移行するときの注意点は?
3.8世代は入力テキストを読み上げ原稿として厳密に扱うため、本文に埋め込んでいた話し方の指示は speech_metadata に移します。通常のリクエストの出力形式も、ヘッダーなしの音声データからWAVファイルに変わりました。料金はFlash-Lite TTSの出力が100万トークンあたり6.00ドルで、3.1 Flash TTSの20.00ドルより下がります(最新確認時点(2026年9月)、出典: Google AI for Developers)。
まとめ
Gemini TTSの最新世代は、表現力を重視したGemini 3.8 Flash TTSと、大量生成や音声エージェント向けのFlash-Lite TTSの2モデルで構成されています。声を選ぶだけでなく、文章で設計したり手持ちの録音から再現したりでき、日本語の台本にも対応しています。有料枠の料金は前世代の3.1 Flash TTSより下がりましたが(2026年9月時点)、無料枠の入力は製品改善に使われる点と、声の複製には本人の同意音声が要る点を押さえておく必要があります。音声を社内でつくる体制に移すなら、検証工程を持ったうえで、まず1コンテンツを型にすることがポイントです。
音声・動画コンテンツの制作体制にお悩みの方へ
本記事で紹介したAI音声を使って、自社の動画や資料の音声コンテンツを継続的に制作したい・相談したいとお考えの方は、ぜひGiftXのAI活用コンテンツ制作支援までお問い合わせください。
GiftXのAI活用コンテンツ制作支援では、貴社の事業・商品・制作基準を学習した専用AIエージェントを構築し、企画・制作から専門チームによる最終レビューまで一貫して行います。制作でつくった専用AIエージェントと制作フローを貴社へ移管し、社内で継続的に運用できる体制づくりまで支援します。
コンテンツ制作のリソースや品質にお困りの方は、ぜひ一度ご相談ください。
▶ GiftXのAI活用コンテンツ制作支援の詳細・お問い合わせはこちら