MAI-Voice-2.1とは
MAI-Voice-2.1は、Microsoft AIが開発し、Azure Speechを通じて利用するテキスト読み上げモデルです。録音を文字にする音声認識とは逆に、入力した文章を話す音声へ変換します。
文章から声を生成する音声合成モデル
テキスト読み上げは、文章の内容を保ちながら、発音、間、抑揚を音声として出力する処理です。MAI-Voice-2.1では、用意された音声を選んだうえで、原稿を読み上げさせます。動画のナレーションや説明音声など、文章から音を作る場面が中心になります。
生成されるのは音声であり、映像、字幕、スライドが一式で完成するわけではありません。映像と組み合わせる場合は、音声の長さを確認し、別の編集工程で素材を配置します。原稿の誤りを自動で直すことを前提にせず、入力文と出力音声の双方を確認します。
たとえば、説明文を音声に変えるだけなら、聞き取りやすさと読み間違いを確認します。動画に使う場合は、それに加えて画面の切り替えと発話が合うかを見る必要があります。同じモデルでも、完成物の形によって必要な確認は変わります。
モデル名は、生成を担う仕組みの名称です。アプリの契約名や、選ぶ声の名称とは異なります。利用するときは、モデル、音声名、入力言語を分けて記録すると、別の条件で生成した結果を混ぜずに比較できます。
通常版とFlashを用途に合わせて選ぶ
MAI-Voice-2.1には、通常版とMAI-Voice-2.1-Flashがあります。公式ドキュメントは、通常版を長い文章の安定した表現、Flashを応答の速さが必要な場面に向けて説明しています。両者を単なる新旧モデルとして扱うと、選ぶ基準を取り違えます。
通常版は、まとまった説明やナレーションを聞き比べる候補になります。Flashは、入力後すぐに音声を返したい体験を検証する候補です。出力が速いことと、長い台本で声が安定することは別の評価項目です。
短い文章だけで通常版とFlashを比較すると、長文の途中で話し方が変わるかを確認できません。反対に、長い原稿の完成音声だけを比較すると、最初の音が出るまでの待ち時間を見落とします。使う場面に合う原稿と測り方を準備します。
Azure SpeechとPreviewの提供条件
Azure Speechは、音声認識や音声合成を提供するAzureのサービスです。MAI-Voice-2.1を試すには、対応するSpeechリソースと利用経路を確認します。既存の別モデルの音声が使える環境でも、MAIモデルを同じ条件で使えるとは限りません。
2026年10月時点で、通常版とFlashはPublic Previewとして案内されています。Previewは試用中の提供段階で、公式ドキュメントはSLAの対象外とし、本番利用を推奨していません。SLAはサービスの稼働や品質について定める保証条件です。
したがって、最初は試験用の原稿で、発音と利用条件を確認する進め方が適しています。一般提供への移行日や、本番環境での保証を記事から補って判断しないでください。導入を決める時点で、最新の提供状況と契約条件を読み直します。
モデルの位置づけと提供条件は、MicrosoftのMAI voicesドキュメントで確認できます。音声を生成できたことと、継続して公開用途に使えることを分けて判断します。
MAI-Voice-2.1でできること
MAI-Voice-2.1では、多言語の音声生成、話し方の制御、条件を満たした声のクローンを扱います。どの機能も、入力した原稿の確認を省く理由にはなりません。
多言語のナレーションを作る
公式案内では、通常版とFlashは23言語、26ロケールに対応します。ロケールは、同じ言語でも地域などによって分かれる設定です。言語数とロケール数は別の数であり、26種類の言語を使えるという意味ではありません。
多言語音声を作る際は、翻訳した文章の意味と、読み上げた音声の自然さを別々に確認します。音声が流暢でも、原稿の訳が不正確なら意図した説明にはなりません。対象言語を理解できる人が、文章と音声を同じ条件で確認する工程を用意します。
固有名詞、製品名、略語、数字は、短い試験文に集めて聞き比べると判断しやすくなります。完成原稿を何度も生成する前に、読み方に迷う語を確認しておくと、修正対象を絞れます。この工程は制作上の提案で、モデルが必ず正しく発音するという保証ではありません。
日本語は、公式対応一覧でMAI-Voice-2.1の対応を確認できていません。23言語という総数から日本語対応を推定せず、後述する言語一覧とモデル指定を確認します。日本語のナレーションが必須なら、対応が明記された別の音声も比較対象にします。
SSMLで話し方を制御する
SSMLは、読み上げる文章に音声向けの指定を加えるための記述形式です。MAI voicesのドキュメントでは、用意された音声に対して、mstts:express-asによる感情表現の制御が案内されています。通常の文章を入力する場合とは、指定できる範囲を分けて確認します。
表現の指定は、すべての声や利用経路で同じ結果になるとは限りません。選んだ音声に対応する指定を確認し、文章の意味に合う表現かを聞いて判断します。落ち着いた説明に過度な感情表現を加えると、内容より声の変化に注意が向く場合があります。
調整するときは、原稿、音声、表現指定のうち一つだけを変えて比較します。同時にすべてを変えると、何が聞きやすさに影響したか分かりません。採用した条件を残しておけば、次の原稿でも同じ基準で確認できます。
たとえば、句読点の入れ方で区切りを調整した結果と、感情の指定を変えた結果は別の候補として保存します。聞き比べる目的を決め、原稿の修正で解決する問題と、音声設定で解決する問題を分けて記録します。
同意とアクセス条件を満たして声をクローンする
ボイスクローンは、本人の声をもとに音声を生成する機能です。公式ドキュメントでは、短いサンプルを使う仕組みとともに、話者の同意と利用のためのアクセス条件が案内されています。標準の音声を選ぶ操作と、本人の声を登録する操作は同じではありません。
MAI voicesの案内では、サンプルは5〜60秒の範囲です。ただし、必要な長さを満たした録音があれば自由にクローンできるという意味ではありません。利用申請、話者の同意、録音の内容などを、実際の登録経路に沿って確認します。
声を提供する本人には、どの原稿に使うか、誰が生成するか、どこで公開するかを具体的に伝えます。登録の同意があっても、当初の範囲を超える表現や公開先まで了承されたと判断しないでください。制作側では同意の範囲を記録し、原稿の確認と結び付けます。
機能の説明と使用条件は、MAI voicesの公式ドキュメントが根拠です。生成品質だけでなく、誰の声をどの範囲で扱えるかも採否の条件に含めます。
MAI-Voice-2.1の使い方
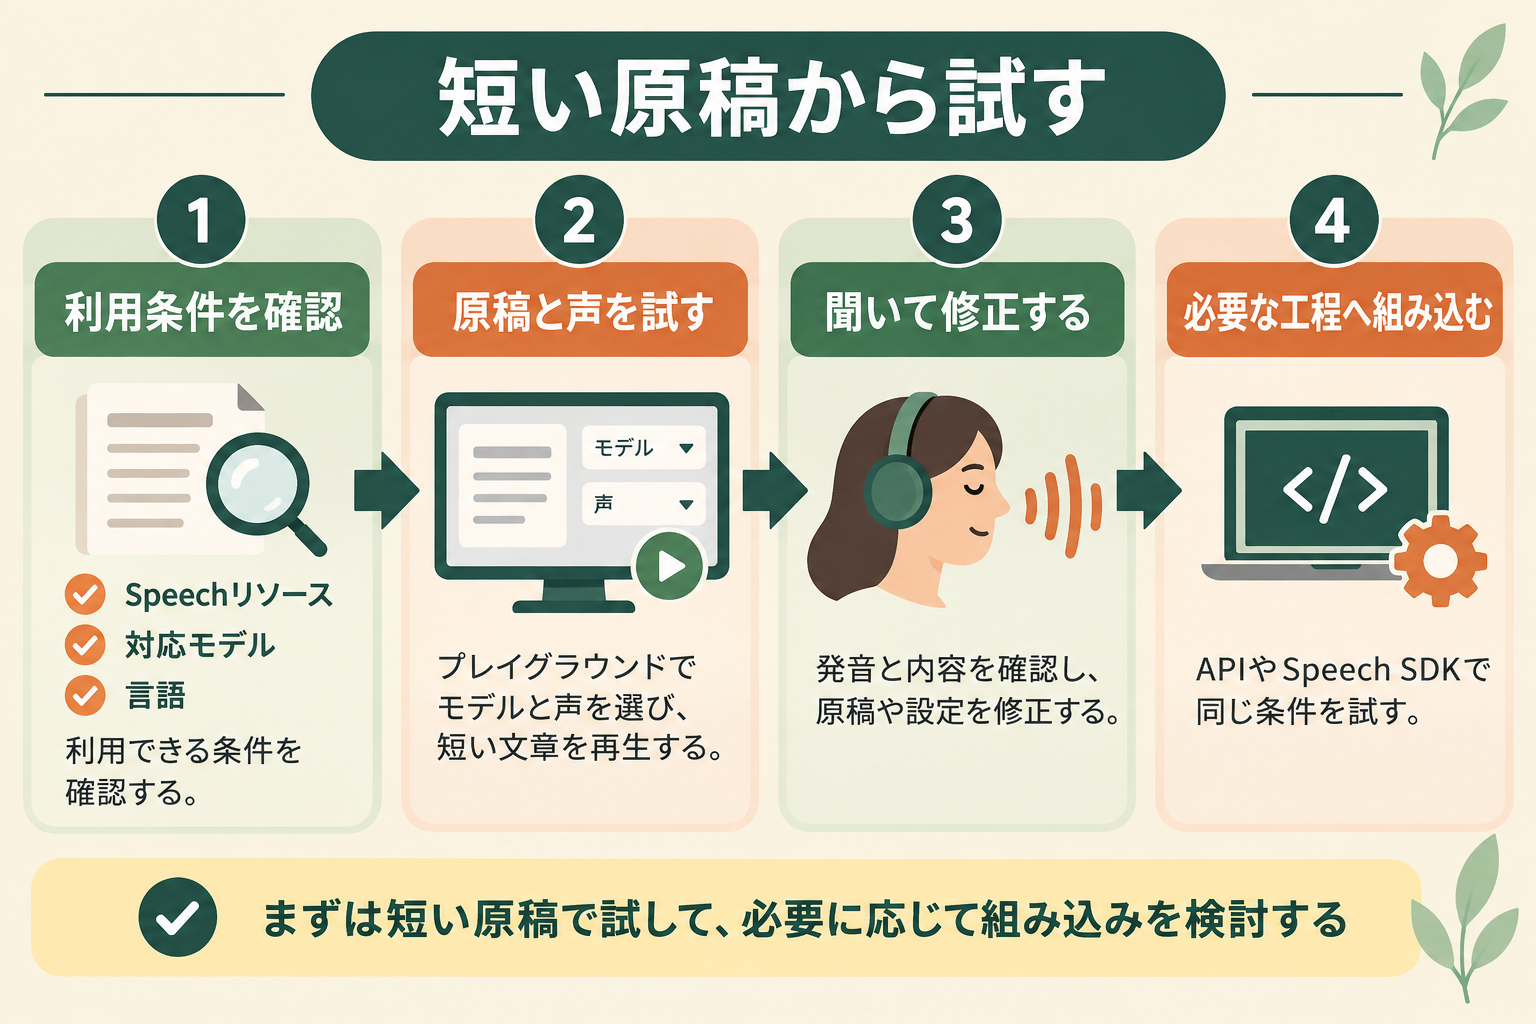
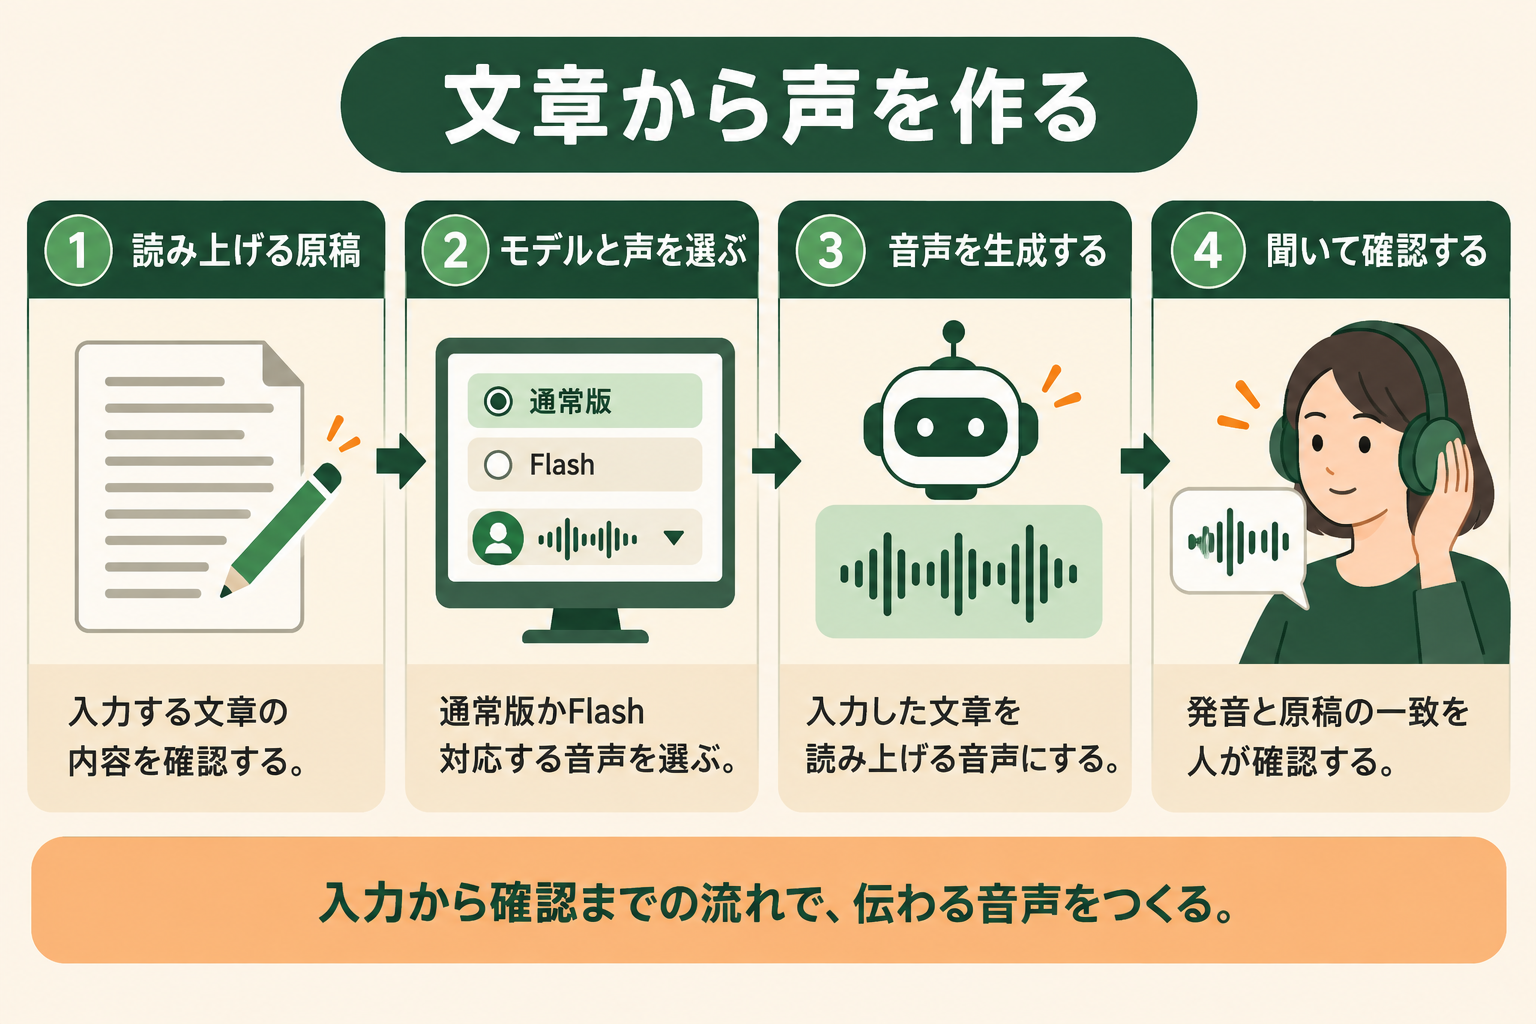
MAI-Voice-2.1は、まずAzure Speechのプレイグラウンドで原稿と声を確認し、その後に必要な利用経路へ組み込むと試しやすくなります。最初から大量の原稿を送らず、判断したい条件を一つずつ確かめます。
Speechリソースと対応するモデルを確認する
最初に、Azureで利用するSpeechリソースを確認します。利用可能なモデル、地域、権限は公式ドキュメントの条件に合わせます。Azureのアカウントを持っていることだけで、どのモデルにもアクセスできるとは限りません。
既存の音声合成を使っている場合も、選択している音声がMAI-Voice-2.1に属するかを見ます。従来の日本語音声が一覧に表示されたことを、MAIモデルが日本語に対応する証拠にしないでください。モデルと音声の組み合わせが確認の単位です。
接続や権限に問題があるときは、音声の品質比較を始める前に、リソースとアクセス条件を切り分けます。必要な申請がある機能は、申請完了前のエラーを生成品質の問題として評価しないようにします。認証情報は原稿や共有資料に貼り付けず、管理された設定で扱います。
最初の確認結果として、リソースの地域、選択モデル、選択音声、試用日を残します。提供条件が更新されたときに、どの環境で試した結果なのかをたどれるようにするためです。公開用の完成物には、こうした内部の接続情報を載せる必要はありません。
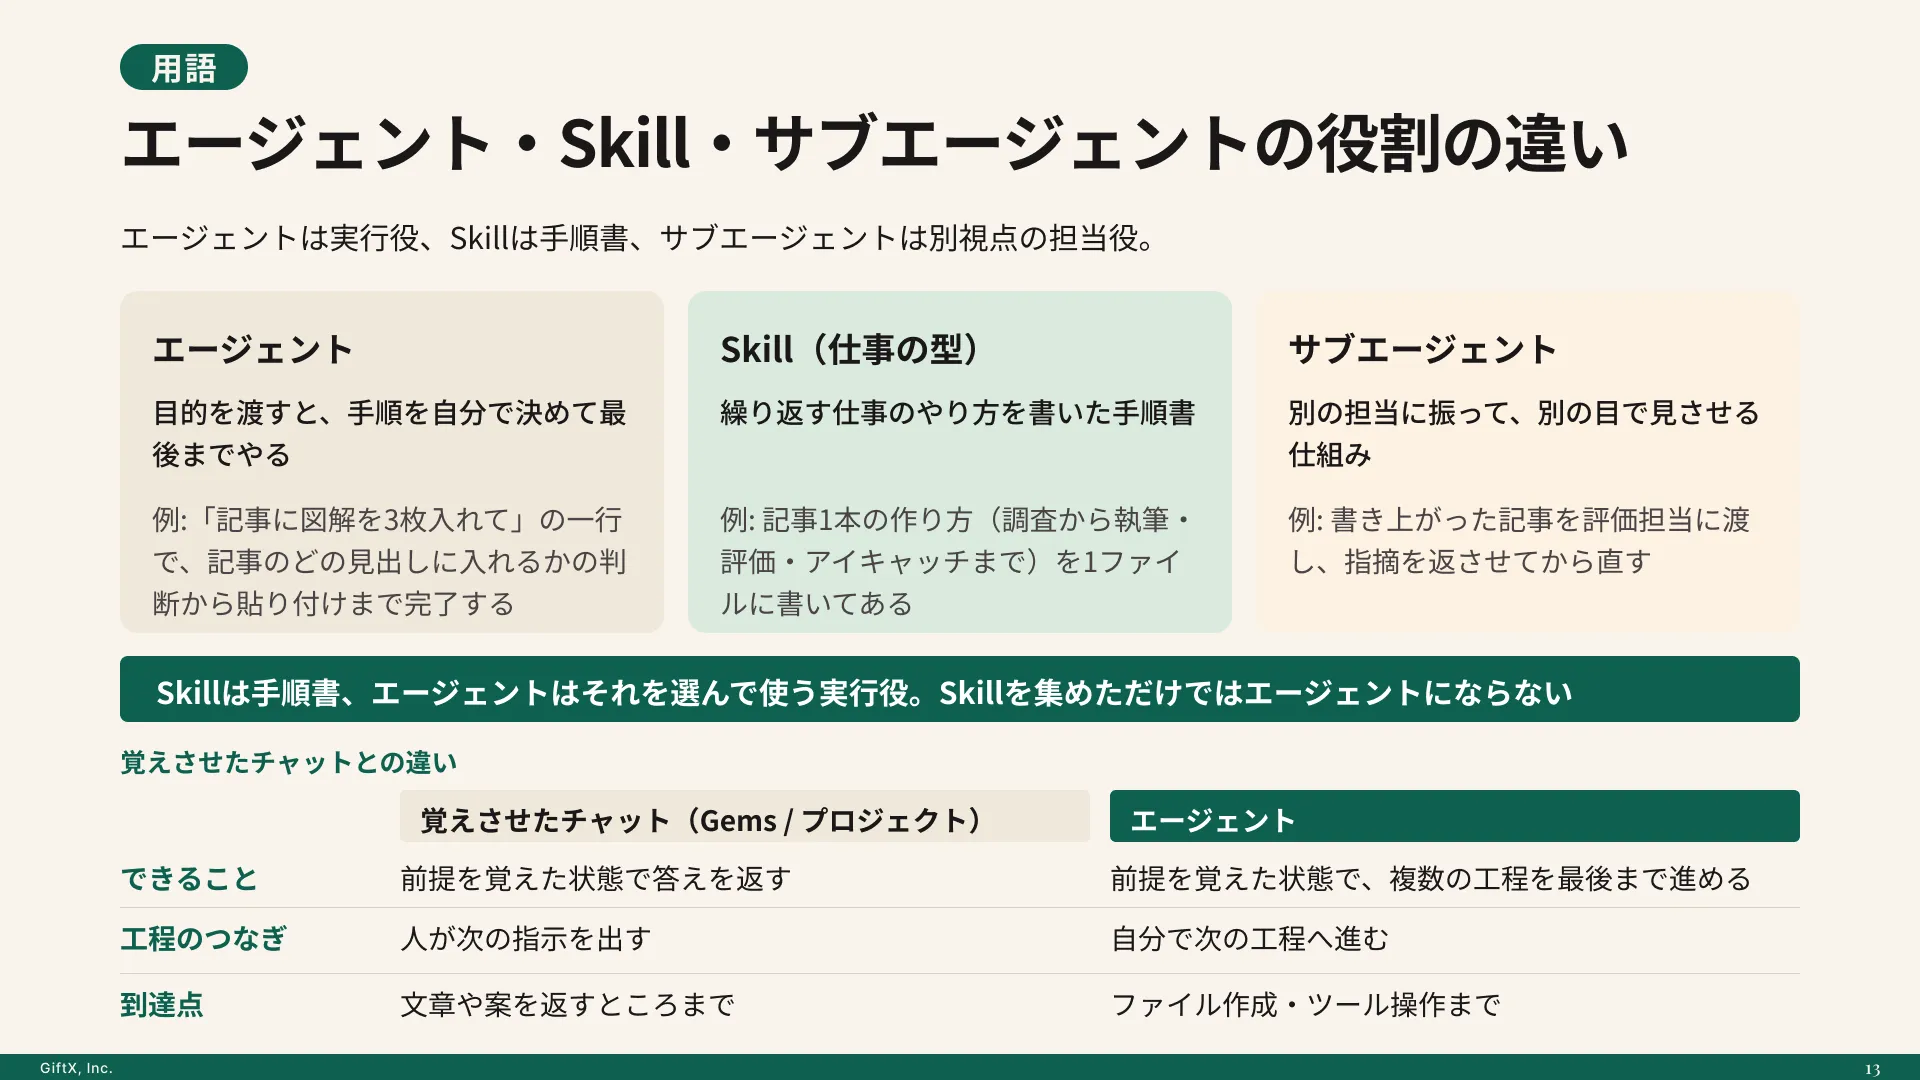
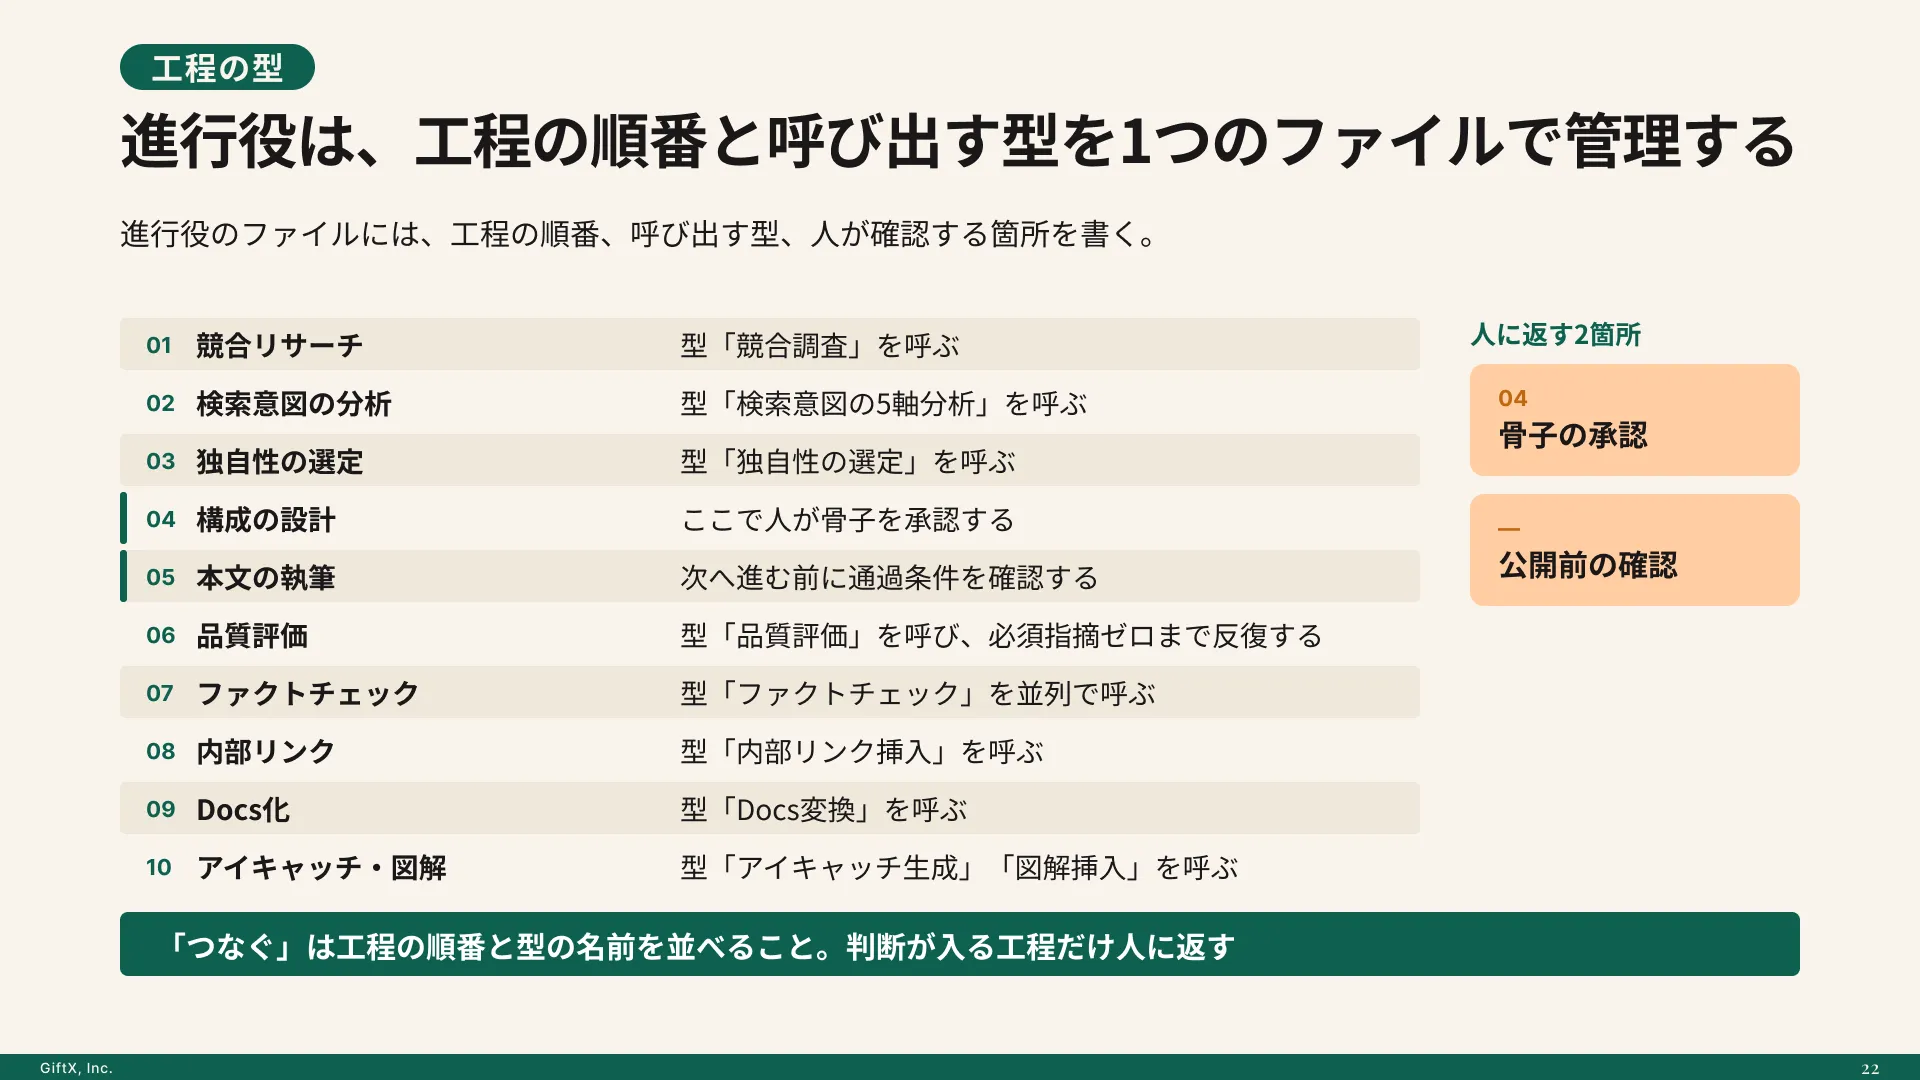
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
プレイグラウンドで原稿と音声を試す
公式ドキュメントが示す経路は、Speechリソースからテキスト読み上げのプレイグラウンドを開き、モデルと音声を選び、文章を入力して再生する流れです。画面の導線が更新された場合は、現在の公式手順に合わせて操作します。
試験文には、実際に使う原稿の短い一節を選びます。数字、固有名詞、長い文など、読み方を確認したい要素が含まれると比較しやすくなります。一般的な挨拶だけで判断すると、完成原稿で問題になる箇所を見落とします。
同じ原稿を、同じ音声条件で通常版とFlashに入力し、発音と待ち時間を確認します。長い原稿が目的なら、短い一節に続いて全体も試し、段落をまたいで声の印象が保たれるかを聞きます。短文の評価だけで採用せず、長文の確認結果も残します。
試用時に保存する情報は、原稿、モデル、音声、表現指定、出力の確認結果です。声が気に入ったという感想だけでは、別の原稿で再現できる条件が残りません。どの語が誤って読まれたか、どの区切りが不自然だったかを具体的に記録します。
出力を聞いて原稿と設定を修正する
生成後は、最初から最後まで聞き、原稿と一致しているかを確認します。文章が抜けていないか、数字が意図した読み方か、固有名詞が伝わるかを見ます。音量や音質だけを確認して、意味の誤りを見落とさないようにします。
読み間違いがある場合は、原稿の表記、区切り、対応する読み上げ指定を順に確認します。修正前後の原稿を残し、どの変更で改善したかを比較します。意味を変える言い換えを行った場合は、音声だけでなく原稿の内容も再確認します。
映像と合わせる場合は、音声が確定してから、画面の表示時間や字幕を調整する流れが考えられます。音声を後から差し替えると、字幕や映像のタイミングにも修正が必要になります。生成後の確認を先に終えておくと、関連する素材を同じ版にそろえやすくなります。
複数人で確認するなら、採用候補と比較用候補を分けて保存します。どれが完成版か分からない状態では、別の音声を映像に使う事故につながります。音声ファイルの名称と原稿の版を対応させ、確認した人と確認日を残す運用を提案します。
APIやSpeech SDKで生成工程を組み込む
プレイグラウンドで条件を確認した後、同じ内容をAPIやSpeech SDKの利用経路で試します。APIはアプリから機能を呼び出す窓口、SDKはその実装を助ける開発用の道具です。画面での試用が成功しても、アプリの認証や設定まで自動で完成するわけではありません。
公式例では、モデルを含む音声名としてen-US-Harper:MAI-Voice-2.1が示されています。音声名の前半は声や言語の指定、後半はモデルの指定として確認します。別の音声へ置き換える場合は、公式に案内された組み合わせを使います。
組み込み時は、原稿の受け渡し、生成結果の保存、エラー時の扱いを決めます。途中で失敗した原稿をどう再試行するか、すでに確認済みの音声を再生成しないかも検討します。これらは制作側の設計であり、モデルが一式を代行するという説明ではありません。
認証情報を本文や画面に表示しないことに加え、入力した原稿と出力ファイルを誰が閲覧できるかを確認します。試験用の短い原稿で処理をつなぎ、品質と保存先を確認してから対象を広げる進め方が適しています。
MAI-Voice-2.1の料金
MAI-Voice-2.1の公式料金は文字数単位で案内され、通常版とFlashで単価が異なります。月額の座席契約や、音声の再生時間に対する料金と区別します。
通常版とFlashの文字数単位の価格
Microsoftの公式発表では、通常版は100万文字あたり22米ドル、Flashは100万文字あたり15米ドルです。比較する際は、同じ文字数を生成する条件にそろえます。日本円で支払う額は、為替、税、契約条件なども関わるため、この単価だけでは確定しません(2026年10月時点)。
下表は、通常版とFlashの料金単位と提供段階を整理したものです。価格差だけで選ばず、長いナレーションの安定性と、音声が返るまでの速さのどちらが必要かに合わせて比較します(2026年10月時点)。
| 比較項目 | MAI-Voice-2.1 | MAI-Voice-2.1-Flash |
|---|---|---|
| 公式発表の単価 | 22米ドル/100万文字 | 15米ドル/100万文字 |
| 主な選択軸 | 長文での表現の安定性 | 応答の速さ |
| 提供段階 | Public Preview | Public Preview |
| 本番利用の判断 | 公式のPreview条件を確認 | 公式のPreview条件を確認 |
通常版とFlashの価格は、Microsoftの公式発表に基づきます。提供条件はMAI voicesの公式ドキュメントで確認します。単価の案内と、試用段階の保証条件は別の情報です。
生成し直す回数も含めて費用を見積もる
費用を見積もるときは、完成原稿の文字数だけでなく、試用や修正で生成する文章も数えます。採用音声が一つでも、複数候補を生成すれば入力量は増えます。利用経路の課金集計と照合し、表示単価から推定した額だけで判断しないようにします。
試算の基本は、対象文字数を100万文字単位に換算し、モデルの単価を掛ける考え方です。ただし、実際の集計方法、無料枠の適用、契約による価格は利用条件を確認します。この記事は請求額を保証するものではありません。
予算が限られる場合は、読み方を確認したい短い一節で条件を決め、その後に全体を生成する進め方が考えられます。修正のたびに完成原稿すべてを生成する方法と比べて、不要な試用を減らすための設計です。実際にどれだけ変わるかは原稿と確認方法によります。
速度を比較する検証と、聞きやすさを比較する検証も分けます。待ち時間だけを測るために大量の原稿を送り、その結果を完成音声として使わない場合は、検証自体が利用量になります。何を確認するための生成かを事前に決めておくと管理しやすくなります。
MAI-Voice-2.1とFlashの違い
MAI-Voice-2.1とFlashは、長い音声の表現と、応答の速さに対する重点が異なります。速いモデルがすべての用途で適するとも、通常版がすべての条件で優れるとも判断しません。
長い原稿と応答の速さを別々に評価する
通常版を検討するときは、文章の途中で声の印象が変わらないか、段落をまたいで聞きやすいかを確認します。まとまったナレーションでは、冒頭だけでなく中盤や最後も聞く必要があります。編集でつなぐ場合は、別々に生成した区間の違いも見ます。
Flashを検討するときは、入力から音声が届くまでの待ち時間が、作りたい体験に合うかを確認します。短い発話を繰り返す場面では、最初の音が遅いと全体の使い心地が変わります。完成ファイルの長さだけでは、この待ち時間は分かりません。
下表は、使う原稿と確認方法の対応を整理したものです。比較条件をそろえ、品質と速度をそれぞれ記録します。用途に必要な基準を満たすかを見てから、料金の違いを判断します。
| 確認すること | 通常版を試す場面 | Flashを試す場面 |
|---|---|---|
| 長い原稿の安定性 | 全体を通して声を聞く | 同じ原稿で表現を比較する |
| 最初の音までの待ち時間 | 待ち時間が許容できるか見る | 速さが必要な条件で測る |
| 固有名詞の読み方 | 試験文で確認する | 同じ試験文で確認する |
| 費用との釣り合い | 品質の基準と単価を見る | 速度の基準と単価を見る |
公式の速度指標と実際の待ち時間を分ける
Microsoftのモデルページは、通常版とFlashの推論遅延について約550ミリ秒、約45ミリ秒という指標を案内しています。これは公式が示す測定条件の値であり、インターネット越しのアプリで必ず同じ待ち時間になるという説明ではありません。
推論に要する時間、最初の音が届く時間、音声全体が生成される時間は別の指標です。ネットワーク、入力の長さ、アプリ側の処理も利用者が感じる待ち時間に関わります。異なる指標をまとめて「音声がすべて完成する時間」と呼ばないようにします。
速度の根拠は、MAI-Voice-2.1の公式モデルページです。自身の比較では、測定の開始点と終了点を決め、同じ原稿と利用経路で確認します。公式評価と実環境の測定を分けて記録すれば、判断の範囲が明確になります。
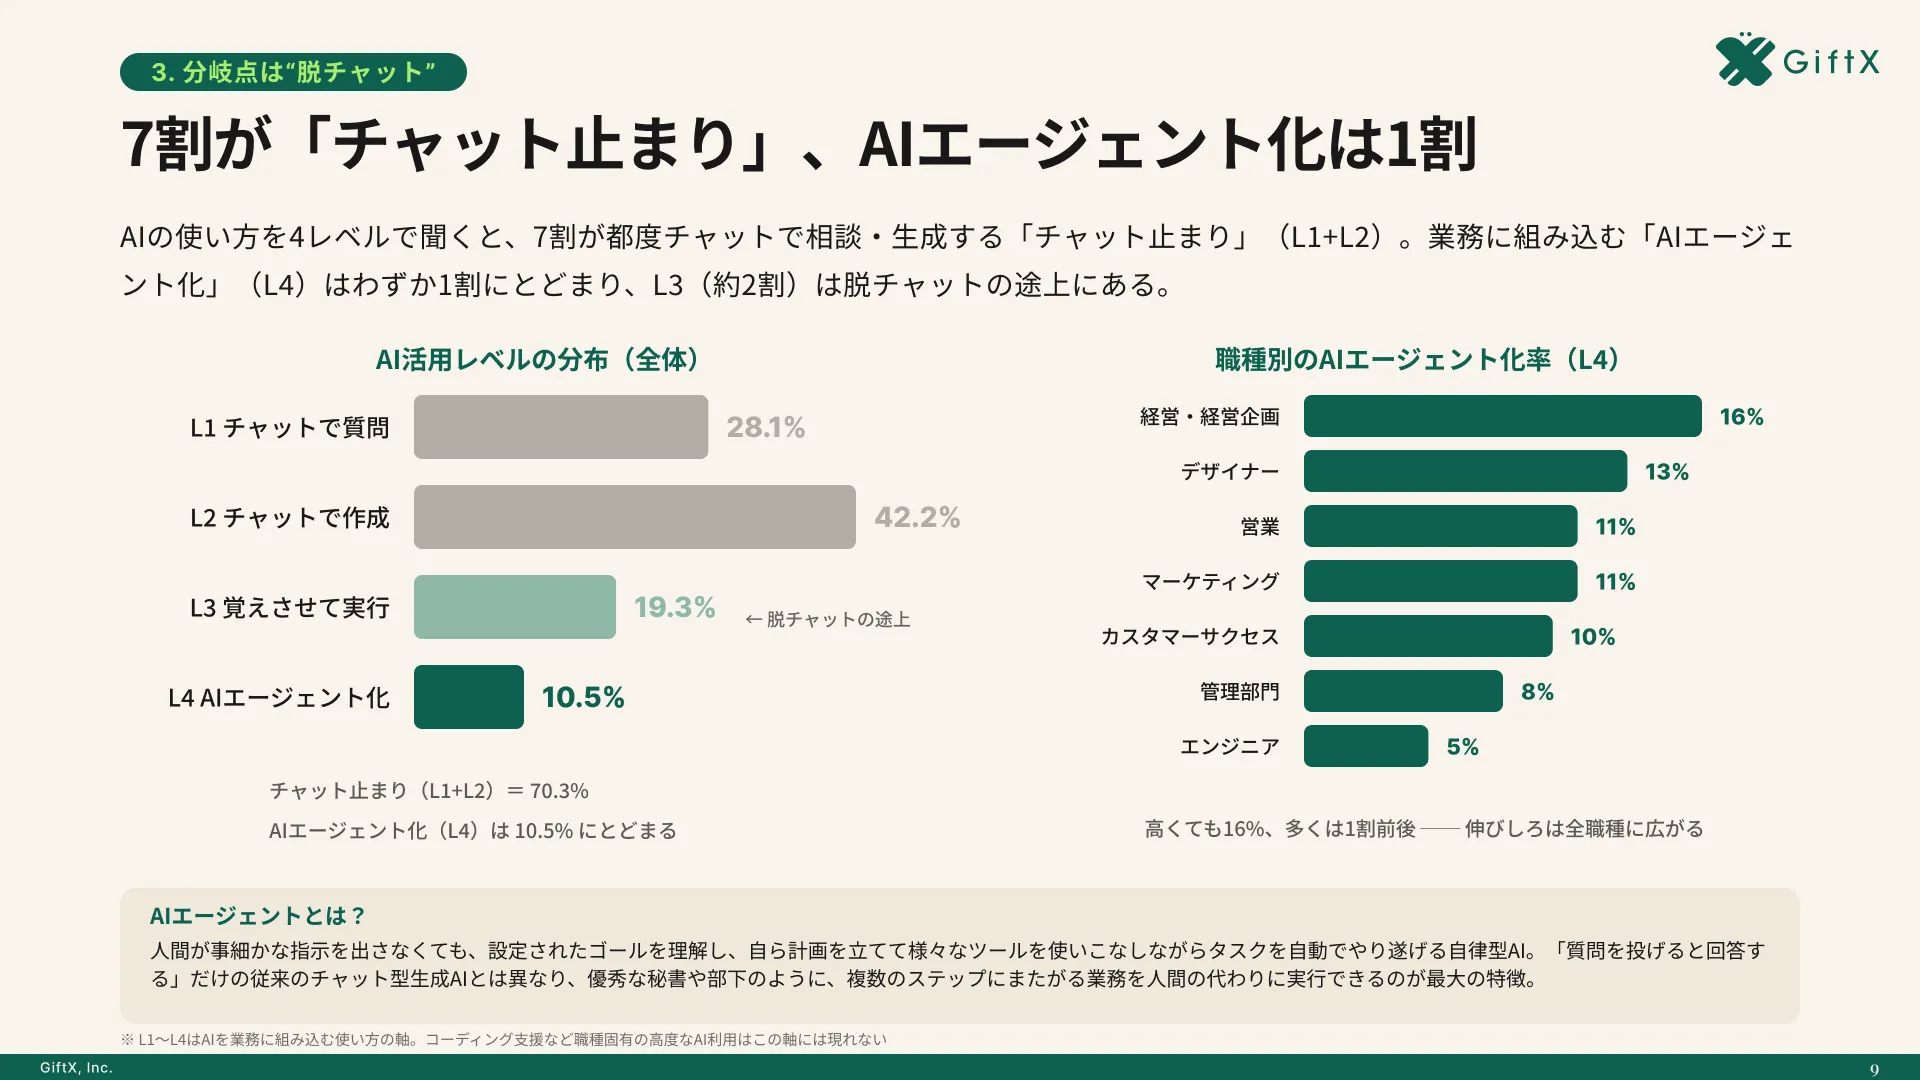
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
MAI-Voice-2.1の日本語対応
MAI-Voice-2.1の公式対応言語一覧では、2026年10月時点で日本語の対応を確認できません。日本語が必須の制作では、対応の明記を確認してから候補に入れます。
言語数やAzureの地域から対応を推定しない
23言語、26ロケールという総数には、何が含まれるかという一覧の確認が必要です。対応言語が多いことだけを理由に、日本語も使えると判断しないでください。最新の一覧に対象の言語・ロケールがあるかを確認します。
AzureのJapan Eastなどの地域名は、サービスを提供する場所に関わる設定です。地域名にJapanが含まれることと、モデルが日本語を読み上げることは別です。提供地域と対応言語を別々の欄で記録すると、この混同を防ぎやすくなります。
既存の日本語音声とMAIモデルを区別する
Azure Speechには別系統の日本語音声もあります。既存の日本語音声を利用できることは、MAI-Voice-2.1に同じ対応があることを意味しません。音声名、モデル名、対応言語の三つが一致するかを確認します。
判断の根拠は、MAI voicesの公式一覧と公式モデル情報です。今後一覧が更新された場合は、変更後の条件で改めて試用します。現時点で確認できない機能は、制作計画の必須条件に含めません。
関連記事:Gemini TTSとは?3.8 Flash TTSの声の設計・料金・日本語での使い方
MAI-Voice-2.1を使う音声制作の例
MAI-Voice-2.1を制作に組み込む場合は、原稿、音声、映像を別の成果物として扱い、それぞれの確認を終えてから組み合わせる設計が考えられます。
説明原稿を音声にして映像へ組み合わせる
以下は、音声合成・動画制作ツールを使った制作工程をもとにした仮想例です。MAI-Voice-2.1を使った実績や、処理時間の測定結果を紹介するものではありません。モデルを置き換える場合の確認工程を考えるために使います。
まず、説明したい内容を原稿にし、事実と構成を確認します。次に、対応する言語と音声で読み上げを生成し、発音と原稿の一致を聞いて確認します。採用音声を決めた後、映像やスライドの表示時間を合わせ、字幕とともに完成物を見直します。
この例では、音声生成が映像の編集を代行するわけではありません。音声の差し替えで字幕や表示時間が変わるため、採用原稿と音声を先にそろえることが工程の要点です。クローン音声を使う場合は、原稿を生成する前に同意と利用条件を確認します。
一つの短い説明を完成させ、その工程を次の原稿へ展開する進め方が考えられます。修正回数、確認にかかった時間、残った読み間違いを記録すれば、生成の速さだけでは見えない制作の負担も比較できます。数値は実際に測り、仮想例から成果を断定しません。
MAI-Voice-2.1で声を扱う注意点
MAI-Voice-2.1を使う際は、声の同意、アクセス申請、入力原稿と出力音声の管理を確認します。音声が生成できることだけで、使用範囲まで決まるわけではありません。
同意の範囲とクローンの申請を確認する
声の本人に対する説明と、サービス側のアクセス申請は別の確認です。本人の了解があっても利用申請が不要になるとは限らず、申請が認められても本人の同意を省けません。公式条件と制作側の確認を両方そろえます。
同意を取るときは、読み上げる内容、公開先、使う期間、変更時の確認方法を具体的にします。別の原稿や別の公開先へ広げる場合は、当初の了承に含まれるかを確かめます。本人に分かる言葉で説明し、後から確認できる形で残す運用を提案します。
保存・閲覧・公開の条件を分けて確認する
原稿、サンプル音声、生成音声は別のデータです。誰が閲覧するか、どこへ保存するか、いつ削除するかをそれぞれ確認します。サービスの設定と、完成音声を公開する先の規約も別の条件として扱います。
第三者の声や原稿を扱う場合は、利用する権利と公開する範囲の確認が必要です。本記事は、すべての出力を無条件で商用利用できると保証しません。利用予定の内容と契約条件を照合し、判断がつかない素材は試用対象に含めないようにします。
音声コンテンツをAIで内製するときに陥りがちな3つの落とし穴
音声生成を制作へ組み込む際は、ツールの操作だけでなく、原稿と完成音声を確認する担当と手順を先に決めます。
GiftXのビジネス職生成AI活用実態調査(2026年版)では、AI活用の課題として成果物の品質を挙げた回答は27.4%で、これは複数回答の調査値でありMAIモデルの評価ではありません。
外注は単価が高く本数を増やせない
制作本数を増やすと、原稿、収録、編集の調整が増えます。音声生成を使う場合も、確認に必要な時間までなくなるわけではありません。どの工程を自分たちで担い、どこで専門的な確認を受けるかを決めます。
社内に書ける人がおらず兼任では回らない
読み上げる声だけを用意しても、内容を伝える原稿は必要です。兼任で制作する場合は、原稿の構成、用語の表記、確認の担当を型として残すと進めやすくなります。音声の生成条件と合わせて、完成までの手順を共有します。
AIツールだけではそのまま出せる品質に届かない
音声が自然でも、説明の誤りや固有名詞の読み間違いが残る場合があります。読み間違いと内容の誤りを別々に記録し、修正後の原稿と音声を照合します。
まず1コンテンツを型にする
まず1コンテンツを型にすることを出発点に、原稿と音声を確認する基準を決めます。一つの原稿について、確認する人、採用基準、修正後の再確認までを決めてから本数を増やします。生成の速さだけで工程を短縮せず、原稿・音声・映像を同じ版にそろえる手順を共有すると、担当が変わっても確認を続けられます。制作全体の設計を進める際は、GiftXのAI活用コンテンツ制作支援で相談できます。
MAI-Voice-2.1のよくある質問
MAI-Voice-2.1を選ぶ前に、対応言語、モデルの使い分け、声のクローン、提供段階を確認しておくと試用の条件を決めやすくなります。
日本語のナレーションを作れますか
2026年10月時点では、MAI-Voice-2.1の公式対応言語一覧で日本語を確認できません。Azureの日本語音声全般とMAIモデルを区別し、対象モデルの一覧を根拠にしてください。日本語が必須なら、対応が明記された音声を候補にします。
通常版とFlashはどちらを選べばよいですか
長いナレーションの表現を重視するなら通常版、応答の速さを重視するならFlashを試す候補にします。同じ原稿で音声を聞き、実際の利用経路の待ち時間も確認してください。単価だけで一方を選ぶと、用途に必要な条件を見落とします。
本人の声を登録すればすぐに使えますか
声のクローンには、本人の同意とサービス側のアクセス条件を確認する必要があります。サンプル音声の長さだけで利用できると判断しないでください。標準の音声を使う試用と、クローンの登録は別の操作です。
MAI-Transcribeと同じ機能ですか
MAI-Voiceは文章を音声へ変換する音声合成、MAI-Transcribeは音声を文章へ変換する音声認識です。映像制作で両方を使う設計は考えられますが、入力と出力は逆です。一方の対応言語を、もう一方の対応として読み替えないでください。
Previewのまま本番へ組み込めますか
公式ドキュメントではSLAの対象外で、本番利用を推奨していません。試用結果だけで継続提供の保証を判断せず、提供段階と契約条件を確認してください。一般提供の予定を推測して、利用が必須の工程を組むことは避けます。
MAI-Voice-2.1のまとめ
MAI-Voice-2.1は、文章から多言語の音声を作るモデルです。通常版は長文の安定した表現、Flashは応答の速さを選択軸にし、同じ原稿で発音と待ち時間を確認します。
日本語は公式一覧で対応を確認できず、両モデルはPublic Previewです。声のクローンには同意とアクセス条件の確認も必要です。料金、言語、利用条件をそろえ、試験用の短い原稿から判断すると進めやすくなります。採用後も原稿と音声を照合し、公開する範囲を確認してください。
音声コンテンツの制作を具体的に進めたい方へ
AIで音声を生成できても、公開するコンテンツには原稿、発音の確認、映像との調整が必要です。どの工程を自動化し、どこで人が確認するかを決めると、次の制作にも使える手順が残ります。
まずは一つの原稿で、生成から完成までの流れを確認してみてください。制作工程の設計や内製化を進める際は、GiftXのAI活用コンテンツ制作支援で、対象コンテンツと体制に合わせた進め方を相談できます。
▶ GiftXのAI活用コンテンツ制作支援の詳細・お問い合わせはこちら