Jevとは?ソフトウェアに型付きの判断を返すAIモデル
Jevとは、文章ではなく型付きの判断と確率を返す、TypeSafe AIのAIモデルです。
TypeSafe AIは、ソフトウェア内の素早い判断に使うモデル群を「System One Models」と呼び、Jevをその最初のモデルと位置づけています。チャット画面で完成した回答を読むより、既存システムの途中に判断処理を組み込むための技術と捉えると分かりやすくなります。
入力情報を読み、事前に決めた形式で答える
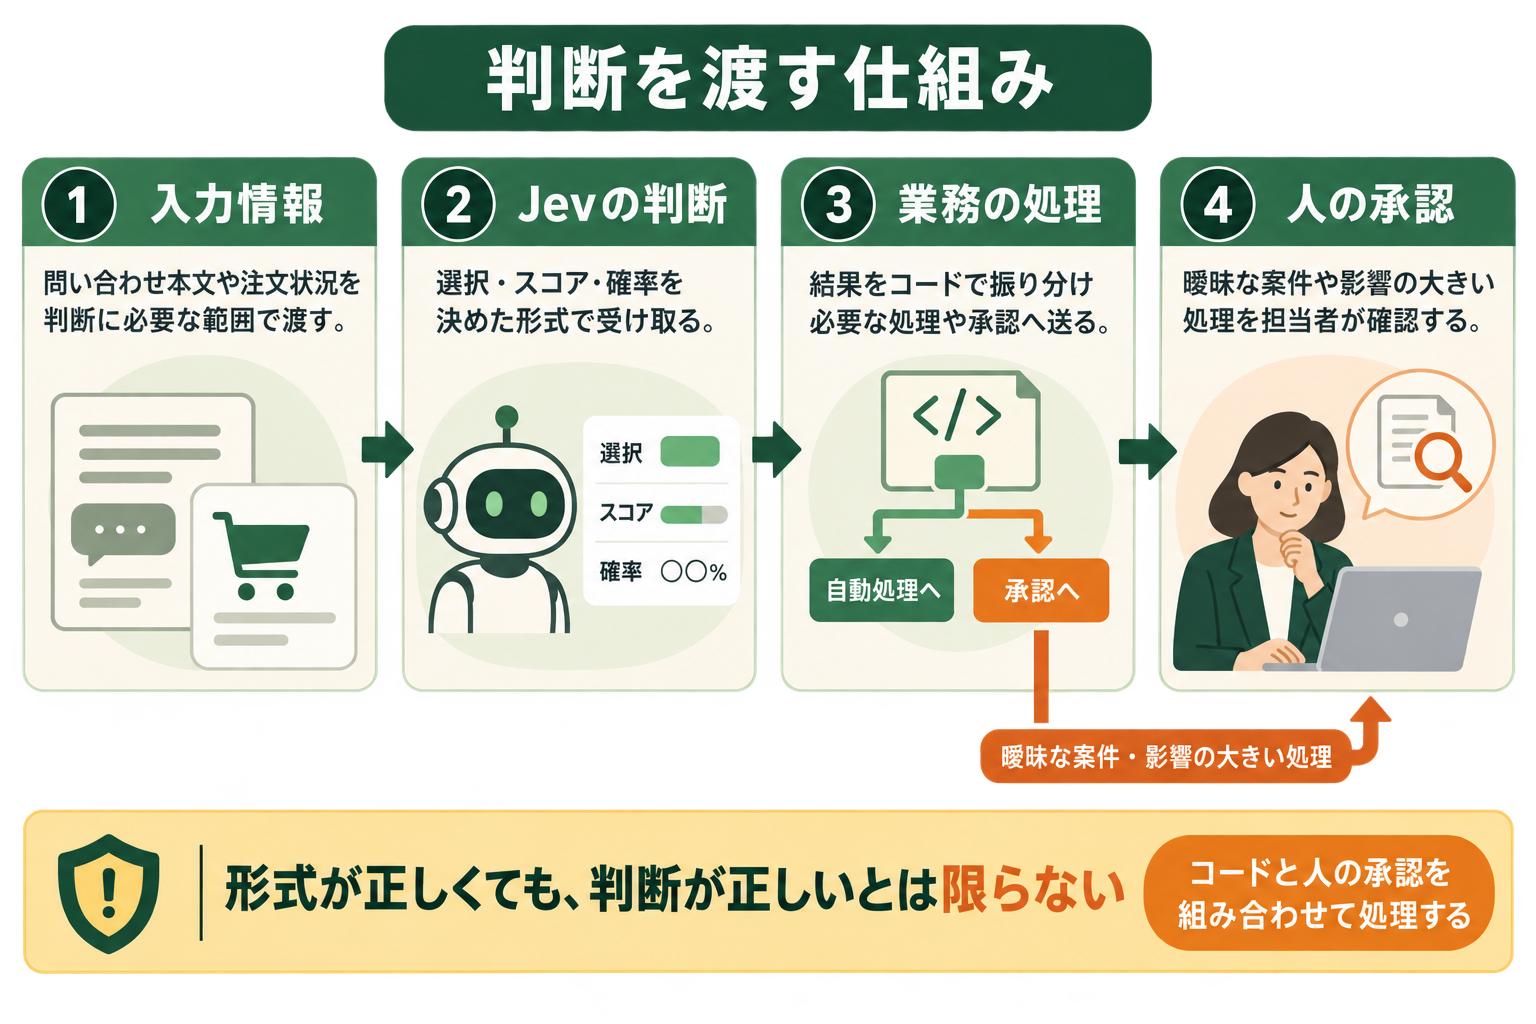
Jevには、判断材料となるstateと、何を評価するかを定めたquestionsを渡します。例えば問い合わせ本文と注文状況を材料に、「どの担当窓口へ送るか」を質問する形です。戻り値の形式を先に定めるため、結果を受け取ったプログラムが次の処理を選びやすくなります。
ここでいう「型」は、回答の入れ物に関する約束です。担当窓口なら用意した候補からの選択、緊急度なら定義した尺度上の数値といった形になります。自由な文章の中から結論を探して読み取る工程を減らし、条件分岐や並べ替えへ結果を渡せる点が特徴です。
利用には、ソフトウェア同士を接続するAPI(Application Programming Interface)が中心になります。Jevだけで問い合わせ管理画面や承認フローが完成するわけではありません。データの取得、権限の確認、処理の実行は周囲のシステムが担います。入力と出力の考え方は公式Introductionに示されています。
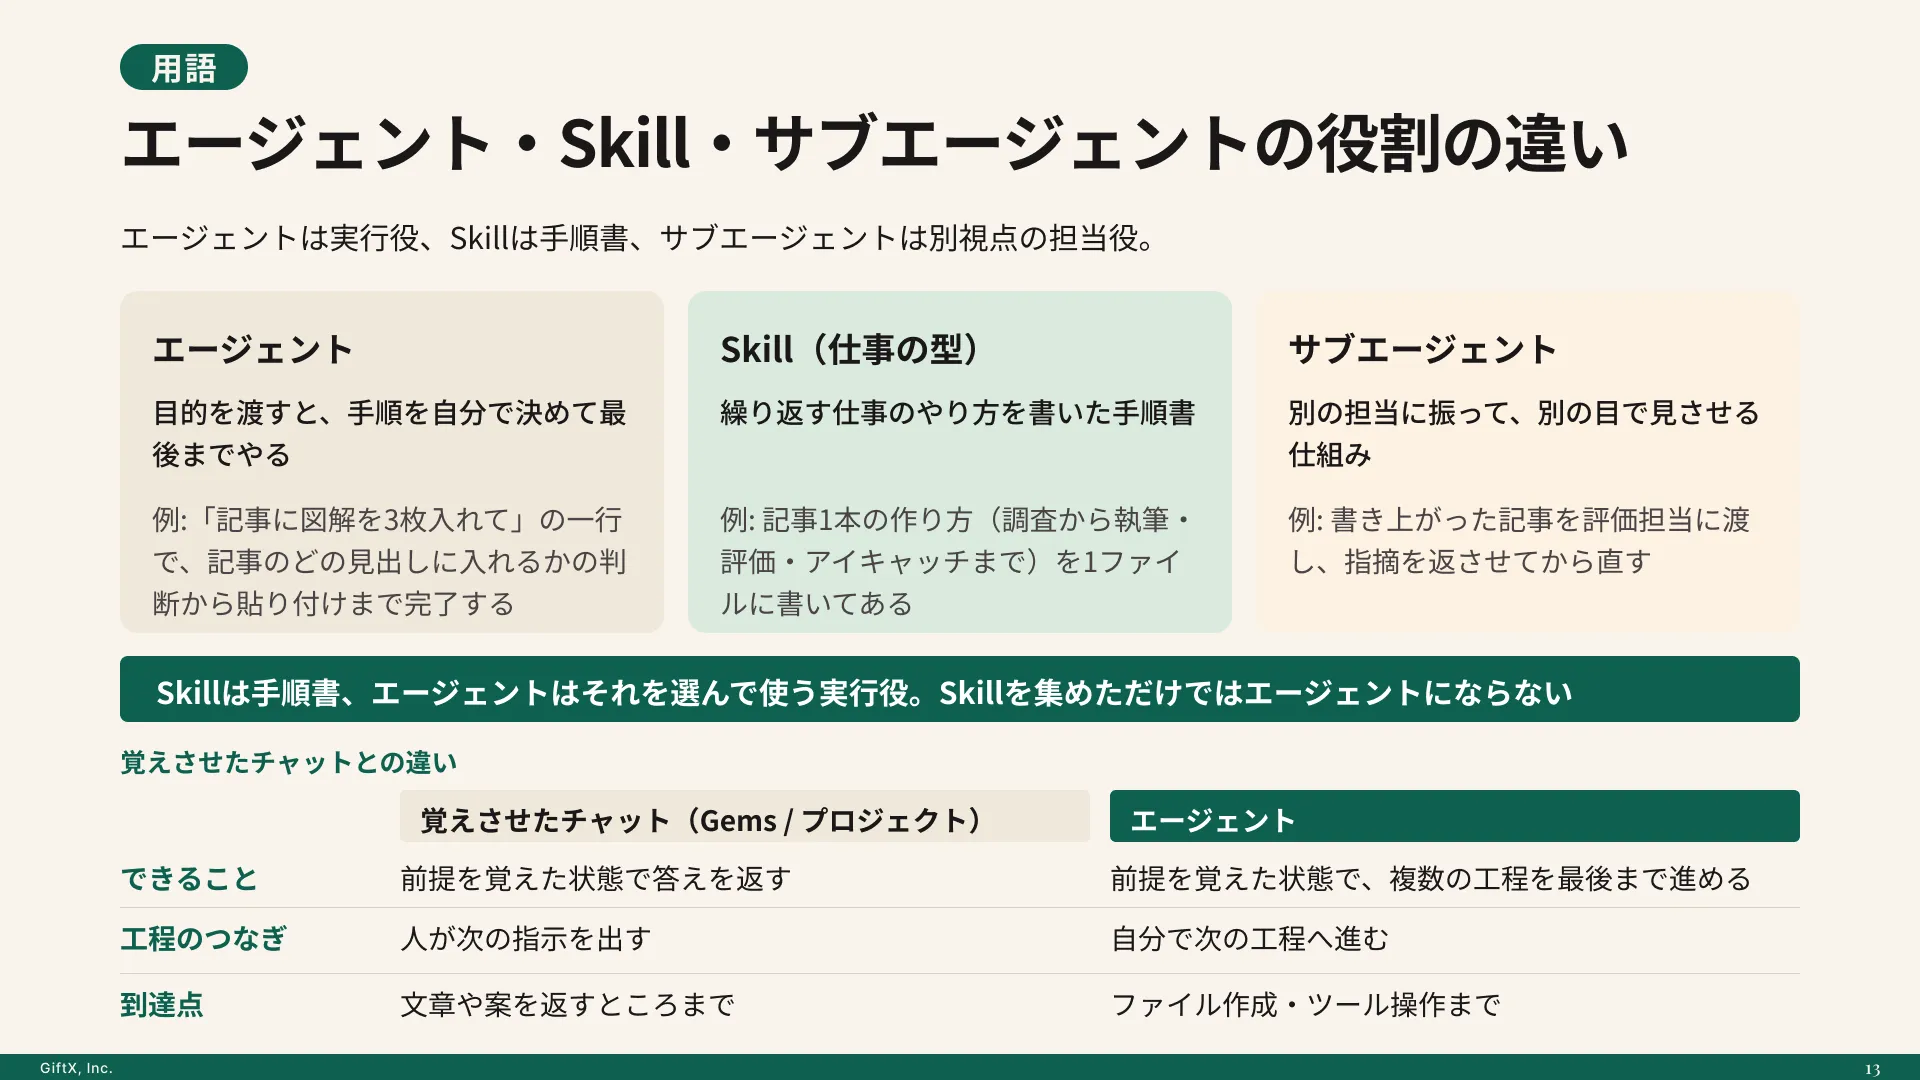
LLMやAIエージェントとの違い
JevとLLM(Large Language Model、大規模言語モデル)は、どちらも入力の意味を扱うAIですが、出力と使いどころが異なります。下表では、主な出力・用途・業務内の役割から違いを整理します。文章を作る工程と、判断を次の処理へ渡す工程を分けて考えると、自社システムへの配置を検討しやすくなります。
| 観点 | Jev | LLM | AIエージェント |
|---|---|---|---|
| 主な位置づけ | 判断を返すモデル | 文章などを生成するモデル | モデルとツールを組み合わせて業務を進める仕組み |
| 出力・処理 | 選択、スコア、確率など | 回答文、要約、コードなど | 検索、下書き、記録など複数の処理 |
| 問い合わせでの役割例 | 担当分類や緊急度の評価 | 回答文の下書き | 情報取得から下書き・承認依頼までの連携 |
| 別途必要な設計 | 判断基準と結果の利用ルール | 出力の検証と利用ルール | 実行権限と承認・例外処理 |
例えばJevが問い合わせを分類し、LLMが返信案を作り、人が送信を承認する構成が考えられます。Jevはエージェント内の判断部品になり得ますが、文章生成や業務全体の制御をそのまま置き換えるものではありません。
LLMにも構造化出力を返す機能があります。そのため「LLMは形式を指定できない」という比較は不正確です。Jevの特徴は、自由文の生成を目的とせず、型付きの判断をソフトウェアで使うことに設計を絞っている点にあります。導入判断では、出力形式だけでなく自社の質問に対する精度や処理時間も比べます。
関連記事:AIエージェントとは?生成AI・チャットボットとの違い、仕組み・導入方法を解説
「ハルシネーションなし」と判断ミスは別に考える
ハルシネーションは、AIが根拠のない内容を事実らしく出す現象を指します。TypeSafe AIがJevについて強調する保証は、出力が定義したスキーマ、つまりデータ構造に一致することです。公式発表の型安全性に関する説明も、スキーマ一致が保証される点を根拠にしています。
選択肢として「返品」「配送」「請求」を渡せば、指定外の名称を勝手に作らないことと、実際の問い合わせを正しい窓口へ振り分けることは別です。「配送」が正解なのに「返品」を選んでも、形式の約束は守れています。
また、型が正しくても、入力の注文情報が古ければ業務上の判断は外れます。形式の検査だけで本番運用を許可せず、判断内容と後続処理の両方を評価する必要があります。
関連記事:ハルシネーションとは?意味・原因・対策と生成AIを安全に使うコツ
Jevの仕組み|Choice・Score・Noulを組み合わせる
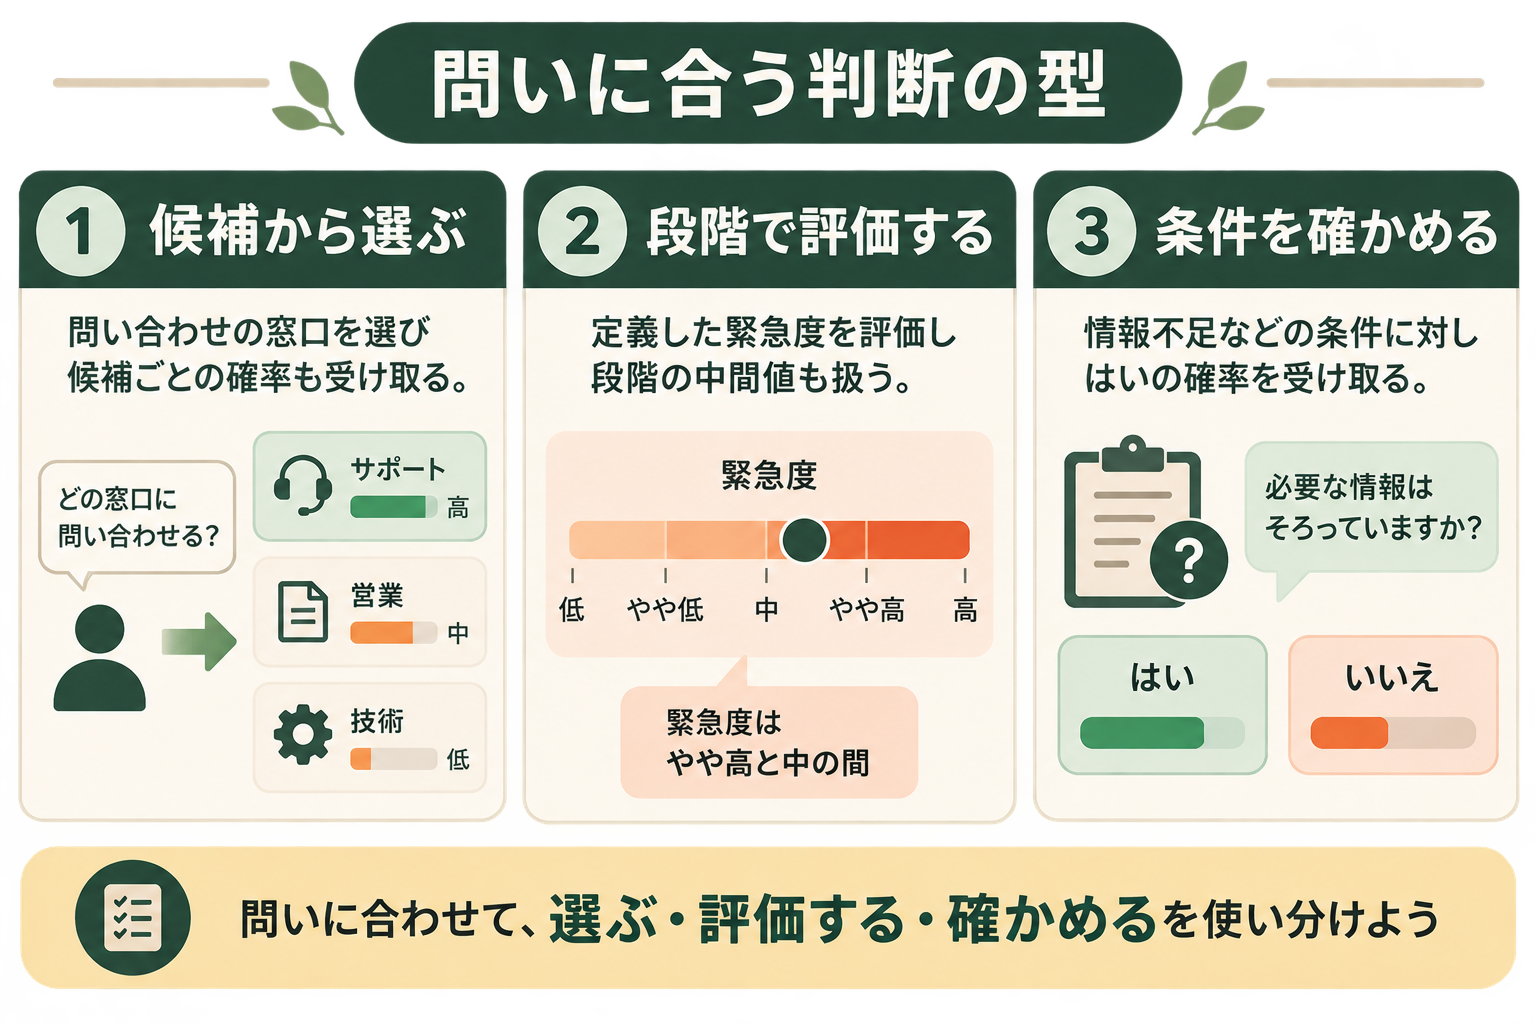
Jevには、質問に応じて使い分けるChoice・Score・Noulという型があります。同じ情報から何を取り出したいかを先に決め、適した型へ質問を分解します。
Choiceは候補の中から選ぶ
Choiceは、用意した選択肢の中から1つを選ぶ質問です。回答には、選択結果のchoice、各候補の確率を表すprobabilities、確信度のconfidenceが含まれます。担当窓口や問い合わせ種別など、候補間に順序がない分類で使います。
選択肢の説明が重なっていると、同じ内容が複数の候補に当てはまります。「返品」と「返金」を別にするなら、商品の返送希望と支払いの取り消し希望を区別する基準が必要です。Choiceの公式ガイドでは、候補が全入力をカバーできない場合に「その他」などを加える考え方も示されています。
Scoreは定義した段階に沿って評価する
Scoreは、順序のある評価基準に沿って数値を返します。例えば緊急度を「通常」「早めの確認が必要」「対応が止まっている」という段階で定める使い方です。回答にはscore、各段階のprobabilities、confidenceが含まれます。
スコアは各段階の番号を確率で重み付けした値で、段階の中間値も取ります。単に「重要度を採点して」と頼むより、各段階に当てはまる状態を文章で定義するほうが評価軸を共有できます。詳しい仕様はScoreの公式ガイドで確認できます。
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
Noulは「はい」の確率を返す
Noulは、はい・いいえで答えられる問いに対し、「はい」である確率を0〜1のnoulとして返します。「この文章は返金を求めているか」のように、1つの条件の有無を扱う型です。ChoiceやScoreと異なり、別のconfidenceは返しません。
0に近い値は「いいえ」、1に近い値は「はい」に寄った評価です。0.5付近は双方に近い確率であり、例えば「顧客の満足度が中程度」という意味ではありません。程度を測りたい場合はScoreを使います。この区別はNoulの公式ガイドでも説明されています。
質問は独立させ、結果をコードで組み合わせる
複数の質問は、同じstateに対して並列・独立に評価されます。1回の呼び出しにまとめても、ある質問の回答を別の質問が読んで判断する仕組みではありません。「窓口が返品なら次に何をするか」といった分岐は、結果を受け取った側のコードで組み立てます。
この性質を踏まえると、「問い合わせを適切に処理して」という大きな依頼を渡すより、「どの種別か」「緊急性があるか」「追加情報が不足しているか」に分ける設計が適しています。業務ルールを変える場合も、どの質問や条件を直すべきか追いやすくなります。
Jevの料金・速度と評価結果の読み方
Jevの料金や性能は、提供段階と測定条件を合わせて確認します。2026年9月18日の公式表示では早期アクセスとして案内され、サイトにはWaitlistへの登録導線があります。登録すれば即時に利用できるとは断定できません。
入力と出力の料金体系
公式に示された料金は次のとおりです(2026年9月時点)。(出典: typesafe.ai)トークンは入力する文章などを処理する単位であり、文字数と同じではありません。
| 課金対象 | 公表料金 | 見積もり時の確認点 |
|---|---|---|
| 入力 | 100万トークン当たり0.042米ドル | 判断材料と質問を含む実際の入力量 |
| 出力 | 無料 | 連携先システムや他モデルの費用は別途確認 |
モデル利用料に加え、接続先の利用料や実装・監視の工数も費用に含めます。まず対象業務の件数と1件当たりの入力量を測り、モデル利用料と運用全体の費用を分けて見積もります。
「193.6倍高速・444.6倍低コスト」の適用範囲
TypeSafe AIは、特定のSystem One向けワークフロー評価から、193.6倍高速・444.6倍低コストという比較を掲げています。これは、あらゆるLLM処理や自社業務で同じ差が出る保証ではありません。入力の長さ、問いの構成、比較モデルの設定などで結果は変わります。
同社のWorkflow evalsでは、基準となる回答に大型モデル2種の回答の平均を使っています。人手で確定した正解への一致率ではなく、その基準との比較です。評価用ワークフローを作ったのも提供企業側であるため、第三者の検証や自社での再現とは区別して読みます。
処理が速くても、人が誤分類を直す時間が増えれば業務全体は短縮しません。試験ではAPIの応答時間だけでなく、確認待ち・修正・再処理を含む所要時間まで測ると、採用する意味を判断しやすくなります。
Jevの活用方法|問い合わせ対応と営業の判断を分ける
以下は、Jevの仕様から組み立てた業務設計例です。特定企業の導入実績や、日本語での精度を実測した結果ではありません。最初は顧客への送信や契約判断を自動化せず、社内の分類・確認順序づけから試します。
問い合わせを振り分け、曖昧な案件を人へ戻す
問い合わせ本文、注文状況、過去の対応履歴を必要な範囲で渡し、種別をChoice、緊急度をScore、情報不足の有無をNoulで評価する設計が考えられます。業務側では、返ってきた値と既存ルールを組み合わせて、担当窓口と確認順序を決めます。
| 判断したいこと | Jevへの質問の型 | 後続処理の設計例 |
|---|---|---|
| どの窓口の用件か | Choice | 候補が明確なら担当キューへ分類 |
| どの程度急ぐか | Score | 定義した緊急度順に確認対象を並べる |
| 判断材料が不足しているか | Noul | 不足が疑われる場合は追加確認へ送る |
例えば「商品が届かず、請求も重複している」という連絡は、窓口候補を1つに決めるだけでは解決しません。複数の用件が含まれる場合や判断が曖昧な場合は、人が担当を調整する経路へ戻します。分類の成功を、返金や回答送信の承認と同一視しない設計にします。
営業の優先順位を、別々の評価軸で作る
営業では、問い合わせや商談メモを1つの総合点にする前に、検討時期、課題の具体性、自社サービスとの適合性を別々に評価する案が考えられます。Scoreで各軸を採点し、業務側で重み付けを決めれば、なぜ優先したかを評価項目へ遡れます。
ただし「記載がない」と「条件を満たさない」を混ぜると、情報の少ない見込み客を一律に低く評価してしまいます。不足情報は追加確認の対象として扱い、営業担当者が実際の会話で確かめます。文章の丁寧さなど、受注との関係を確かめていない特徴を評価基準に入れないことも必要です。
最初は、人が作った優先順位とJevを使った順位を並べて確認します。順序が大きく変わった案件を見れば、入力不足なのか、基準の説明が曖昧なのかを切り分けられます。自動メール送信や失注扱いの確定まで一度に広げない運用が適しています。
関連記事:営業AIエージェントとは|SFA・CRMとの違いと活用シーンを5観点で整理
Jevの導入方法|判断精度と人への引き継ぎを確かめる
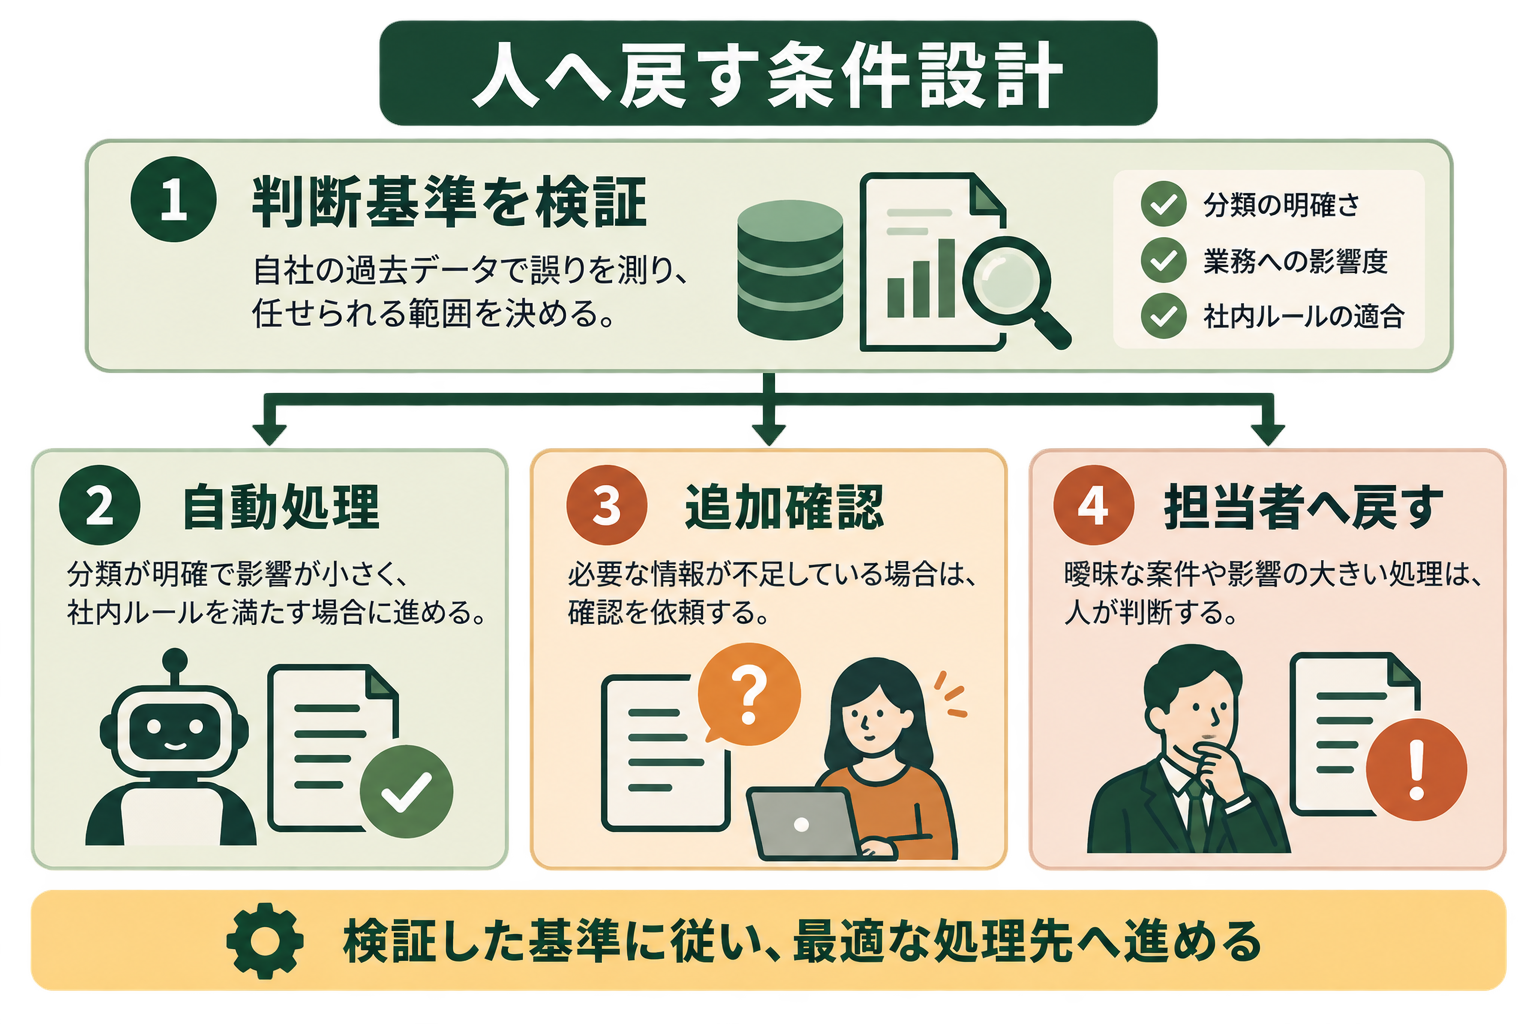
試験導入の目的は、自社の判断基準に沿って任せられる範囲を見つけることです。高い確信度が返ったという理由だけで、自動処理を認める条件を固定しないようにします。
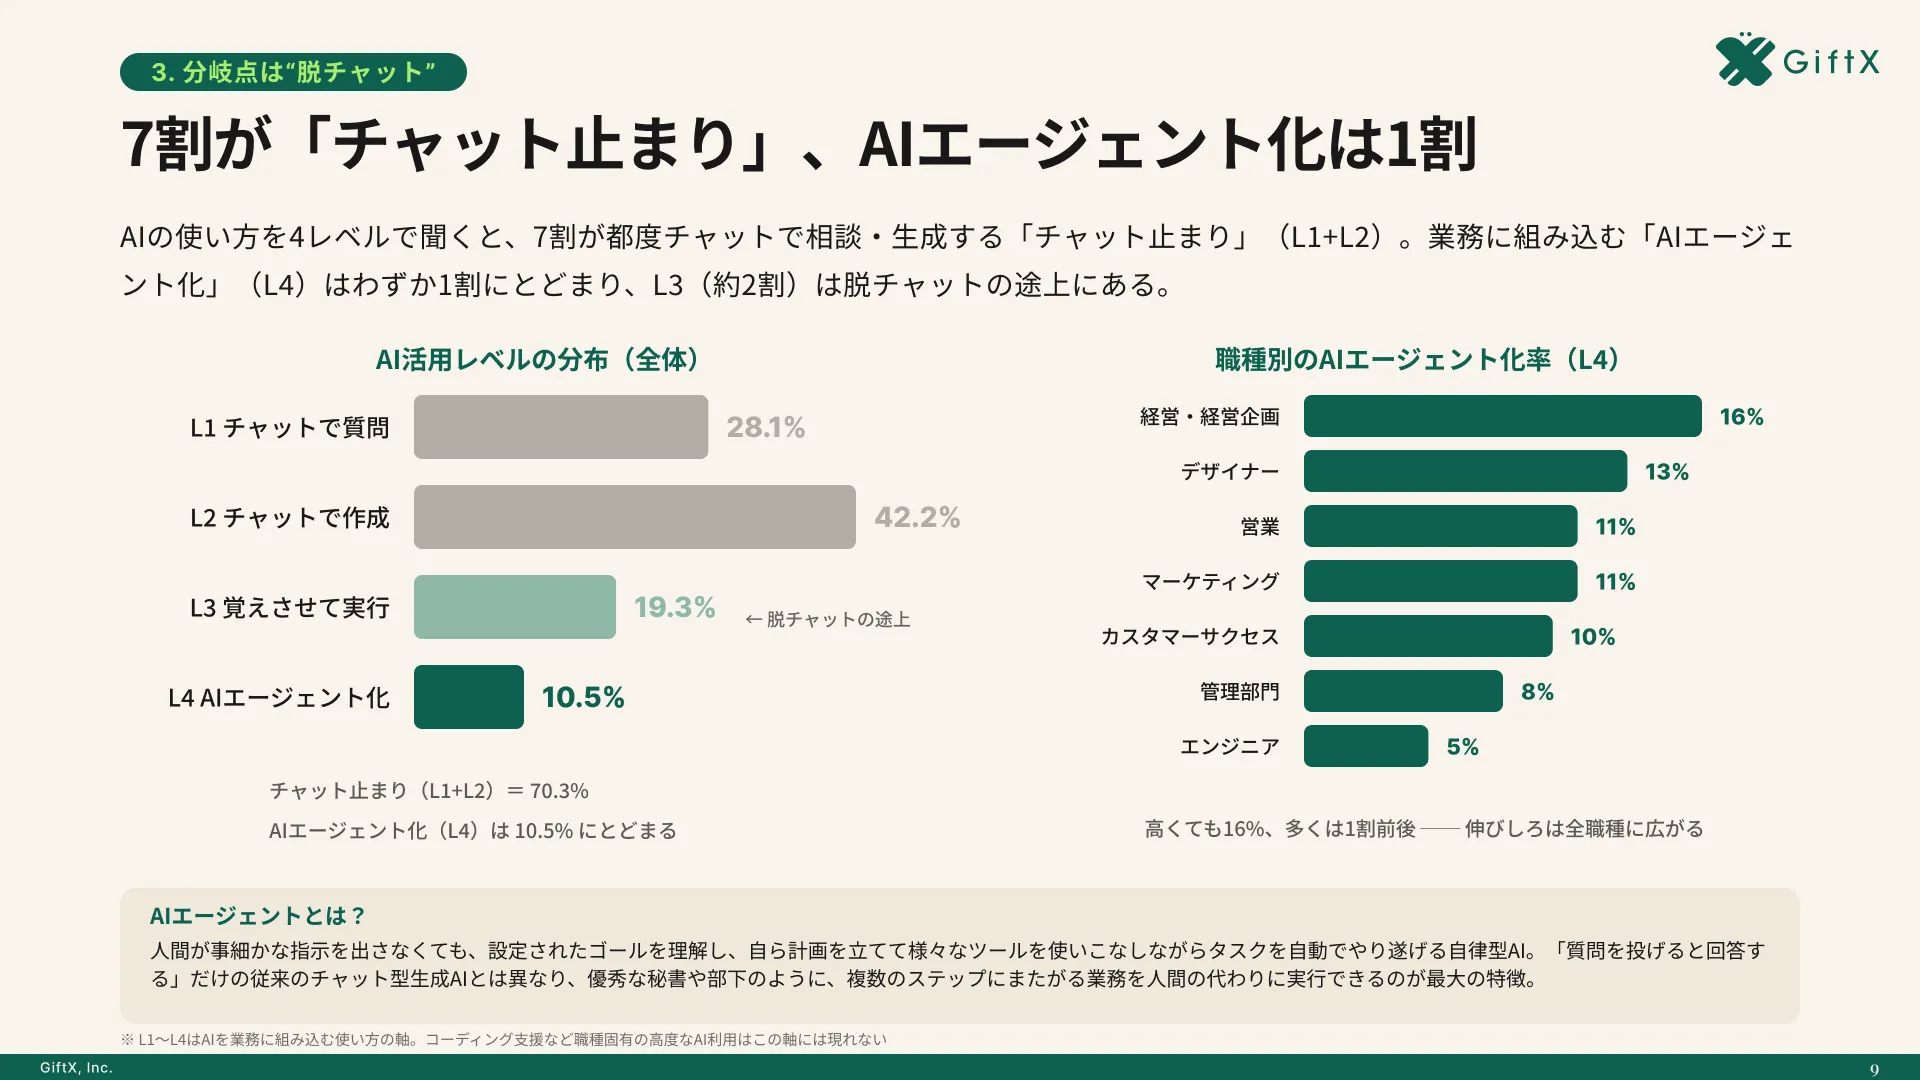
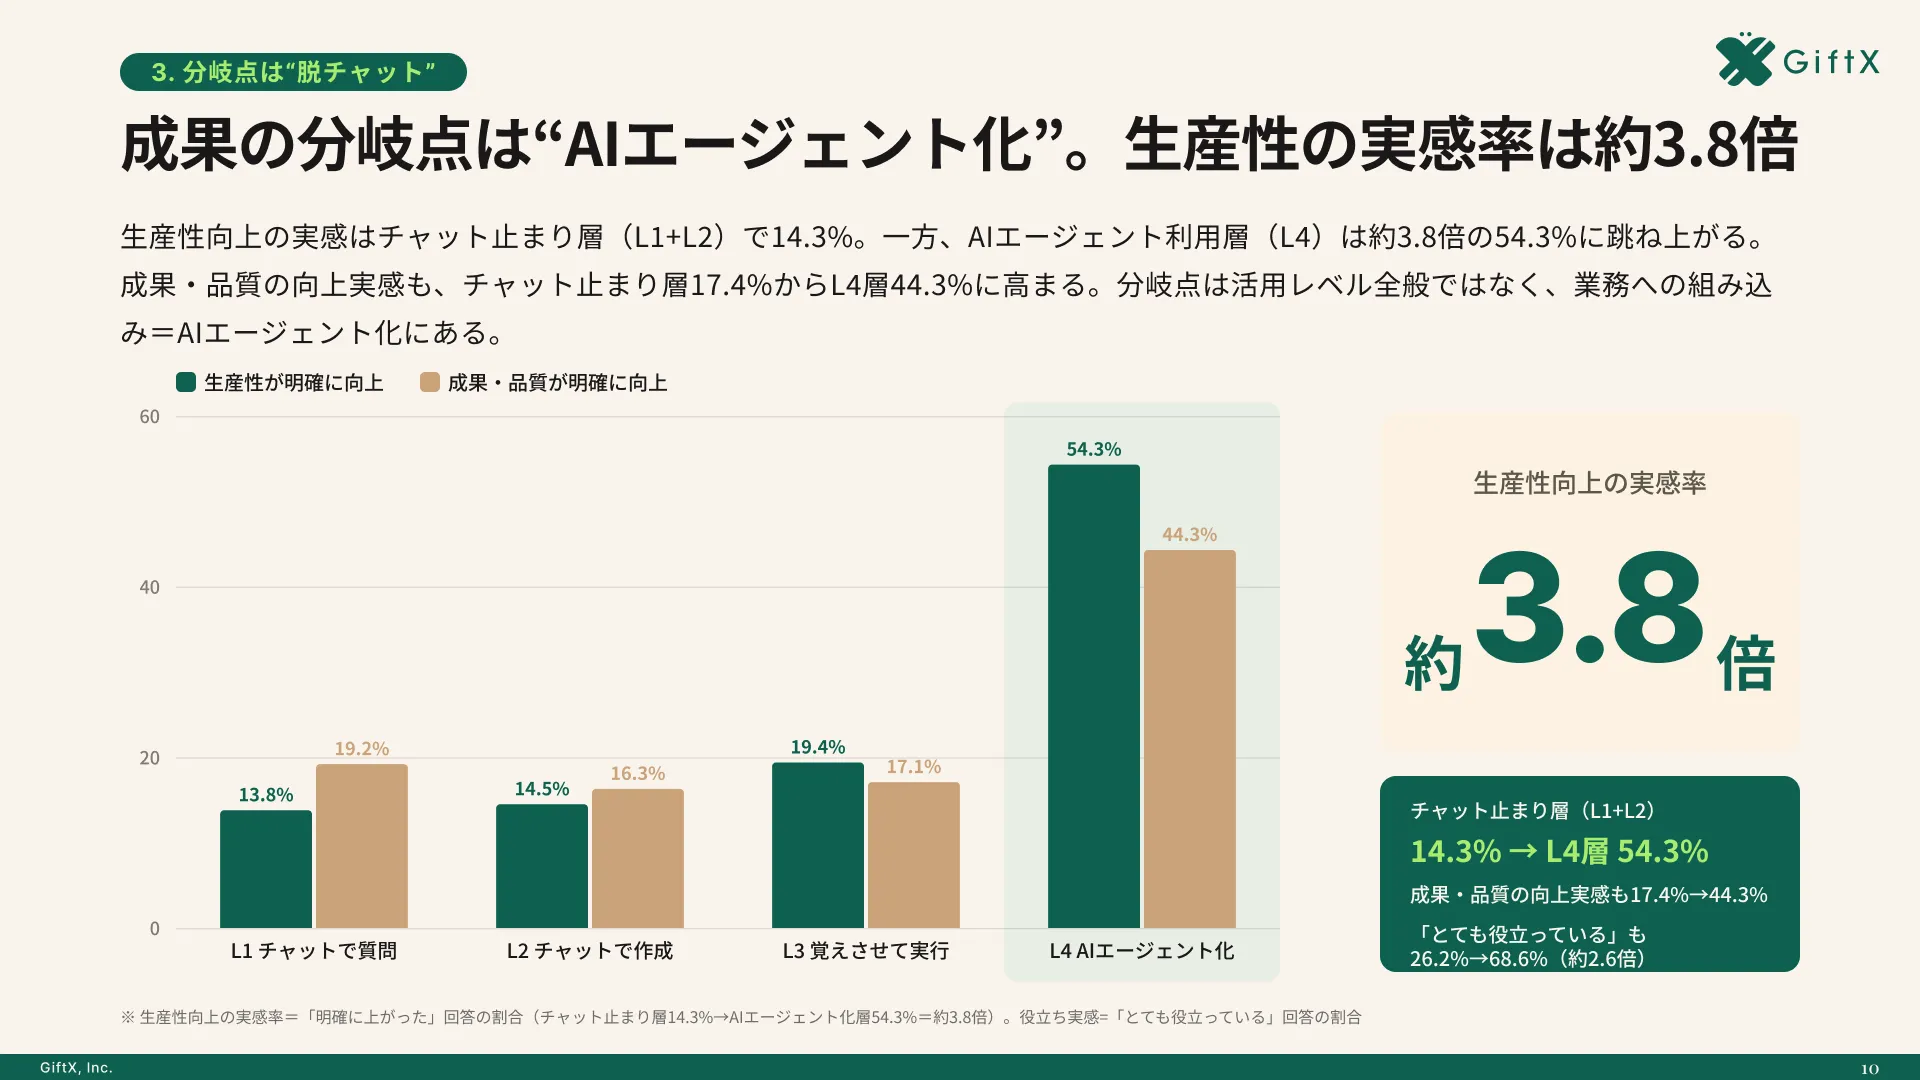
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
confidenceを正答率として扱わない
ChoiceとScoreのconfidenceは、返された確率分布の集中度合いをまとめた0〜1の指標です。「0.9だから、その1件が90%の確率で正しい」とそのまま読み替える値ではありません。各候補の確率と、分布を要約する確信度は役割が違います。
公式Confidenceガイドは、高・中・低の確信度で処理を分け、業務や誤りの影響に応じて閾値を変える考え方を示しています。固定の数値を他社事例から移すのではなく、自社の過去データでどの範囲なら誤りを許容できるか確かめます。
自社データで自動化率と誤りを同時に測る
過去の問い合わせを使うなら、通常案件に加えて、情報不足、複数用件、表記揺れ、担当者間でも判断が分かれる案件を含めます。日本語の曖昧な依頼や社内用語を評価対象に入れることで、英語のデモだけでは分からない限界を探せます。投入する情報は、社内ルールと提供側のデータ取扱条件を確認したうえで絞ります。
判断基準を調整するデータと、最終確認に使うデータは分けます。確認したい項目は、正しく分類できた割合に加え、人へ戻した件数、自動処理した中の誤り、重大案件の見逃しです。戻す件数を減らすだけでは、誤処理が増えていないか分かりません。
自動処理・追加確認・人の対応を実装する
分類が明確で影響の小さい処理は自動実行、不足情報があれば追加確認、曖昧さが大きい場合は担当者へ引き継ぐ、という分岐を用意します。返金、契約条件の変更、対外送信などは、確信度だけでなく社内の承認条件も満たした場合に限って進めます。
実運用では、入力、使った判断基準、モデルの結果、最終処理を追える記録も残します。通信エラーや応答待ちが起きたときは通常の受付キューへ戻せるようにし、Jevが使えないことを理由に顧客対応が止まらない構成にします。
Jevを業務に組み込むときに陥りがちな3つの落とし穴
AIを使って文章を作る段階から、業務の一部を任せる段階へ進むには、モデル選定に加えて処理のつなぎ方を決める必要があります。GiftXの調査では、AI利用者の70.3%が都度チャットで質問したり成果物を作ったりするL1・L2にとどまっています。
詳細な調査データは「ビジネス職生成AI活用実態調査(2026年版)」にてご覧ください。
落とし穴1|分類から対外対応まで一度に任せる
分類ができた段階で返信や返金まで自動化すると、誤りの影響が広がります。まず問い合わせの担当候補を出すところに絞り、人の判断と照合してから次の処理へ進めます。
落とし穴2|全社の最適化を決めるまで試さない
営業も問い合わせ対応も同時に設計すると、評価軸が増えて検証が進みません。件数と判断基準が把握できる1業務を選び、成功条件を置いてから試験の対象を広げます。
落とし穴3|モデルの回答だけで業務が完結すると考える
Jevの結果を受け取れても、担当者への割り当てや承認、例外対応は残ります。チャットで試した評価を業務へつなぐには、既存システムと人の作業を含めた実装が必要です。
スモールスタートで1業務をAIエージェントに任せる
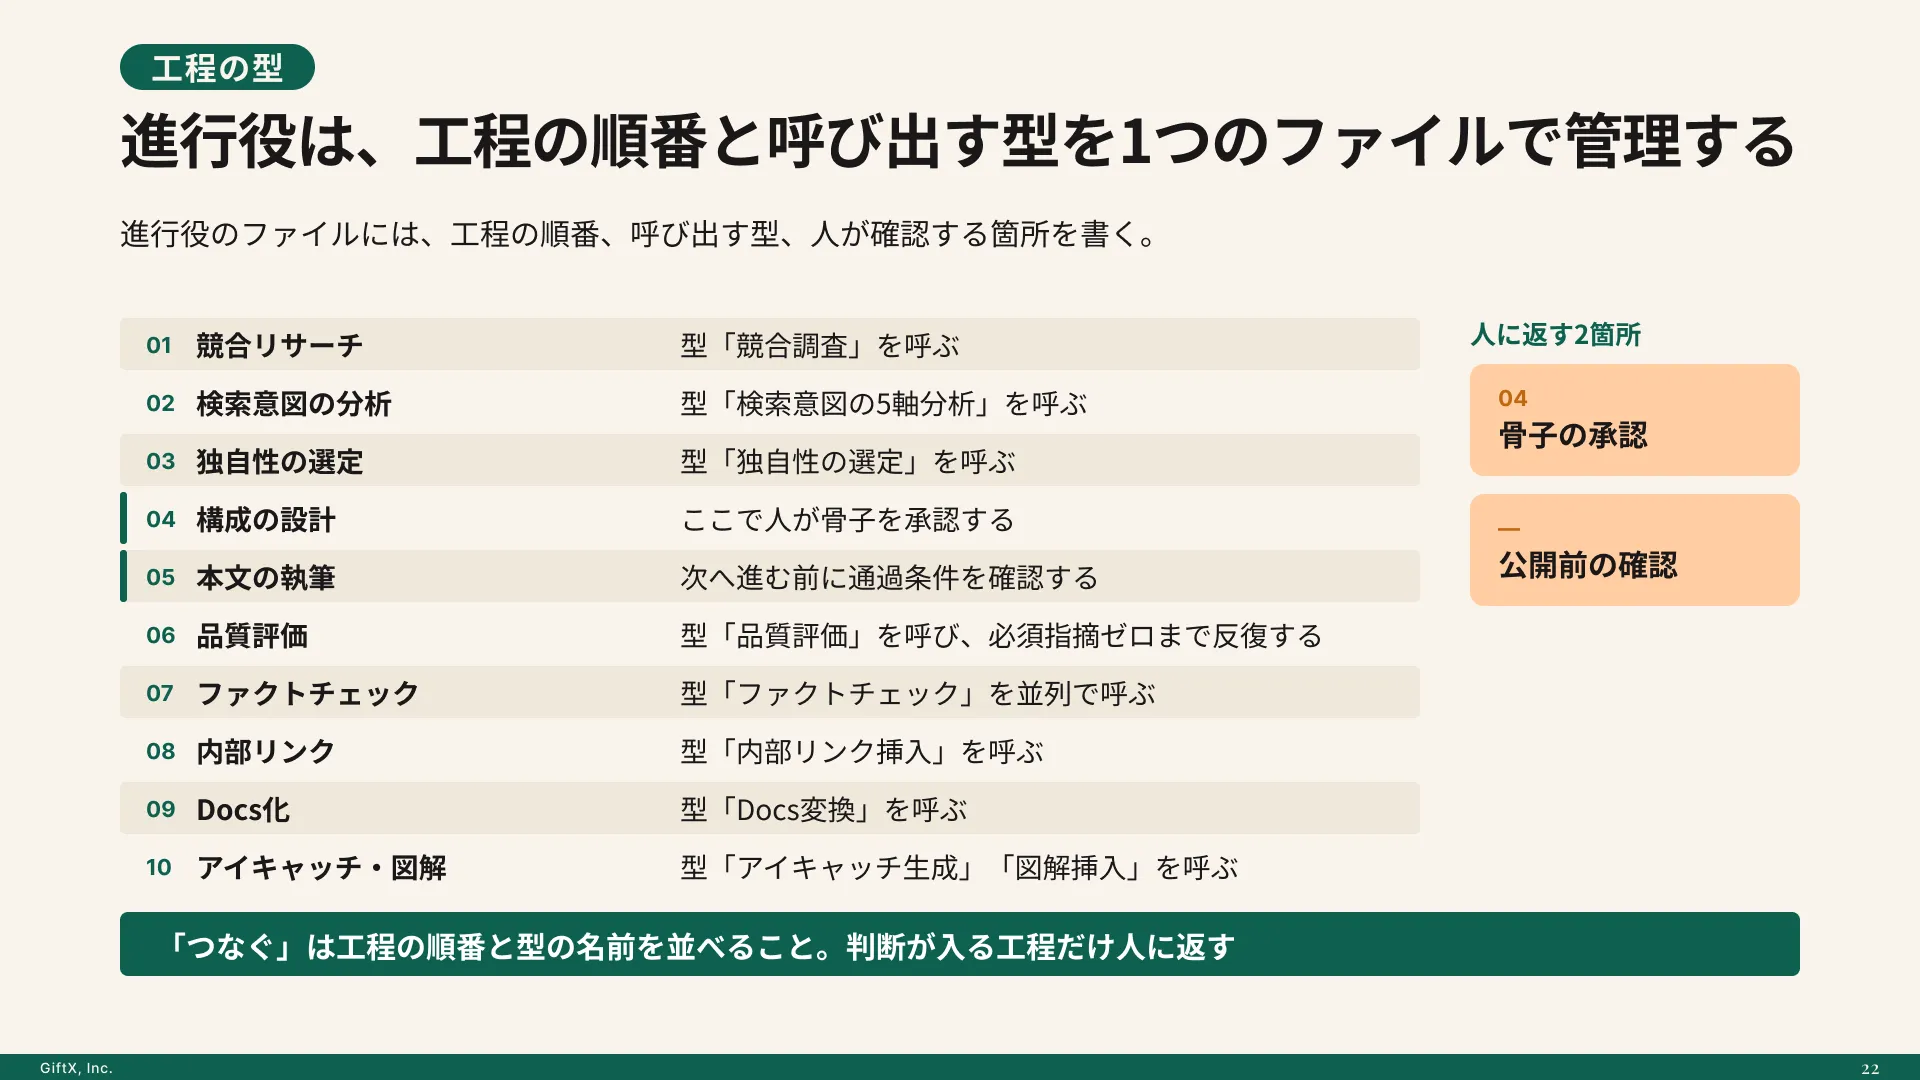
最初の対象は「問い合わせの担当候補を出す」など、効果と誤りを観察できる単位にします。入力の収集、Jevでの判断、人への確認依頼までを1つの流れとして作れば、どこに改善余地があるかを見ながら育てられます。
GiftXでは、こうしたスモールスタートを前提とした構築を1業務単位から伴走支援しています。詳細はAIエージェント構築支援サービスをご覧ください。
Jevについてよくある質問
利用を検討するときは、試せる範囲と、自社で確認する必要がある点を分けておくと判断しやすくなります。
JevはChatGPTの代わりに使えますか?
文章作成や会話をそのまま置き換える用途ではありません。Jevは選択や評価などを返すモデルです。返信文の下書きにはLLMを使い、その前後の分類や確認の優先順位付けをJevで担う構成が考えられます。置き換える対象はチャット全体より、業務内の個々の判断です。
Jevは日本語の業務でも使えますか?
本記事では、日本語の業務データを用いた品質を実測していません。日本語入力に対する応答の有無だけでは、分類や採点の精度は判断できません。自社の用語、曖昧な表現、複数の依頼を含む文面などを試験データに含め、人の判断と比較してから適用範囲を決めます。
Jevを使い始めるにはどうすればよいですか?
2026年9月18日時点では、公式サイトで早期アクセスとWaitlistが案内されています。TypeSafe AI公式サイトから現在の受付状況を確認してください。利用環境を得た後は、まず匿名化した検証用データなどで質問と評価基準を試す進め方が考えられます。
まとめ|Jevは文章生成と分けて判断を任せる
Jevは、型付きの判断と確率をソフトウェアに返すTypeSafe AIのモデルです。Choice・Score・Noulを使って問いを小さく分け、文章生成を担うLLMや業務を制御するコードと組み合わせます。型・スキーマの保証は判断精度の保証ではなく、公表された速度やコストの倍率も測定条件付きで読む必要があります。自社データで誤りと人への引き継ぎを確かめ、スモールスタートで1業務をAIエージェントに任せることから始めましょう。
Jevなどを使った業務自動化をご検討の方へ
問い合わせの分類や営業の優先順位付けを、自社の業務に合わせて具体化したい方は、GiftX AIエージェント構築支援へご相談ください。モデルに渡す情報、評価する基準、人へ戻す条件を整理するところから支援します。
GiftXでは、1業務単位のスモールスタートから試験導入、本番運用、社内ナレッジ化まで伴走します。Jevを含むモデルの適性は自社データで確かめ、既存システムや承認フローとつながる業務の仕組みとして構築します。
まずは、手作業で繰り返している分類や確認のうち、どの工程を任せるかを一緒に整理しましょう。