Claude Sonnet 5.5とは
Claude Sonnet 5.5は、Anthropicが提供するClaude 5.5ファミリーのAIモデルです。日々繰り返す、範囲の決まったタスクを速く進めるモデルとして位置づけられています。
関連記事:Claudeとは?できること・モデル・料金・ChatGPTとの違いを整理
日常のタスクを任せるSonnetの新モデル
Anthropicの公式発表は2026年9月28日付です。(出典: Anthropic公式、2026年9月28日発表)ページの発表日には時刻・タイムゾーンが示されていないため、ここでは日本時間の日付へ換算せず、公式ページの表記に従います。Sonnet 5.5はClaude 5.5ファミリーでOpus 5.5に続くモデルとして紹介されています。その後、2026年10月8日には同じファミリーの軽量モデルClaude Haiku 5.5も公開されました。
公式が挙げる用途は、バグ修正、文書やスライド、スプレッドシートの作成、デザインなどです。依頼の範囲が明確な作業を、品質と速度の両方を保ちながら進めることに軸があります。複雑な判断が長く続く仕事はOpus 5.5と使い分ける考え方です。
モデル名を知るだけでは、どの製品で使うかまでは決まりません。使い方の入口は、次のように分かれます。
- Claudeアプリ:会話やファイルを通じて、内容の整理や成果物の作成を依頼する
- Claude Code:コードベースを扱う開発作業で、修正やテストを依頼する
- API:自社アプリや処理フローへモデルを組み込む
モデルとエージェントの役割を分ける
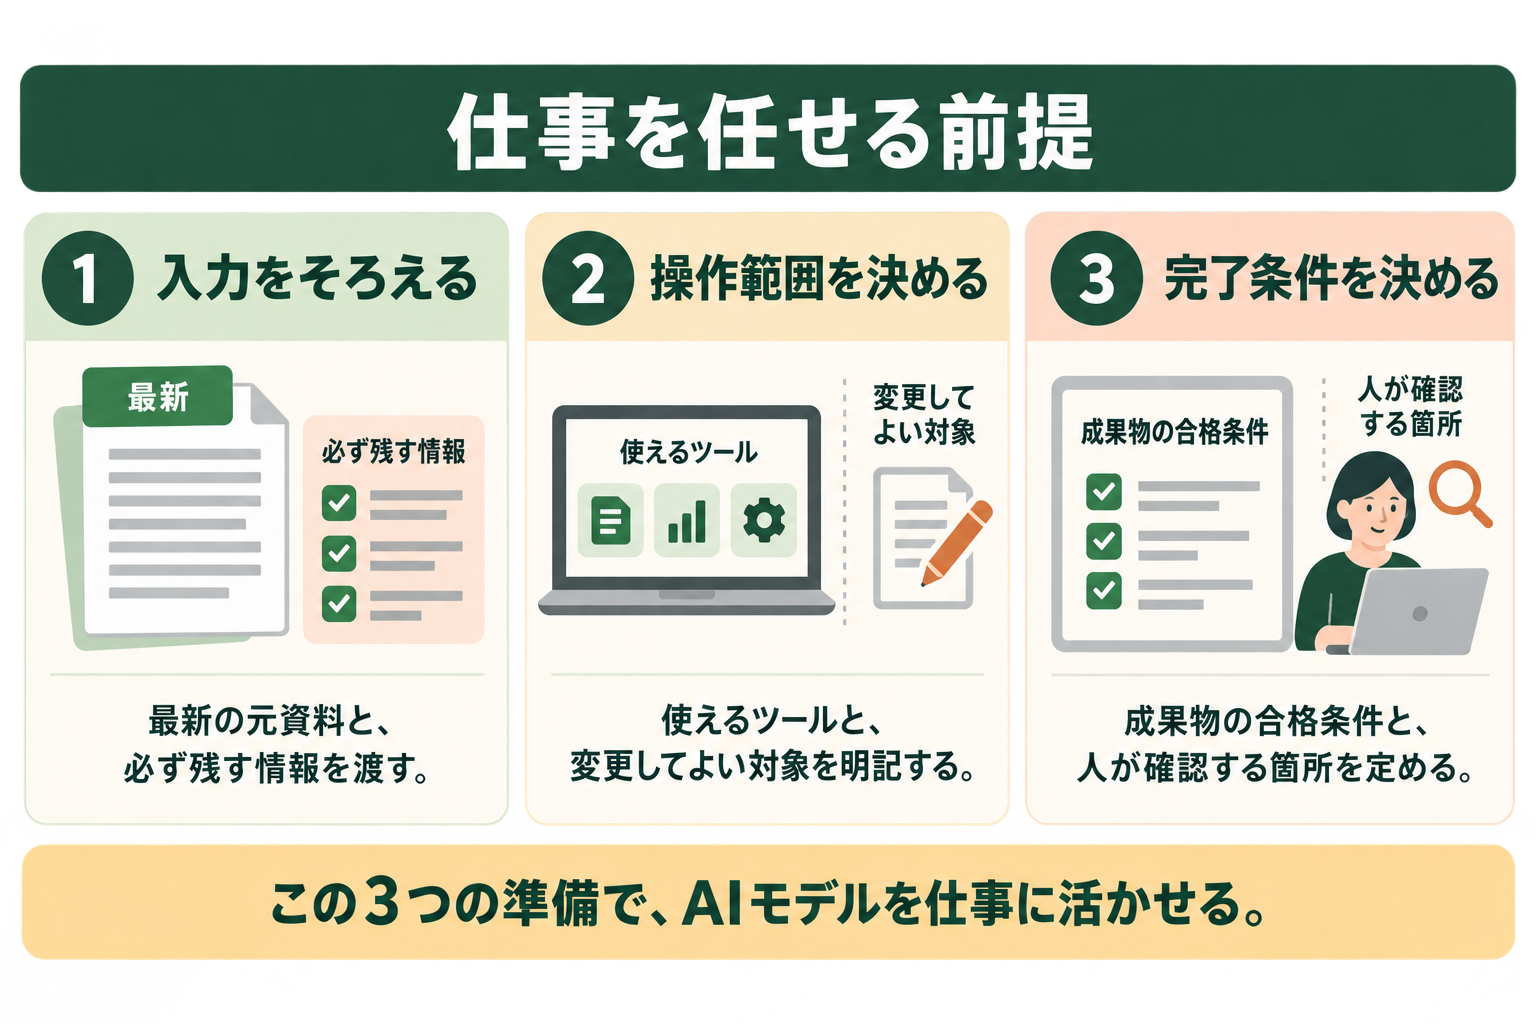
Sonnet 5.5はAIモデルの名前です。モデルを変更しただけで、自社のデータやシステムに自動で接続できるわけではありません。どの情報を渡し、どのツールを使わせ、実行結果を誰が確認するかは、利用するアプリやエージェント側の設計に依存します。
例えばコード修正なら、変更対象のリポジトリ、実行できるコマンド、テスト条件が必要です。資料作成なら、元資料と出力形式、必ず残す事実を指定します。同じモデルでも、必要な前提がそろっている依頼と、推測で補う部分が多い依頼では結果が変わります。
まずは現在の仕事を「入力」「許可する操作」「完了条件」の単位で整理すると、Sonnet 5.5の評価対象を定められます。モデルの性能と、作業を任せる環境の出来を切り分けて確認できるためです。
Claude Sonnet 5.5でできること
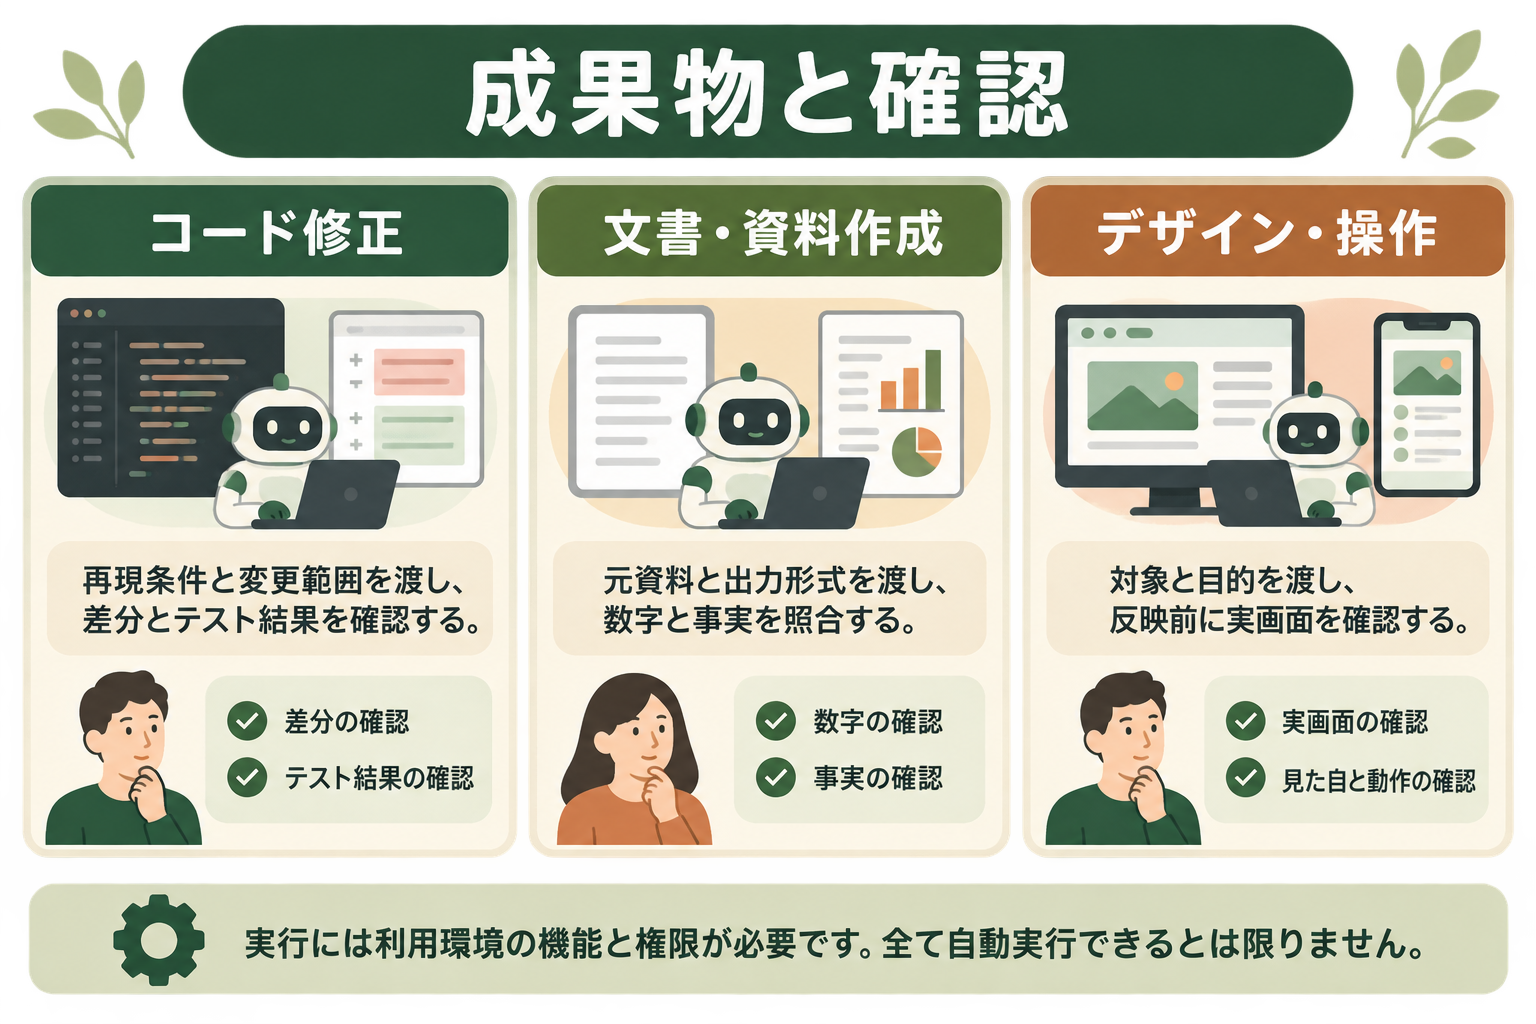
Sonnet 5.5は、文章で答える用途に加え、ツールを使って成果物を仕上げる用途も想定されています。出力の見栄えだけでなく、依頼した範囲を守って完了するかを見ます。
コード修正とテストの実行
コーディングでは、既存コードを読んで修正箇所を調べ、変更し、テスト結果を確かめる一連の作業が評価対象になります。関数を一つ書けるかだけでなく、周辺への影響を扱えるかが実際の利用では問われます。
依頼は「この不具合を直して」だけで終わらせず、再現条件と期待する動作を伝えます。変更してよいファイルや互換性の条件がある場合も、先に指定してください。修正後は差分とテスト結果を読み、意図していない変更が混ざっていないか確認します。
- 再現手順と、現在・期待する動作を渡す
- 編集対象と、変更しない仕様を明示する
- テストとレビューの完了条件を定める
この順番なら、失敗した際にも「仕様の不足」「実装の誤り」「検証の不足」を追いやすくなります。AIが出した説明だけで、テスト済みと判断しない運用が必要です。
文書・スライド・表計算の成果物作成
公式発表では、文書、スライド、スプレッドシートの作成も用途に挙げられています。利用環境に必要な機能があることを前提に、素材から構成を作り、ファイルとして整える作業を任せる考え方です。
実際に頼むときは、読み手、目的、使う資料、出力形式をそろえます。文書なら残すべき論点、スライドなら一枚ごとの主張、表計算なら計算の定義と入力値を指定すると、確認する箇所を決められます。新しい資料を作る場合と既存資料の一部を直す場合も、区別して伝えてください。
例えば週次の進捗資料では、元データの集計を任せる一方、遅延の理由や対応方針は担当者が確認します。形式が整っていても、数字や前提が合っているとは限りません。元資料との突合と、完成ファイルを開いて読む確認を残します。
デザインと画面操作を伴う作業
デザインや画面操作も、モデルの性能だけで成否が決まる領域ではありません。操作対象の状態、使えるツール、実行権限、途中で必要な確認がそろって初めて、作業として完了します。
たとえば画面の改善を依頼する場合は、対象ページと変更理由を渡し、公開前に実画面を確認するところまでを完了条件にします。見た目の案を出す段階と、本番へ反映する段階では操作の影響が異なるため、段階ごとに任せる範囲を定めます。
Sonnet 5.5を導入する際は、まず「結果を人が確認できる小さな変更」から試すと、環境側の不足にも気づけます。モデルが処理できることと、その場で実行を許可してよいことを同じ意味にしない設計が欠かせません。
Claude Sonnet 5.5の性能と速度を比較
公式発表では、Sonnet 5からの性能向上に加え、出力速度とタスク当たりの費用の改善が示されています。ただし、ベンチマークの数値と、自社で同じ改善が出るかは別々に確認します。
Sonnet 5比で出力は30%以上高速という公式評価
Anthropicは、Sonnet 5.5の出力がSonnet 5より30%以上速く、内部テストではタスク当たりの費用が最大30%低くなったとしています。これは公式が測定した条件での結果です。各依頼の時間や料金に同じ改善を保証する数字ではありません(出典: Anthropic公式)。
評価では、回答が出るまでと、ツール実行や人の確認を含めて仕事が終わるまでを分けます。
| 評価項目 | 確認する内容 | 比較時にそろえる条件 |
|---|---|---|
| 出力の速さ | 文章やコードが生成される速度 | 入力、出力の長さ、effort |
| タスク完了時間 | ツール実行・確認・修正を含む時間 | 完了条件、使用ツール |
| 完了までの費用 | 再試行も含むAPI利用額 | トークン使用量、キャッシュ |
| 合格率 | 人が追加修正せず使える割合 | 同じ評価基準と対象タスク |
コーディングのベンチマークを読む
公式のコーディング評価の一部を示します。指標ごとに測る課題が異なります。
| 公式ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6%(Xhigh) | 10.3% | 66.4%(Xhigh) |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| FrontierCode 1.1 main | 46.2%(Max)/52.1%(Xhigh) | 42.4% | 54.4% |
出典はAnthropicのSonnet 5.5発表ページです。モデルごとの設定は同ページの注記も含めて確認してください。とくにFrontierCodeでは、Sonnet 5.5のMaxとXhighで結果が異なります。effortを上げれば、どの評価でも必ず良くなるという関係ではありません。
自社環境では、実際の変更依頼で確かめます。
自社タスクで速度と品質を同時に測る
入力資料と完了条件を固定し、両モデルへ同じ依頼を渡します。失敗、途中停止、手動修正も記録します。
バグ修正と資料作成など、種類の違う仕事を混ぜず、作業ごとに結果を残します。
- 完了条件を満たしたかを、担当者が同じ基準で判定する
- 入力・出力・思考のトークン使用量と再試行を記録する
- モデル名、effort、ツール、実行時点を残す
許容できる品質と費用で仕事が完了するかを採用基準にします。
Claude Sonnet 5.5の使い方と始め方
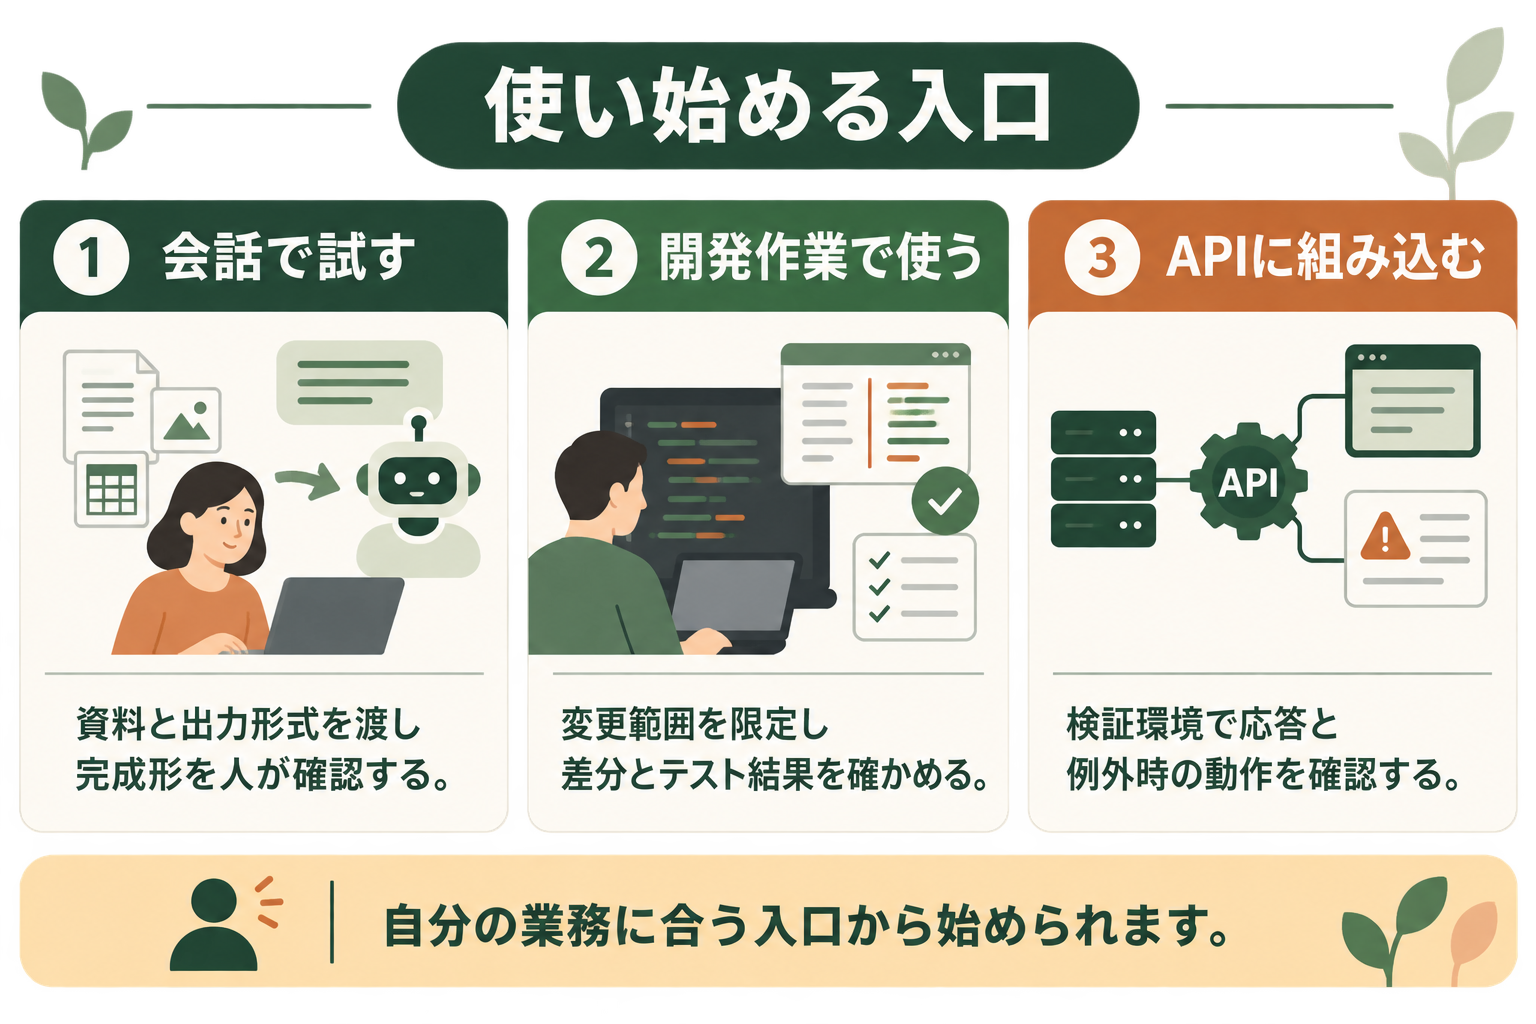
Sonnet 5.5の入口は、会話で試す、開発作業で使う、APIへ組み込むという三つに分けられます。既存の環境と、評価したい作業に合わせて選びます。
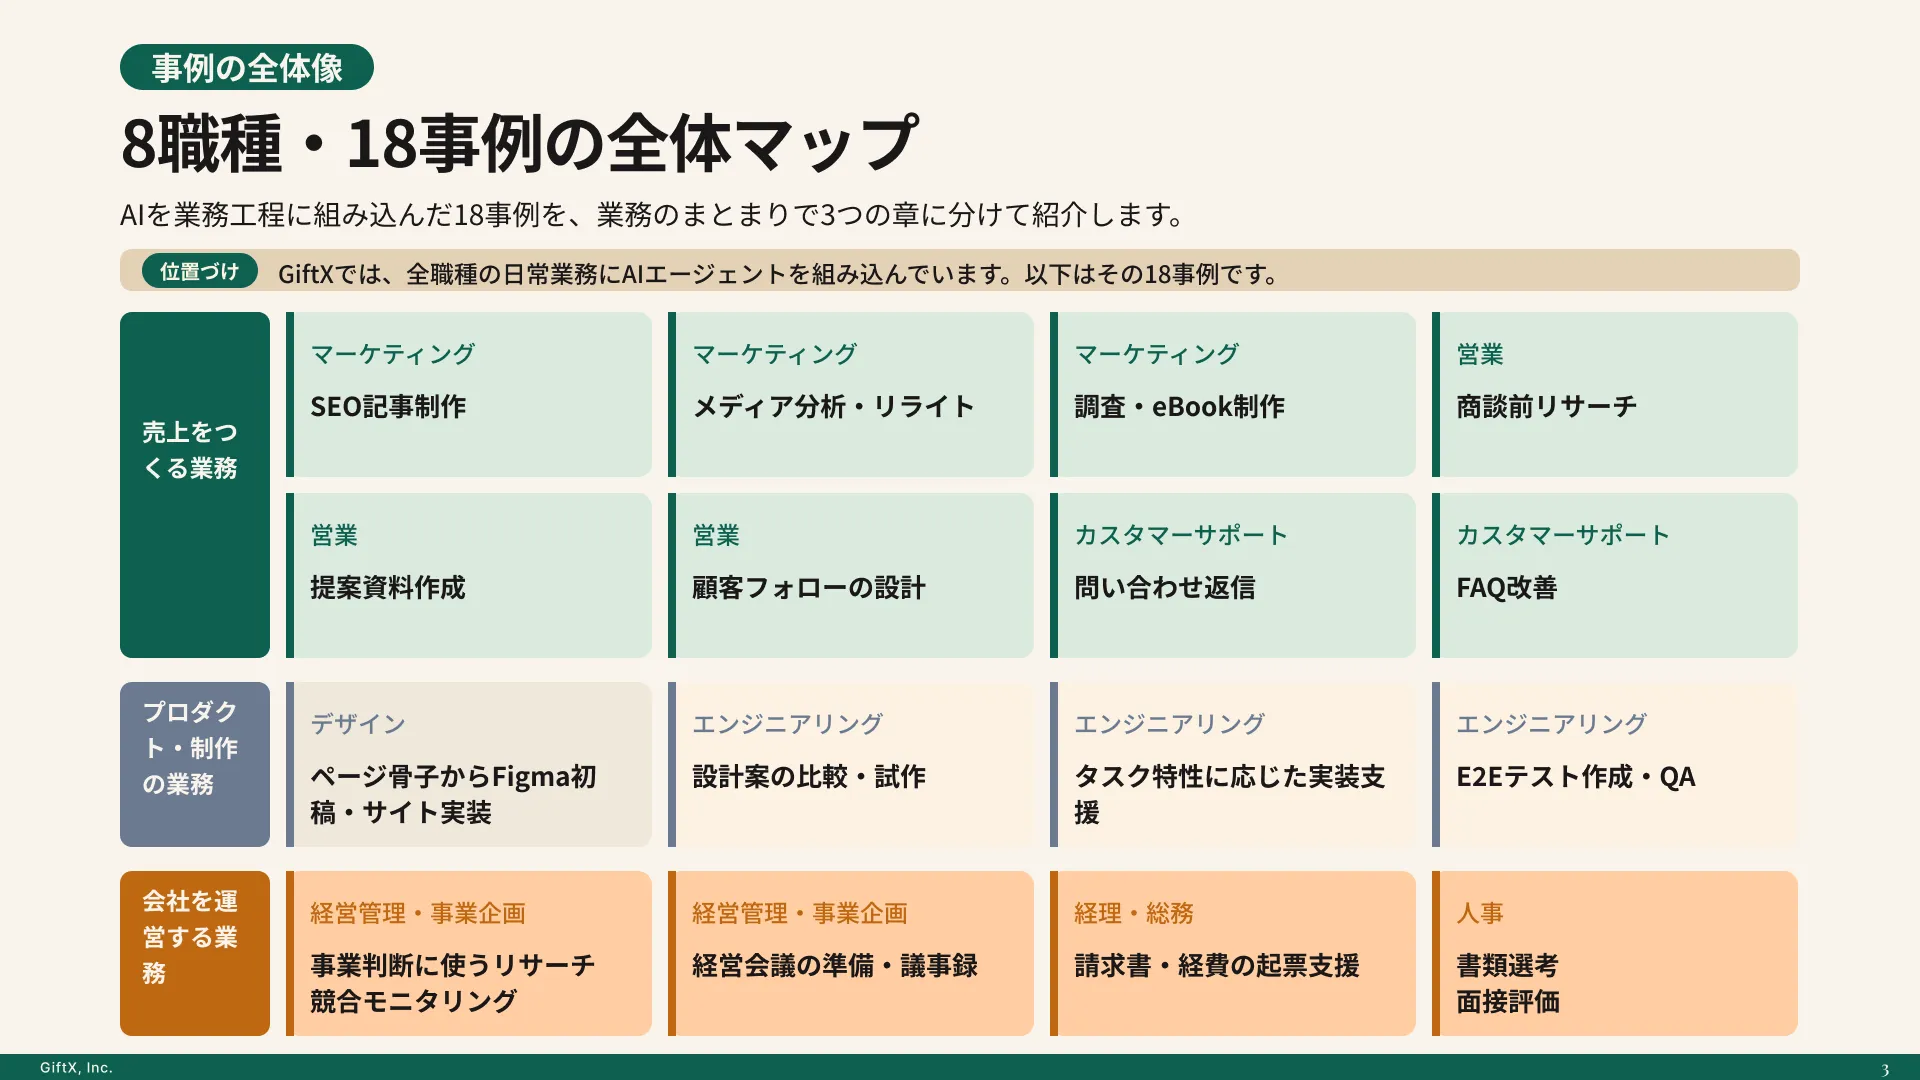
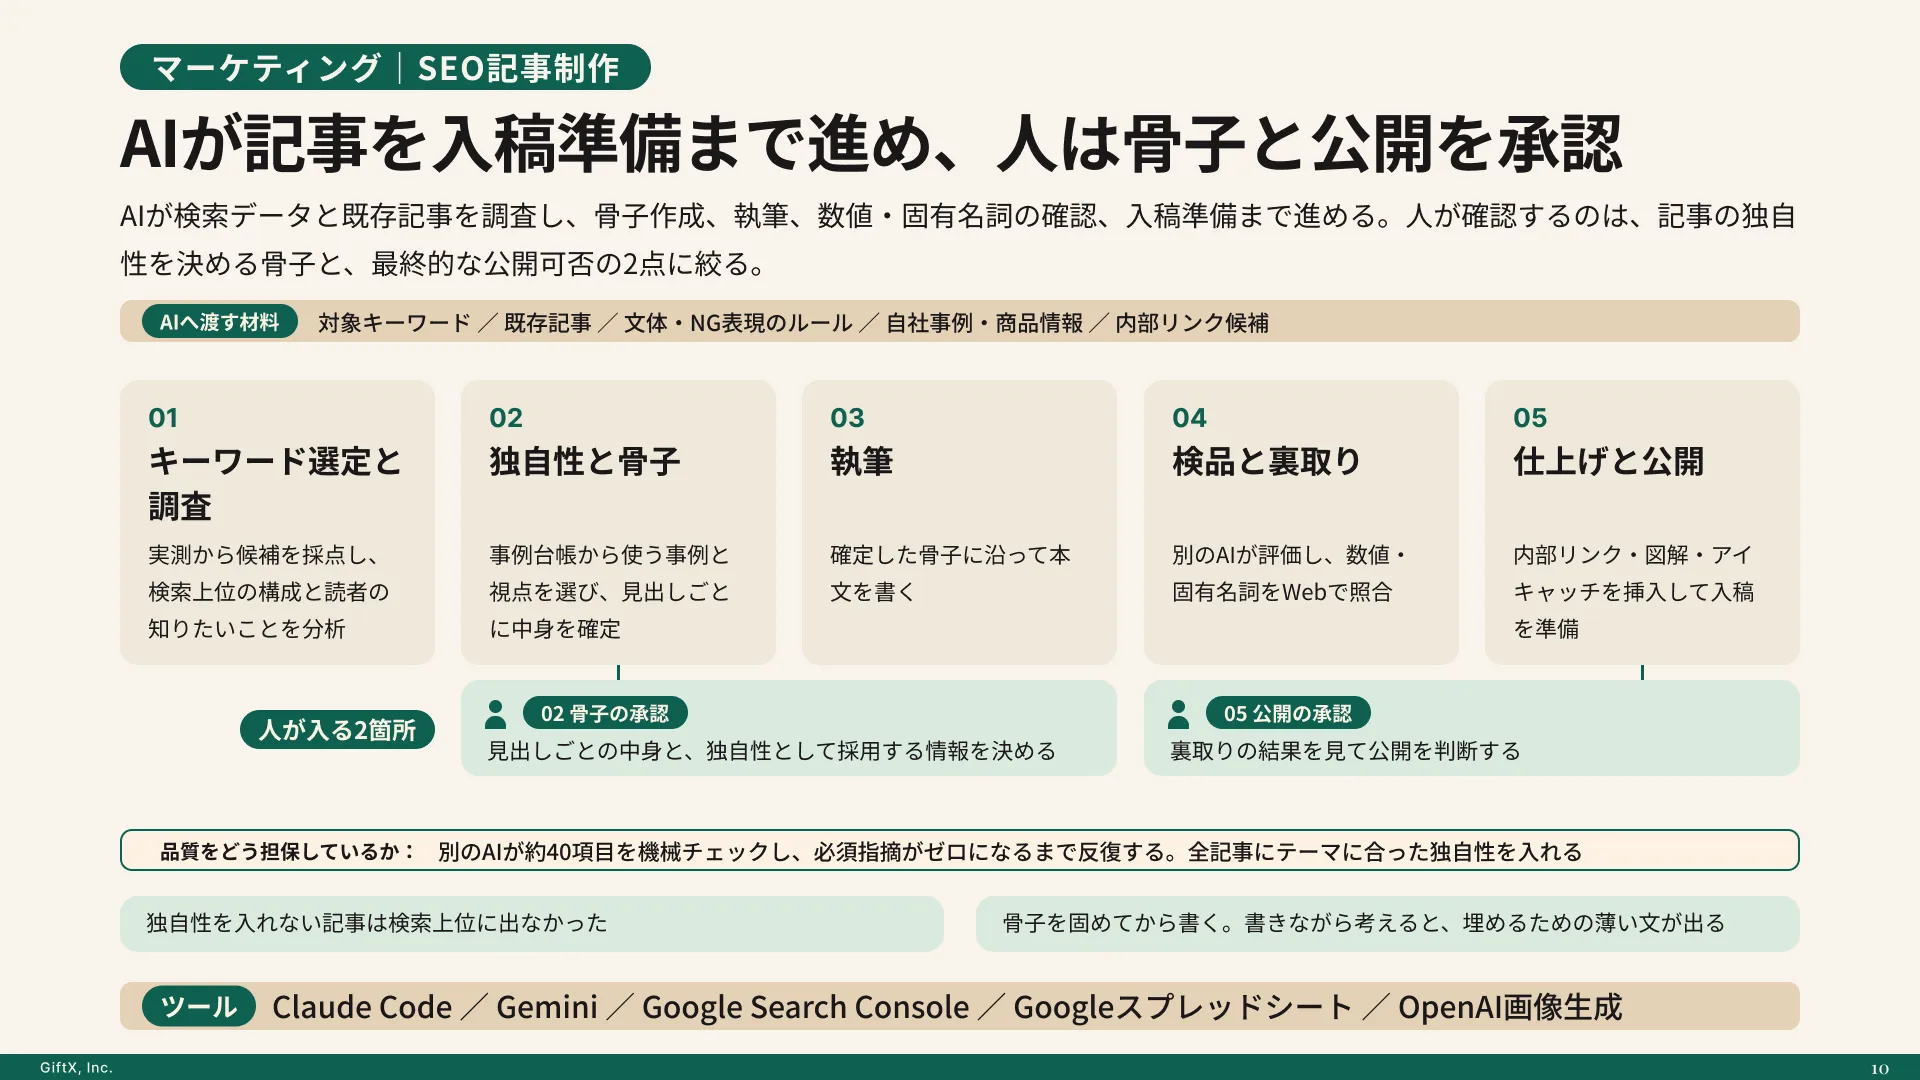
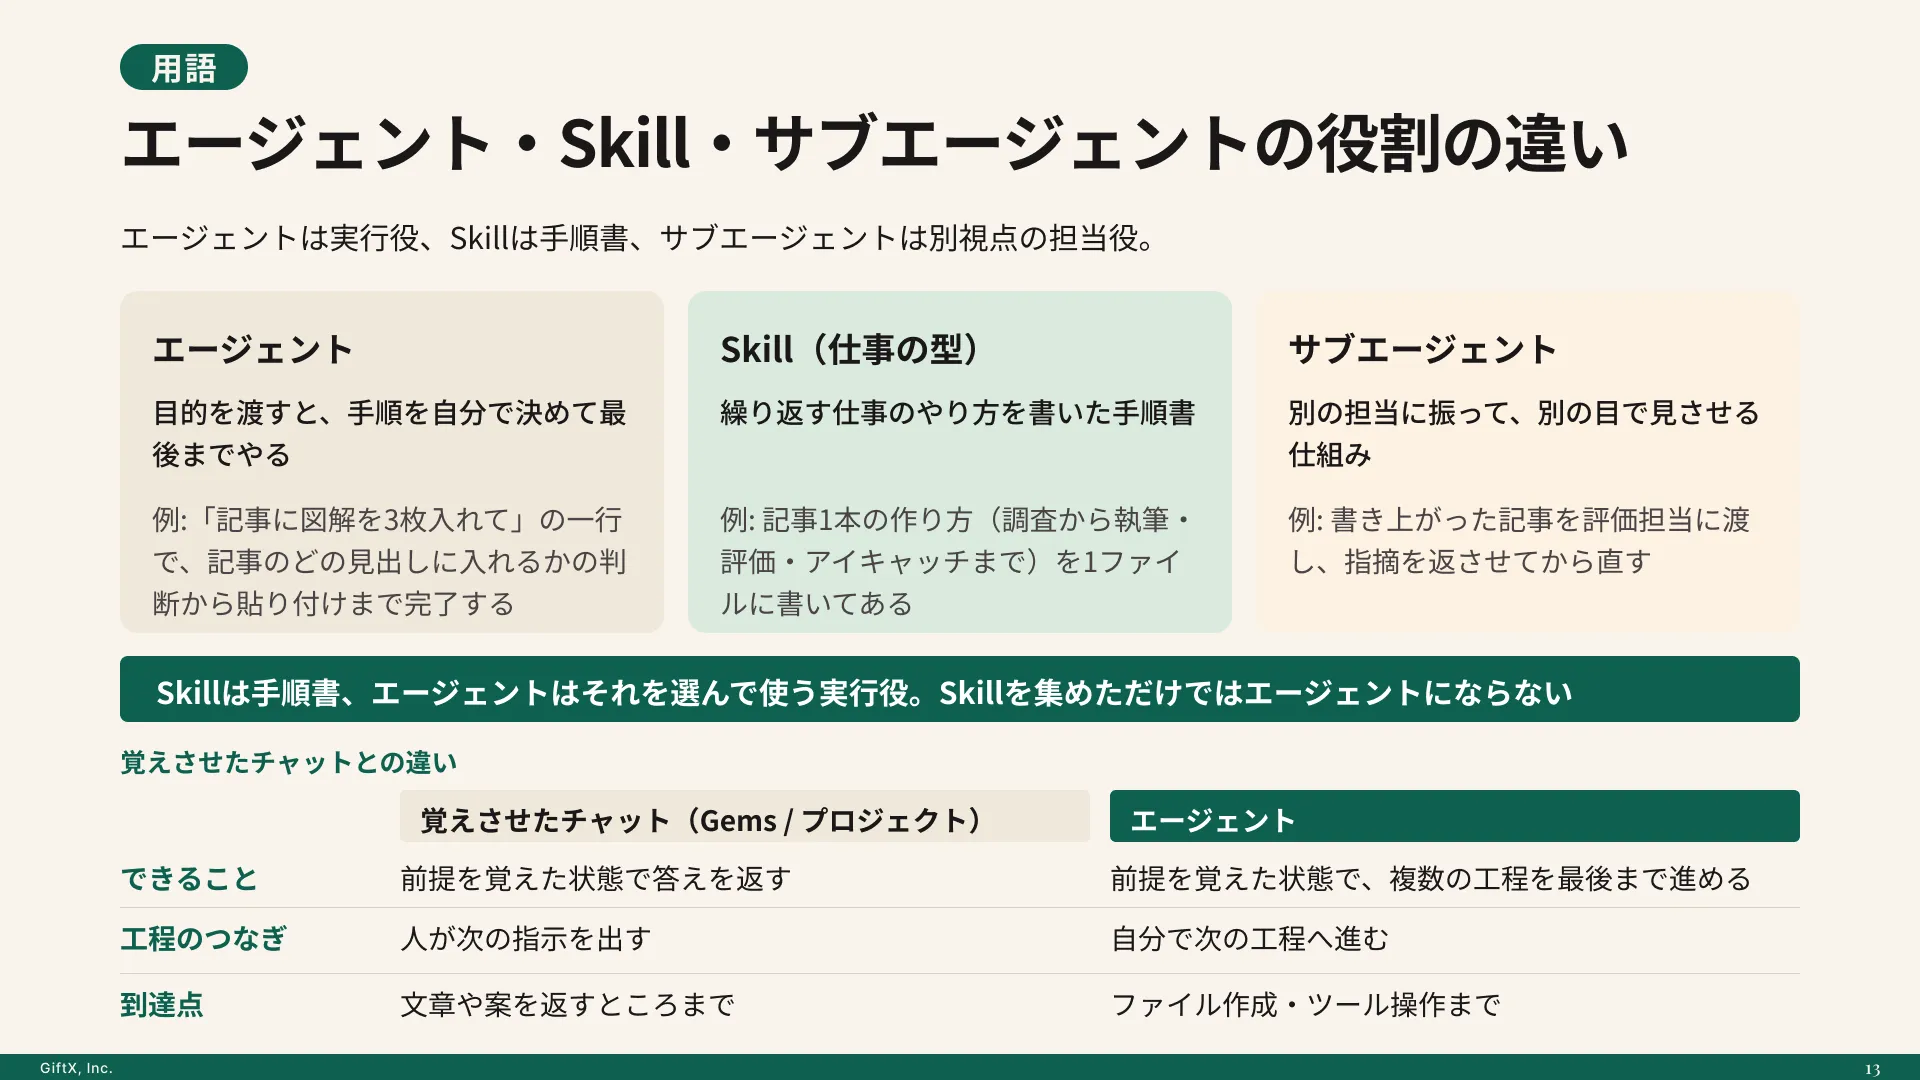
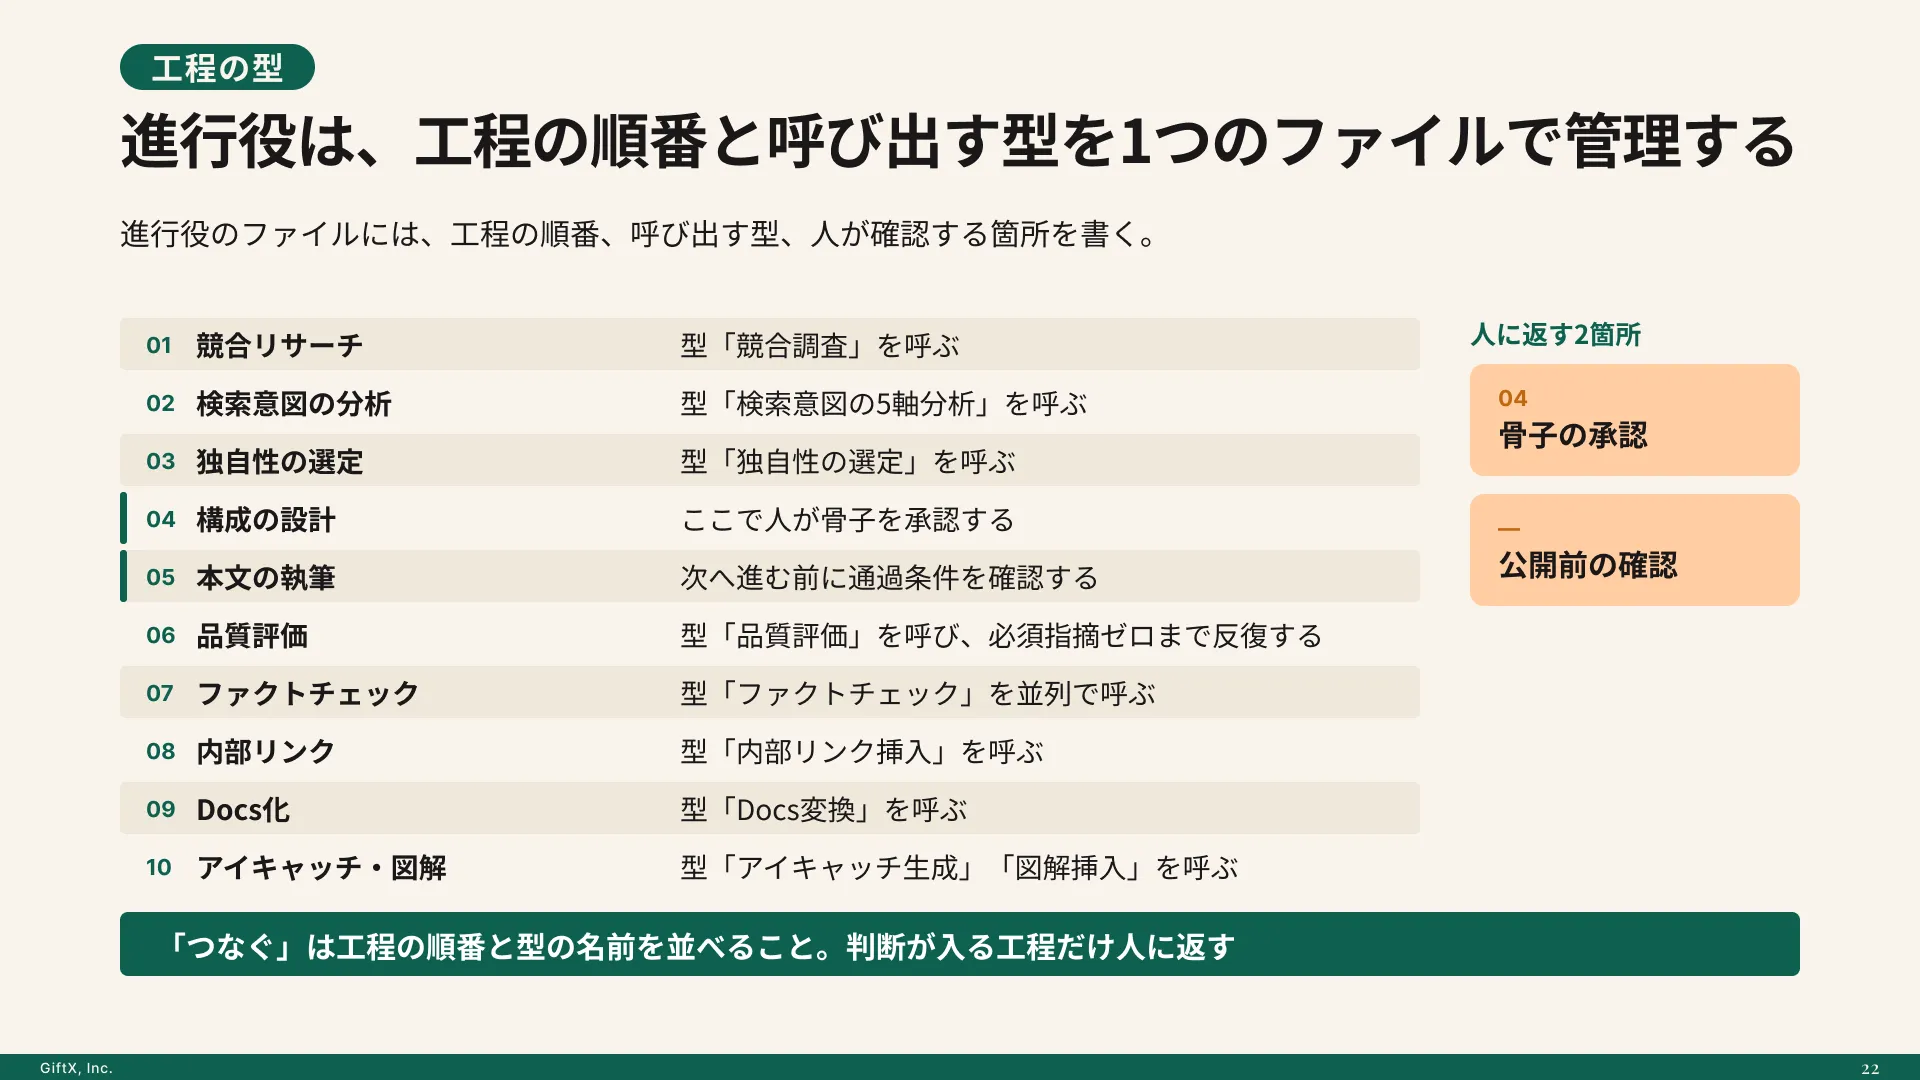
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
Claudeアプリで範囲の決まった依頼を試す
Claudeアプリでは、利用中のプランと画面で選択できるモデルを確認します。モデルの提供状況や使用量制限はプランによって変わるため、Sonnetという表記だけでバージョンを推測せず、実際に選ぶモデルを確かめてください。
初回の依頼は、入力がそろっていて完成形を判断できるものにします。長い依頼の中へ条件を散らすより、対象資料、作業内容、残す情報、出力形式を分けて伝えるほうが、期待する結果を確認しやすくなります。
| 依頼に入れる項目 | 文書作成での例 | 確認する理由 |
|---|---|---|
| 目的と読み手 | 担当者が作業手順を把握する | 説明の深さをそろえる |
| 元情報 | 最新の手順書と変更内容 | 古い仕様の混入を防ぐ |
| 変更範囲 | 指定した章だけ更新 | 無関係な修正を避ける |
| 完了条件 | 差分と未確認事項を添える | 確認と採否を判断する |
完成後は、元資料と照合して事実の抜けや変更がないかを読みます。依頼内容が曖昧だった場合は、モデルを切り替える前に条件を修正します。入力の違いが混ざると、モデルの比較として使えなくなるためです。
Claude Codeではeffortと変更範囲を確認する
公式発表では、ClaudeアプリとClaude CodeのSonnet 5.5の既定effortはMedium、Claude PlatformではHighとされています。effortは考える量を調整する設定です。利用環境が変わると初期値も変わるため、同じモデル名でも処理時間や費用が違う場合があります。
開発作業では、最初に対象リポジトリの状態と実行権限を確認します。未保存の作業や別担当者の変更がある場合は、AIに上書きさせない境界を定めます。変更範囲を小さくし、差分とテスト結果を確認できる形で依頼してください。
繰り返すバグ修正なら、まずMediumで試し、問題が残る課題だけHighなど別の設定と比較する方法があります。高い設定をすべての仕事へ固定するより、どの課題で追加の思考が必要かを見つける運用です。
関連記事:Claude Codeとは?できること・料金・使い方と社内導入の判断軸
APIではモデル名と応答の扱いを確認する
APIのモデルIDはclaude-sonnet-5-5です。日付付きの名称へ自己判断で置き換えず、公式移行ガイドに沿って指定します。旧モデルの呼び出し設定をそのまま流用する前に、thinkingやツール選択の変更を確認してください。
まず検証環境で、通常の応答、ツールを使う応答、途中停止、制限に達する応答を試します。APIで取得した文章が表示できることだけでなく、応答を受け取る側が思考ブロックやツール呼び出しを扱えるかも確かめます。
本番の切り替えは、旧モデルで合格していた代表的な依頼を新モデルでも通した後に進めます。問題が起きたときに旧設定へ戻せるよう、モデルIDと設定値、評価結果を一緒に管理します。
Claude Sonnet 5.5の料金とタスク当たりの費用
料金は、Claudeアプリの月額プランとAPIの従量課金を分けて見ます。API単価が同じでも、生成量や再試行の回数が変われば、仕事一件を終える費用は変わります。
入力・出力の単価はSonnet 5と同じ
以下は公式発表のAPI料金です(2026年10月8日時点、出典: Anthropic公式)。単位はいずれも100万トークン当たりの米ドルで、標準的な入力・出力とキャッシュの単価を示します。
| 項目 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| 入力 | $2 | $2 | $4 |
| 出力 | $10 | $10 | $20 |
| キャッシュ読み取り | $0.10 | $0.20 | $0.20 |
| キャッシュ書き込み | $2.50 | $2.50 | $5 |
Sonnet 5.5の入力と出力の単価はSonnet 5と同じです。キャッシュ読み取りは2026年10月8日に$0.20から$0.10へ引き下げられ、Sonnet 5の半額になりました。Anthropicは、これで大半のエージェント処理の費用が約20%下がるとしています(2026年10月8日時点、出典: Anthropic公式)。「タスク当たり最大30%低コスト」という発表を、API単価の30%値下げと読み替えないようにしてください。出力や思考の量、ツールを使う回数、再試行の減少などを含むタスク全体の効率の話です。
API費用を計算するときの例
単純な計算例として、キャッシュを使わず入力10万トークン、課金対象の出力1万トークンを使うと仮定します。Sonnet 5.5では合計$0.30です(2026年9月時点の単価、出典: Anthropic公式)。平均費用の実績ではなく、使用量を仮定した例です。
思考トークンも出力として課金されます。見える回答の長さだけで見積もらず、失敗した試行も集計します。
- 入力、出力、思考の使用量を利用結果から取得する
- キャッシュ読み書きを通常の入力と分けて計算する
- 外部ツール費と、人が確認・修正した時間を別に記録する
API請求額と確認・修正の工数を分けて、仕事全体の採算を見ます。
Claudeアプリの料金は契約条件と分けて見る
以下は日本語版Claude料金ページの個人プラン表示です(最新確認時点(2026年9月)、出典: claude.com)。同ページには10%のJCTを含む旨が記載されています。APIの100万トークン単価とは別の料金体系です。
| 個人プラン | 公式ページの表示 | 確認する点 |
|---|---|---|
| Free | $0 | 利用可能モデル・使用量制限 |
| Pro | 月払い$22/年払い$220 | 年払いは一括請求、表示月額は約$18 |
| Max | 月額$110から | 使用量枠の選択と制限 |
選択できるバージョンと必要な機能を実画面で確認します。料金表のSonnet欄だけで、全プランの機能・使用量が同じとは判断できません。
関連記事:Claude Maxとは?料金・使用量の上限とProとの違い、選び方を整理
Claude Sonnet 5.5とSonnet 5・Opus 5.5の違い
使い分けは、単価や順位だけでなく、依頼の範囲と判断の難しさを軸にします。Sonnet 5.5へ置き換える仕事と、Opus 5.5で試す仕事を分けると、比較の目的が明確になります。
関連記事:Claude Opus 5.5とは?性能・料金とOpus 5から切り替える判断軸を整理
Sonnet 5からは同単価で処理効率を確かめる
Sonnet 5を使っている場合、同じ入力・出力の単価で比較できます。現在の依頼で品質を保ち、時間や使用量を減らせるかを検証します。
API設定の互換性は別に確認します。thinking、ツール呼び出し、会話履歴まで点検し、移行の作業量を見積もります。
表の料金は100万トークン当たりです(2026年9月時点、出典: Anthropic公式)。
| 比較する軸 | Sonnet 5 | Sonnet 5.5 | 判断への使い方 |
|---|---|---|---|
| 標準API単価 | 入力$2/出力$10 | 入力$2/出力$10 | 単価差ではなく使用量を比較 |
| 公式の位置づけ | 旧世代Sonnet | 日々の範囲が決まった仕事 | 繰り返す作業で試す |
| thinking無効化 | 旧設定に`disabled`あり | `between_tools`へ変更 | 既存API設定を点検 |
| モデル指定 | 旧モデルID | `claude-sonnet-5-5` | 検証環境で先に切り替える |
Opus 5.5とは仕事の範囲と判断の持続性で分ける
Anthropicは、Sonnet 5.5を日常の範囲が決まった仕事、Opus 5.5を難しく開かれた問題や継続的な判断が必要な仕事に位置づけています。Sonnetがすべての仕事でOpusを置き換えるという説明ではありません。
再現条件が明確な不具合修正はSonnetから試し、複数の制約を調べる設計変更はOpusと比較します。採否は実タスクの評価で決めます。
| 仕事の特徴 | 最初に試す候補 | 評価する内容 |
|---|---|---|
| 作業範囲と完了条件が明確 | Sonnet 5.5 | 正確さ、速度、修正の往復 |
| 前提が複雑で途中判断が多い | Opus 5.5との比較 | 方針の整合性、見落とし |
| 短い会話を繰り返す | Sonnet 5.5のLow/Mediumなど | 待ち時間と回答品質 |
| ツールを使う長い処理 | 両モデルを同じ環境で比較 | 完了率、停止・復旧、総費用 |
ベンチマークの優位を全用途へ広げない
Sonnet 5.5がOpus 5.5を上回る指標があるからといって、すべての用途でSonnetが優位とは言えません。評価対象、実行環境、effortの設定が違えば、結果も変わります。
仕事の種類別に合格条件を用意し、更新後も同じ基準で比較できるようモデル名と設定を残します。
Claude Sonnet 5.5を試す実践シーン
新しいモデルの評価は、実際に繰り返している仕事から始めます。コード修正と資料作成では、入力の整え方と確認方法を変える必要があります。
小さな不具合修正で完了までを比較する
たとえば表示条件が一つ間違っている不具合なら、再現用データ、期待する画面、変更してよい箇所をそろえます。AIには修正だけでなく、条件を満たすテストと、他の表示に影響しないかの確認を依頼します。
比較では、コードを書いた時間だけを測らず、テスト失敗への対応と人のレビュー時間まで含めます。修正が速くても、無関係な差分が多く確認に時間がかかるなら、そのまま採用する理由にはなりません。
GiftXのAIを使った開発体制では、Claude CodeやCodexと協働し、コード生成・リファクタリング・テストを進める考え方が紹介されています。これはSonnet 5.5の導入実績ではありません。既存の協働フローを参考に、新モデルを小さな変更へ適用する仮想の検証例として捉えてください。
Sonnet 5.5を試すなら、AIの操作範囲と人のレビューを同じ条件に固定し、モデルを替えた影響だけを記録します。開発環境や承認方法まで同時に変えると、改善がどちらによるものか分からなくなるためです。
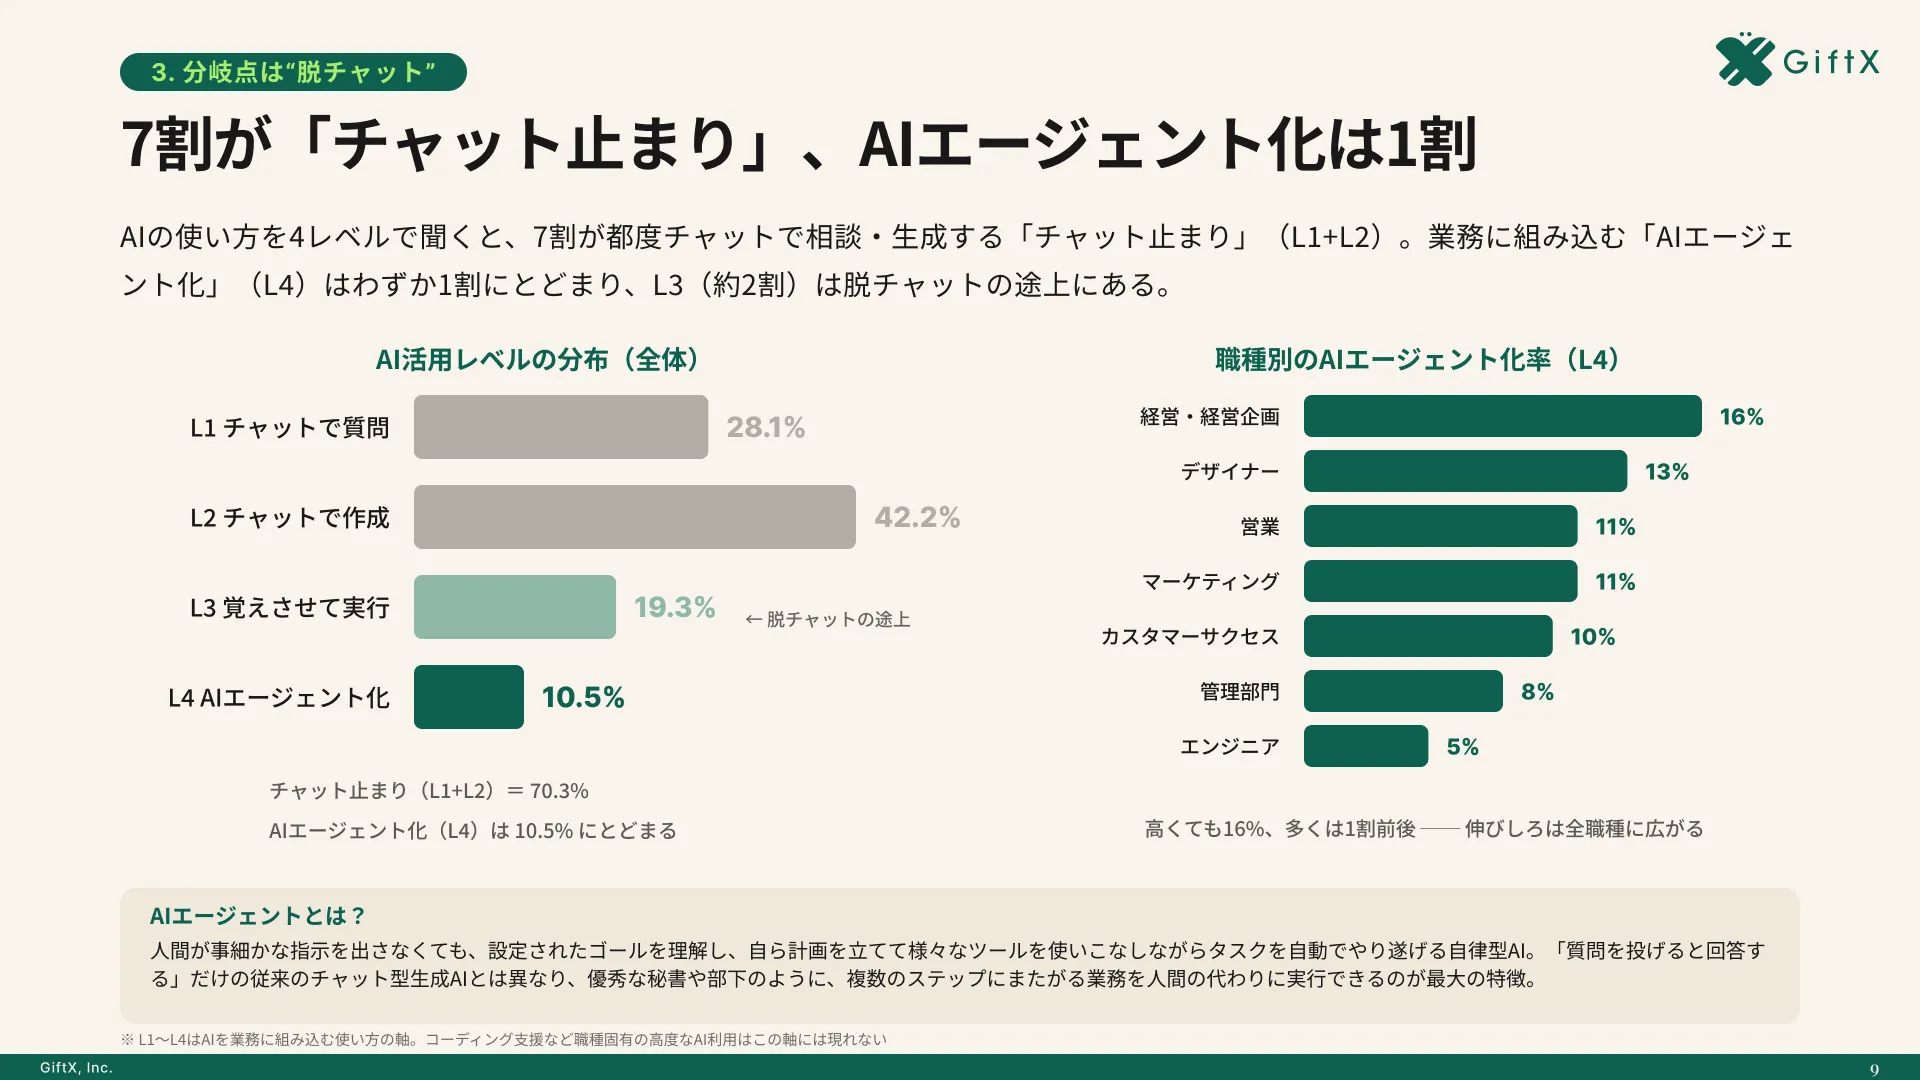
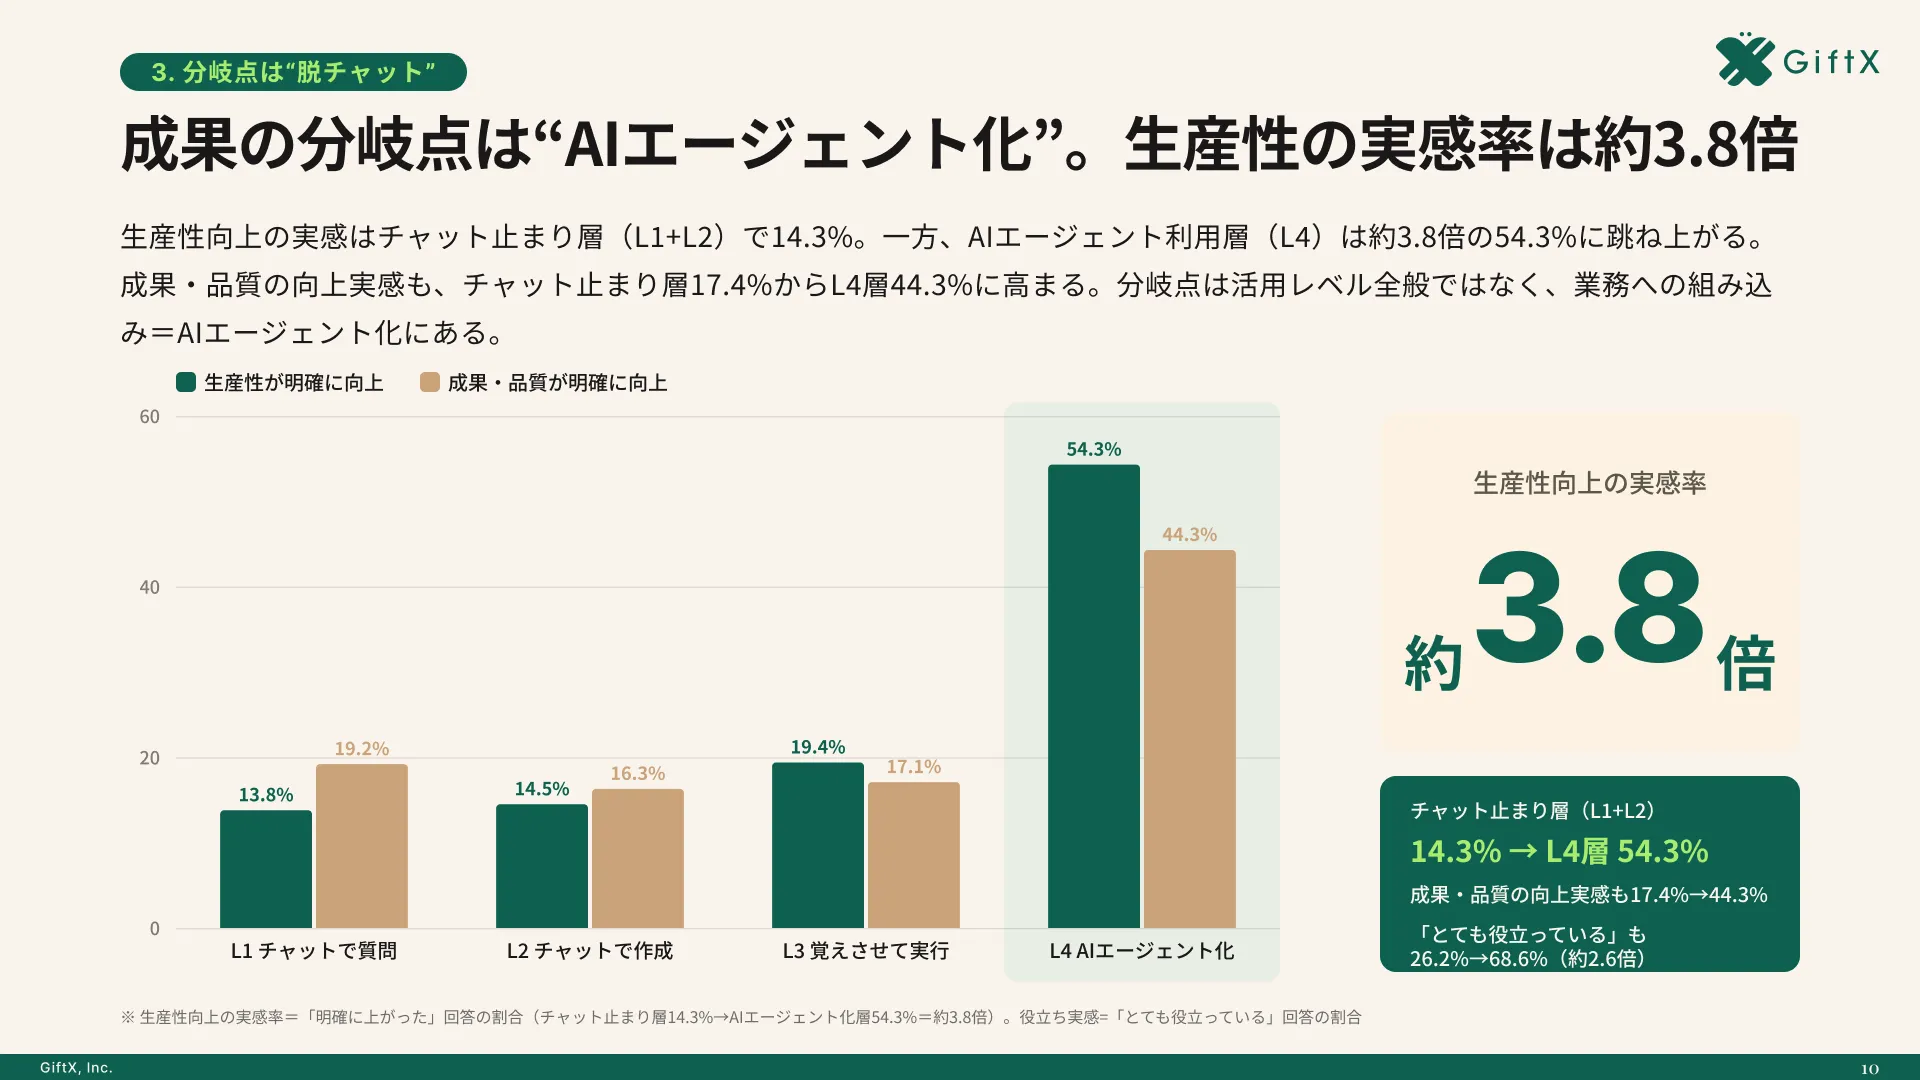
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
定型の資料作成で確認負担を測る
もう一つの例は、同じ形式の進捗資料や手順書の更新です。毎回変わる入力値と、変えない構成・表現を分けて渡し、指定した範囲だけを更新させます。
比較用の素材には、抜けると困る数値、注記、未確定事項を含めます。整った文書が出るかだけでなく、曖昧な箇所を曖昧なまま示せるか、勝手に結論を補わないかを確かめます。
- 元資料の数字と文書内の数字が一致するか
- 変更していない部分の内容と形式が保たれるか
- 未確認の情報と、担当者が判断する箇所が区別されるか
資料作成の検証では、人が最終確認にかけた時間も残します。モデルの回答が短時間で出ても、確認箇所が増えたなら運用の改善が必要です。出力形式を固定するだけでなく、差分と根拠を添える依頼にすると確認しやすくなります。
合格・再試行・人へ戻す条件を用意する
試用中にAIが止まったり、不足情報を求めたりすること自体は、失敗とは限りません。確認できない情報を推測するより、人へ戻すほうが適切な場面もあります。停止理由と、再開に必要な入力を分けて記録します。
たとえば対象ファイルが見つからない場合と、ツールの権限が足りない場合では対処が違います。モデルへ再度同じ依頼を投げる前に、作業環境と入力を点検してください。
評価票には「完了」「条件を直して再試行」「担当者へ戻す」を設けます。人の介入が必要な境界も含めて評価することで、無理にすべてを自動化する導入を避けられます。
Claude Sonnet 5.5の注意点とAPI移行
API移行では、thinkingとツール呼び出しに旧モデルとの差があります。既存の設定をコピーするだけで切り替えず、公式移行ガイドに沿って確認してください。
thinkingのdisabledはbetween_toolsへ変更する
Sonnet 5.5では、thinkingを指定しない場合、適応的な思考が有効になります。旧モデルで使っていたthinking.type="disabled"は400エラーとなるため、先に考える処理を抑える用途ではbetween_toolsへ変更します。
between_toolsは、すべての思考をなくす指定と同じではありません。最初の思考を抑えつつ、ツールを使う途中では思考ブロックが返ることがあります。応答を受け取る側は、この違いを扱う必要があります。
| 設定・処理 | Sonnet 5.5での確認事項 | 対応の方向 |
|---|---|---|
| `thinking.type` | `disabled`は400エラー | `adaptive`または`between_tools` |
| `between_tools`のeffort | Low/Medium/Highのみ | Xhigh/Maxでは`adaptive`を使う |
| 応答の読み取り | 最初の要素が文章とは限らない | contentのtypeごとに処理 |
| 会話履歴 | 署名付き思考ブロックを保持 | 応答を勝手に編集しない |
これらは公式のSonnet 5.5移行ガイドに基づきます。空の思考ブロックでも、履歴に必要な情報を含む場合があります。画面表示用のテキストと、APIへ返す会話履歴は分けて管理してください。
effortと出力上限は一緒に評価する
Sonnet 5.5はLow、Medium、High、Xhigh、Maxのeffortに対応します。ただし、前項のとおりbetween_toolsで使えるのはLow・Medium・Highです。設定名を選べることと、組み合わせが有効であることを分けて確認します。
またmax_tokensは思考とテキストの両方を含みます。旧モデルと同じ上限で試した際に、思考で枠を消費し、回答や処理が途中で止まる可能性も検証してください。
effortは旧モデルと同じ名前でも振る舞いが調整されています。旧モデルのHighで使っていたから新モデルもHighで固定する、という決め方ではなく、同じ仕事をいくつかの設定で比較します。品質、待ち時間、費用を一緒に記録すると、通常用と難しい依頼用を分けられます。
強制ツール選択と利用環境の差を確認する
Sonnet 5.5では、tool_choiceのanyや特定ツールの強制指定はサポートされず、400エラーになります。旧実装が必ず一つのツールを呼ぶ前提なら、呼び出し方法だけでなく、呼ばれなかった場合の扱いも点検してください。
公式ガイドはautoを使う方向を示しています。strictなツール定義が使える環境でも、処理側で結果の形式を確認する設計を残します。Bedrockではstrictなツール利用の対応に差があるため、提供元の仕様も確認します。
画面操作ツールも環境によって対応バージョンが異なります。使う環境の公式資料を確認し、拒否やフォールバックを含む例外時の動作もテストします。
AIエージェント導入で陥りがちな3つの落とし穴
Sonnet 5.5の性能を仕事に生かすには、モデルの採用と作業フローの設計を一緒に考えます。速度の向上だけを期待して導入しても、入力や確認方法が曖昧なら、修正の往復は残ります。
いきなり全てをやろうとする
最初から複数のシステムをつなぎ、企画から実行まで任せると、どこで問題が起きたかを追いにくくなります。まずは入力と成果物が定まる仕事を一つ選び、合格条件を固定します。
コードなら一つの不具合、文書なら一つの章の更新に絞る方法があります。小さな範囲で、人の確認も含めて完了できた後に、似た仕事へ広げてください。
壮大なAI戦略から考えて手が止まる
全体方針を整えるだけでは、現場で任せられる仕事は増えません。日常の作業で時間がかかっている箇所から、検証できる対象を選びます。
評価に必要なのは、入力、許可する操作、完成形、確認する担当者です。この単位で試すと、どのモデルを選ぶかだけでなく、足りないデータや手順も見えてきます。
チャットの出力を業務フローへつなげられない
既製品のチャット型AIツールは試しやすい一方、自社の作業手順やデータ形式へのカスタマイズが不足すると、業務フローに組み込める品質に届かない場合があります。生成した回答を毎回人が貼り直す運用では、後工程の手間が残ります。
必要な連携、実行権限、人の確認を整理し、どこまでをAIが担当するかを定めます。モデルの変更で解決できる問題と、周辺の仕組みを直す必要がある問題を分けてください。
スモールスタートで1業務を自動化・効率化する
最初の対象は、繰り返しがあり、成果物を検証できる1業務にします。Sonnet 5.5で処理する部分と、人が判断する部分を明記し、完了時間・費用・修正回数を比べます。
この検証で得た手順と合格条件を残せば、次の仕事でも再利用できます。小さく試し、成功と失敗の条件を把握してから範囲を広げることが、継続して使えるAIエージェントを作る道筋です。
自社の作業に合わせた設計や検証に迷う場合は、GiftXのAIエージェント構築支援で、対象業務の選定から実装までご相談いただけます。
Claude Sonnet 5.5のよくある質問
Sonnet 5.5はSonnet 5よりAPI料金が安いですか?
入力と出力の単価は同じで、入力100万トークン当たり$2、出力100万トークン当たり$10です。キャッシュ読み取りは2026年10月8日から$0.10となり、Sonnet 5の$0.20より安くなりました(2026年10月8日時点、出典: Anthropic公式)。公式発表の「タスク当たり最大30%低コスト」は、同じ仕事を終えるための効率に関する評価であり、単価の値下げではありません。
Sonnet 5.5とOpus 5.5はどちらを選べばよいですか?
範囲が決まった日常の仕事ではSonnet 5.5から試し、複雑な問題や継続的な判断が必要な仕事ではOpus 5.5と比較します。ベンチマークの順位だけで決めず、同じ入力と完了条件で、品質・時間・費用を評価してください。
APIのモデル名を変えるだけで移行できますか?
既存設定によります。thinking.type="disabled"や強制的なtool_choiceを使う実装は変更が必要です。思考ブロックや履歴の処理、effort、出力上限も点検してから切り替えます。
effortは最大にしておけばよいですか?
最大がすべての用途で最適とは限りません。設定が上がると時間や使用量が増える場合があり、公式ベンチマークでもMaxがXhighを上回らない例があります。日常の仕事ではMediumなどから試し、合格しない課題で調整します。
まとめ:Claude Sonnet 5.5は実タスクの完了までで評価する
Claude Sonnet 5.5は、日常の範囲が決まった仕事を速く進めるAIモデルとして公開されています。Sonnet 5と入力・出力の単価は同じで、キャッシュ読み取りはSonnet 5.5のほうが安く、公式発表では出力速度とタスク当たりの効率の改善が示されています。
採用する際は、コード修正や資料作成など、繰り返す仕事を一つ選びます。入力と完了条件をそろえ、ツール実行、人の確認、再試行まで含む時間と費用を記録してください。複雑な判断を伴う仕事はOpus 5.5とも比較します。
API移行では、thinking、effort、強制ツール選択、会話履歴の扱いに差があります。旧設定をコピーして本番へ切り替える前に、検証環境で正常系と例外時の動作を確かめることが、導入後の手戻りを減らします。
AI活用の伴走支援をご検討の方へ
Sonnet 5.5を試したいものの、どの仕事を対象にすればよいか、既存システムとどうつなぐかが定まらない場合は、作業フローの整理から始める方法があります。
GiftX AIエージェント構築支援では、対象業務と入力データ、必要な連携、人が確認する工程を整理し、実装と運用の検証を伴走します。モデルを選ぶだけで終わらせず、仕事が完了する条件まで含めて仕組みにする支援です。
まずは繰り返している1業務を候補にし、現在の手順と困っている箇所を整理してください。小さな範囲で時間・費用・品質を検証したい方は、ぜひご相談ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら