Grok 4.7とは|コーディングと知識労働に強いSpaceXAIの最新モデル
Grok 4.7とは、SpaceXAI(旧xAI)が提供する、コーディングと知識労働向けの最上位AIモデルです。
関連記事:Grokとは?できること・使い方・料金とChatGPTとの違いを整理
発表の概要と提供元
Grok 4.7は2026年9月22日に発表されました。提供元のSpaceXAIは旧xAIとして知られる企業で、対話AI「Grok」シリーズを開発しています。公式発表では、同社がこれまでに作ったなかで最も性能の高いコーディングと知識労働向けのモデルと位置づけられています。
前世代のGrok 4.6は2026年8月に発表されたモデルで、わずか1か月あまりで後継が登場した形です。発表と同時にCursorとGrok Buildで使えるようになり、APIや他社の開発ツール、クラウド経由でも提供されています。
得意な作業|数時間かかるコーディングと資料作成
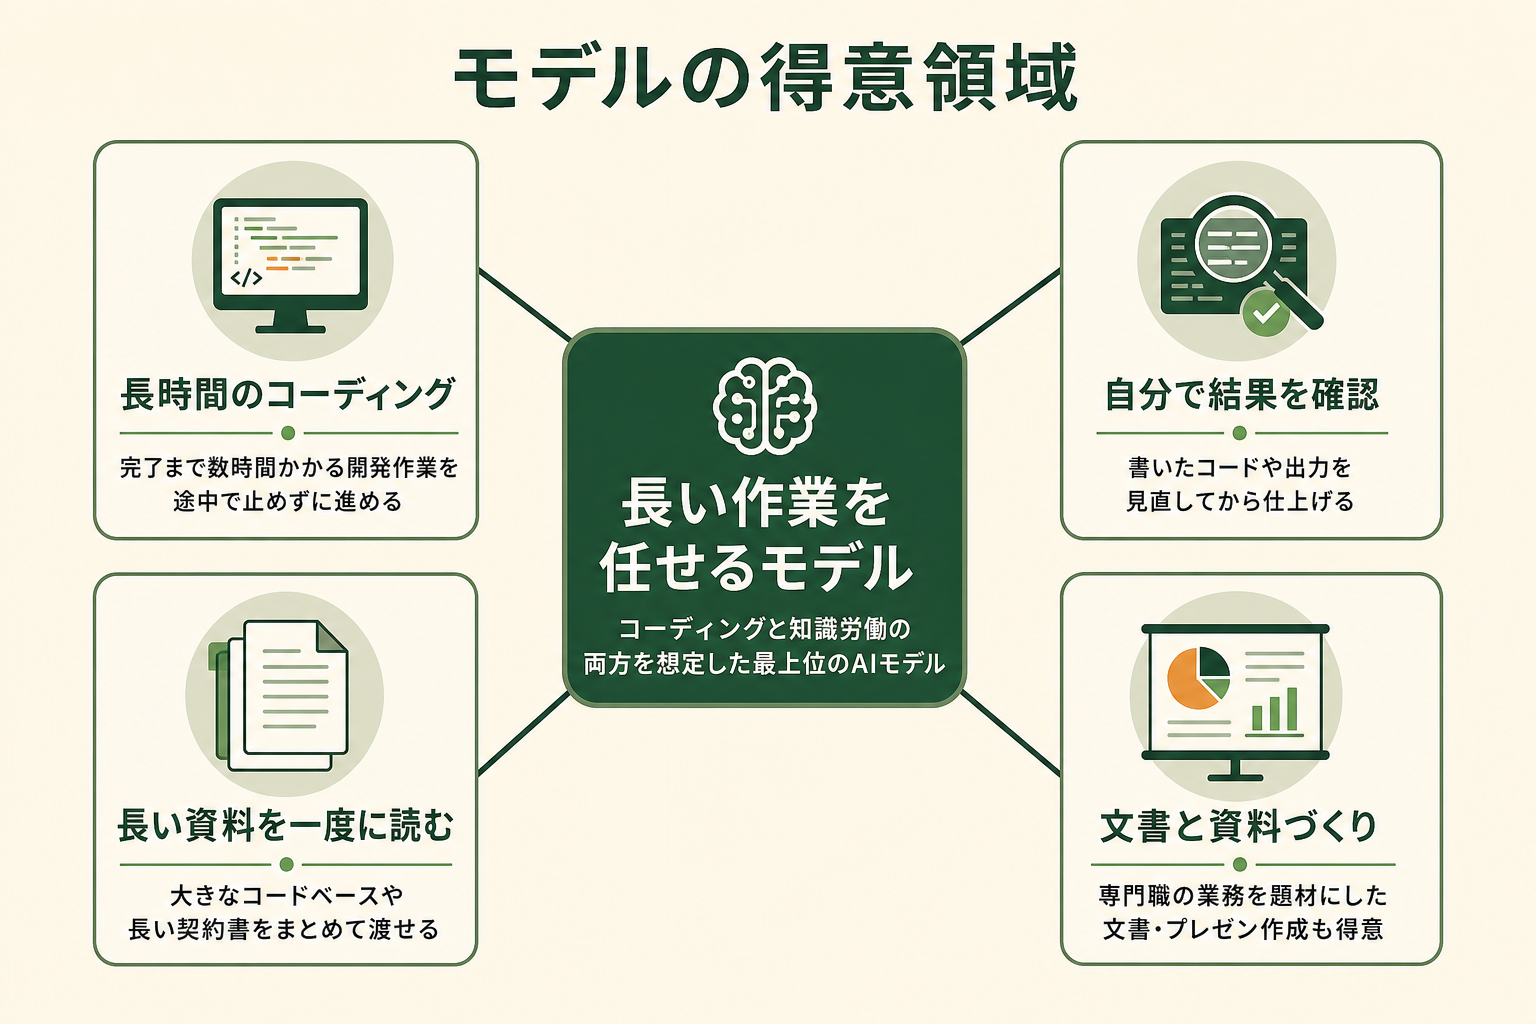
Grok 4.7が狙っているのは、1回の質問に答えるだけで終わらない、時間のかかる作業です。公式発表では、難しいタスクに長く取り組み、自分の作業をより丁寧に確認するようになったと説明されています。
コーディング以外では、文書やプレゼンテーション資料の作成能力が上がった点が強調されています。弁護士や看護師、金融アナリストなどの専門職が行う業務を題材にした評価で、Grok 4.6を上回る結果が示されました。開発チームだけでなく、調査レポートや提案資料をまとめる部門にも関わるモデルといえます。
Grok 4.7の基本仕様
Grok 4.7の主な仕様を、SpaceXAIの開発者向けドキュメントの記載をもとに整理します。APIでの呼び出し名や一度に扱える情報量など、導入前に確認しておきたい項目をまとめました(2026年9月時点、出典: x.ai)。
| 項目 | 内容 |
|---|---|
| APIでのモデル名 | grok-4.7 |
| 入力できるデータ | テキスト、画像 |
| コンテキストウィンドウ | 50万トークン |
| 推論の強さ(effort) | low / medium / high / xhigh の4段階(既定は high) |
| 学習データの期限 | 2026年5月 |
| 対応機能 | 関数呼び出し、構造化出力、推論 |
| Batch API | 非対応 |
| レート上限 | 毎秒150リクエスト、毎分5,000万トークン |
コンテキストウィンドウは、AIが一度に読み込める情報量の上限です。50万トークンあれば、大きめのコードベースや長い契約書を丸ごと渡せます。推論の強さは、回答前にどれだけ考えさせるかを選ぶ設定で、上げるほど精度が出やすい一方、処理時間と消費トークンが増えます。
画像を入力する場合は、jpg・png形式で1枚20MiBまでに収めます。枚数の上限は設けられていないため、画面のスクリーンショットや図表を複数まとめて渡す使い方もできます。
学習データの期限が2026年5月である点にも注意が必要です。それ以降の出来事は知らないため、最新情報が要る作業では、Web検索やX検索のツールを有効にして使います。
Grok(チャット)やGrok Botとの関係
SNSのX上やgrok.comで使う「Grok」は、対話型のAIアシスタントとしてのサービス名です。一方、Grok 4.7はその裏側で動くAIモデルの名前で、APIや開発ツールから呼び出して使います。
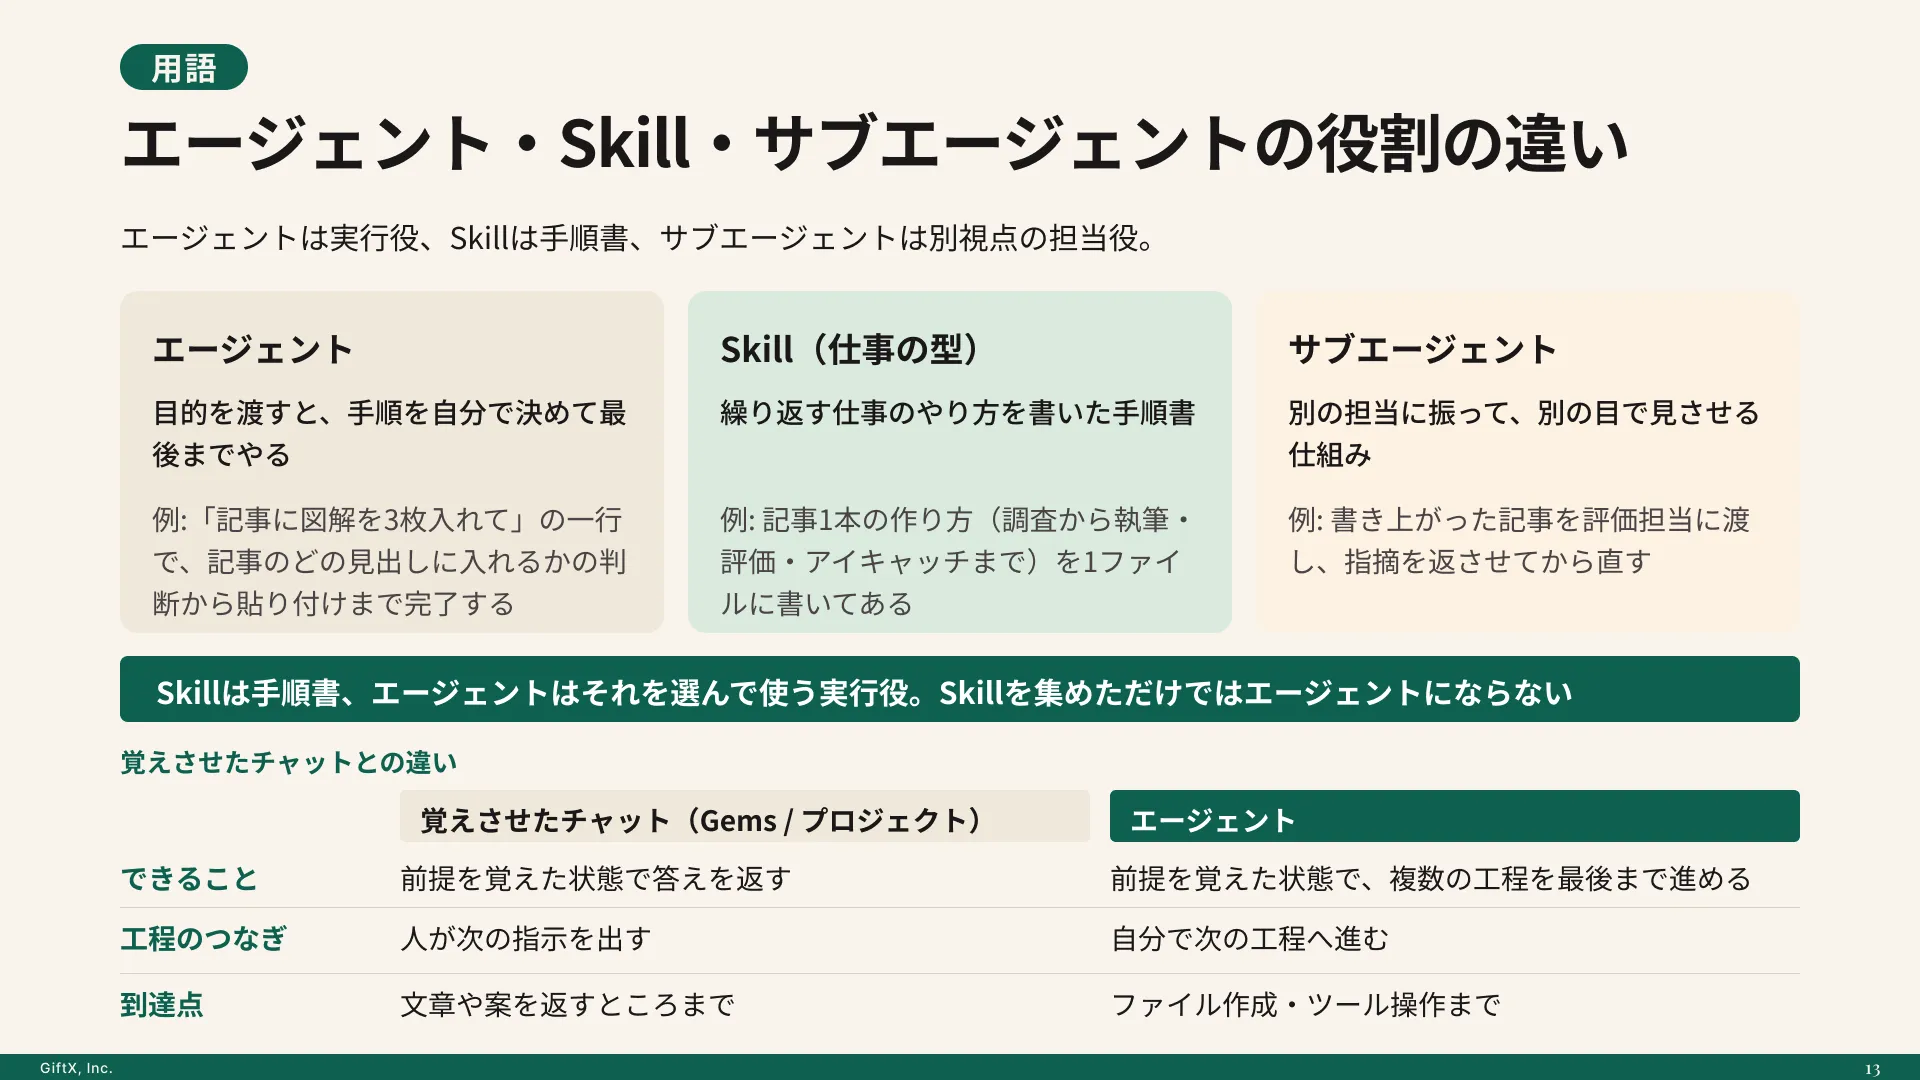
SpaceXAIは、常時稼働するAIエージェントのサービス「Grok Bot」も提供しています。AIエージェントとは、人の指示を受けて複数の工程を自律的に進めるAIの仕組みです。Grok 4.7はこのGrok Botの実行環境を前提に学習されており、会話を通じた作業や幅広い知識労働でも力を出しやすくなっています。
Grok 4.7はGrok 4.6から何が変わったのか|仕組みの変化とベンチマーク
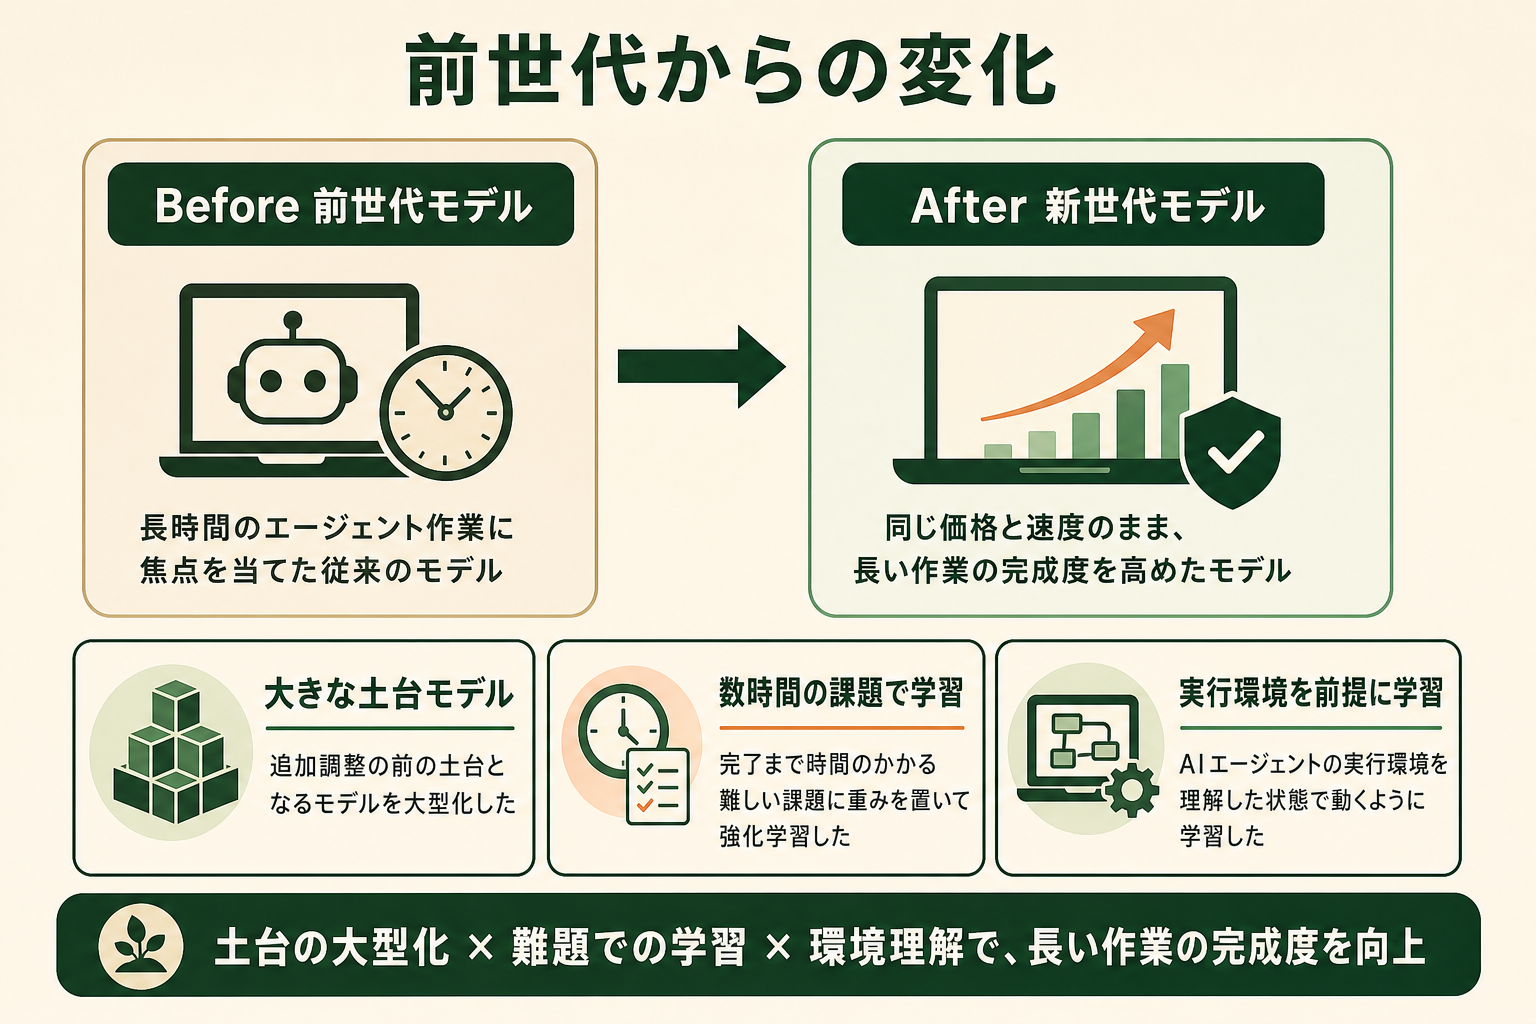
Grok 4.7の変化は、土台となるモデルの作り直しと、長い作業を前提にした学習の2点にまとめられます。ここでは公式発表の説明を仕組みごとに分け、最後にベンチマークと安全対策を見ます。
大きなベースモデルと長時間タスク中心の強化学習
Grok 4.7は、Grok 4.6より大きな新しいベースモデルを使っています。ベースモデルとは、追加の調整をする前の土台となるモデルです。
そのうえで、Grok 4.6より長い期間の強化学習を、難しいタスクの組み合わせで実施しました。強化学習は、結果の良し悪しを手がかりにAIの振る舞いを調整する学習方法です。題材は完了までに数時間かかる問題に重みを置いており、これが長時間の作業に強くなった理由とされています。
作業の自己検証と長い文脈の管理
Grok 4.7は、自分が出した結果を確かめる力と、長いコンテキストを扱う力が上がったと説明されています。コードを書いたあとに動くかを見直したり、長い資料の前半で決めた条件を後半まで守ったりする場面で差が出やすい部分です。
人が途中で確認し直す回数が減れば、同じ作業でもやり取りの往復が少なくなります。長い作業ほど、この自己検証の差が仕上がりに表れます。
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
Grok Botの実行環境を前提にした学習
Grok 4.7は、Grok Botのハーネスをもともと理解しているように学習されています。ハーネスとは、AIモデルに手順・道具・確認の仕組みを与えて、作業を進めさせる周辺の実行環境のことです。
この学習によって、会話形式のタスクや一般的な知識労働での扱いやすさも上がったとされています。コーディング専用ではなく、チャットでの作業全般に使えるモデルとして設計されている点が、Grok 4.6からの変化の一つです。
ベンチマークで見るGrok 4.6との差
SpaceXAIが公開したベンチマークを、Grok 4.6と他社の最上位モデルとあわせて整理します。推論の強さはGrok 4.7が xhigh、Grok 4.6が high、他社モデルが各社の最上位設定で測定されています(出典: x.ai)。
| ベンチマーク | 内容 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|---|---|
| CursorBench 4.0 | 長時間のコーディング | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | ソフトウェア開発 | 71.0%(high) | 65.2% | 72.7% | 70.0% |
| Terminal-Bench 4.0 | 数時間のターミナル作業 | 38.0% | 20.3% | 37.3% | 57.9% |
| EEBench | 電気工学 | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 数時間のオフィス業務 | 1,657 | 1,546 | 1,487 | 1,678 |
| Harvey Legal Agent Benchmark | 法務業務 | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 臨床での推論 | 56.7% | 48.5% | 60.5% | 62.1% |
上表のとおり、Grok 4.6と比べるとすべての項目で数値が伸びています。とくにTerminal-Bench 4.0は20.3%から38.0%へ大きく上がっており、長い作業を最後まで進める力の改善がはっきり表れています。
一方、他社モデルとの比較では項目ごとに順位が入れ替わります。電気工学や法務ではGrok 4.7が上回る一方、ターミナル作業や臨床推論ではClaude Fable 5.1が高い数値です。専門家の業務を題材にしたGDPvalの評価でも、Grok 4.7は1,695点でClaude Fable 5.1の1,735点に次ぐ位置でした。自社で任せたい作業に近い項目を見て判断するのが確実です。
関連記事:Grok 4.6とは?Grok 4.5からの進化点・ベンチマーク・料金を整理
安全対策の刷新
Grok 4.7では、安全対策の仕組みが一から作り直されました。公式発表では、拒否すべき依頼への対応と、制限を外そうとする入力への耐性で、同社がテストしたなかで最も強いモデルと説明されています。
生物分野の安全性を測る外部評価では62.4%を記録し、悪用のおそれがあるサイバー関連の依頼を通してしまう割合は3.3%にとどまりました。正当なセキュリティ業務は妨げにくいよう調整されており、一部のセキュリティ企業には防御研究向けの機能が招待制で提供されています。
Grok 4.7の料金|API単価はGrok 4.6と同じ
Grok 4.7のAPI料金は、入力100万トークンあたり2ドル、出力100万トークンあたり6ドルです(2026年9月時点、出典: x.ai)。Grok 4.6と同じ単価で、速度も同等とされています。
| 区分 | 100万トークンあたりの単価 |
|---|---|
| 入力 | 2ドル |
| キャッシュされた入力 | 0.50ドル |
| 出力 | 6ドル |
| 高速版(出力速度2倍) | 通常版の2倍 |
キャッシュされた入力とは、同じ前置きや資料を繰り返し送るときに、再利用分として安く計算される部分です。長い指示文を毎回付ける使い方では、コストを大きく下げられます。
ただし、20万トークンを超えるリクエストには通常と異なる単価が設定されています。50万トークンまで読み込めるからといって毎回大量に渡すと、想定より費用がかさむ点に注意が必要です。発表資料では、GPT-5.6 Solの入力4ドル・出力20ドル、Claude Fable 5.1の入力10ドル・出力50ドルと並べられており、単価の低さが強調されています(2026年9月時点、出典: x.ai)。
Grok 4.7の使い方|Cursor・Grok Build・APIから試す
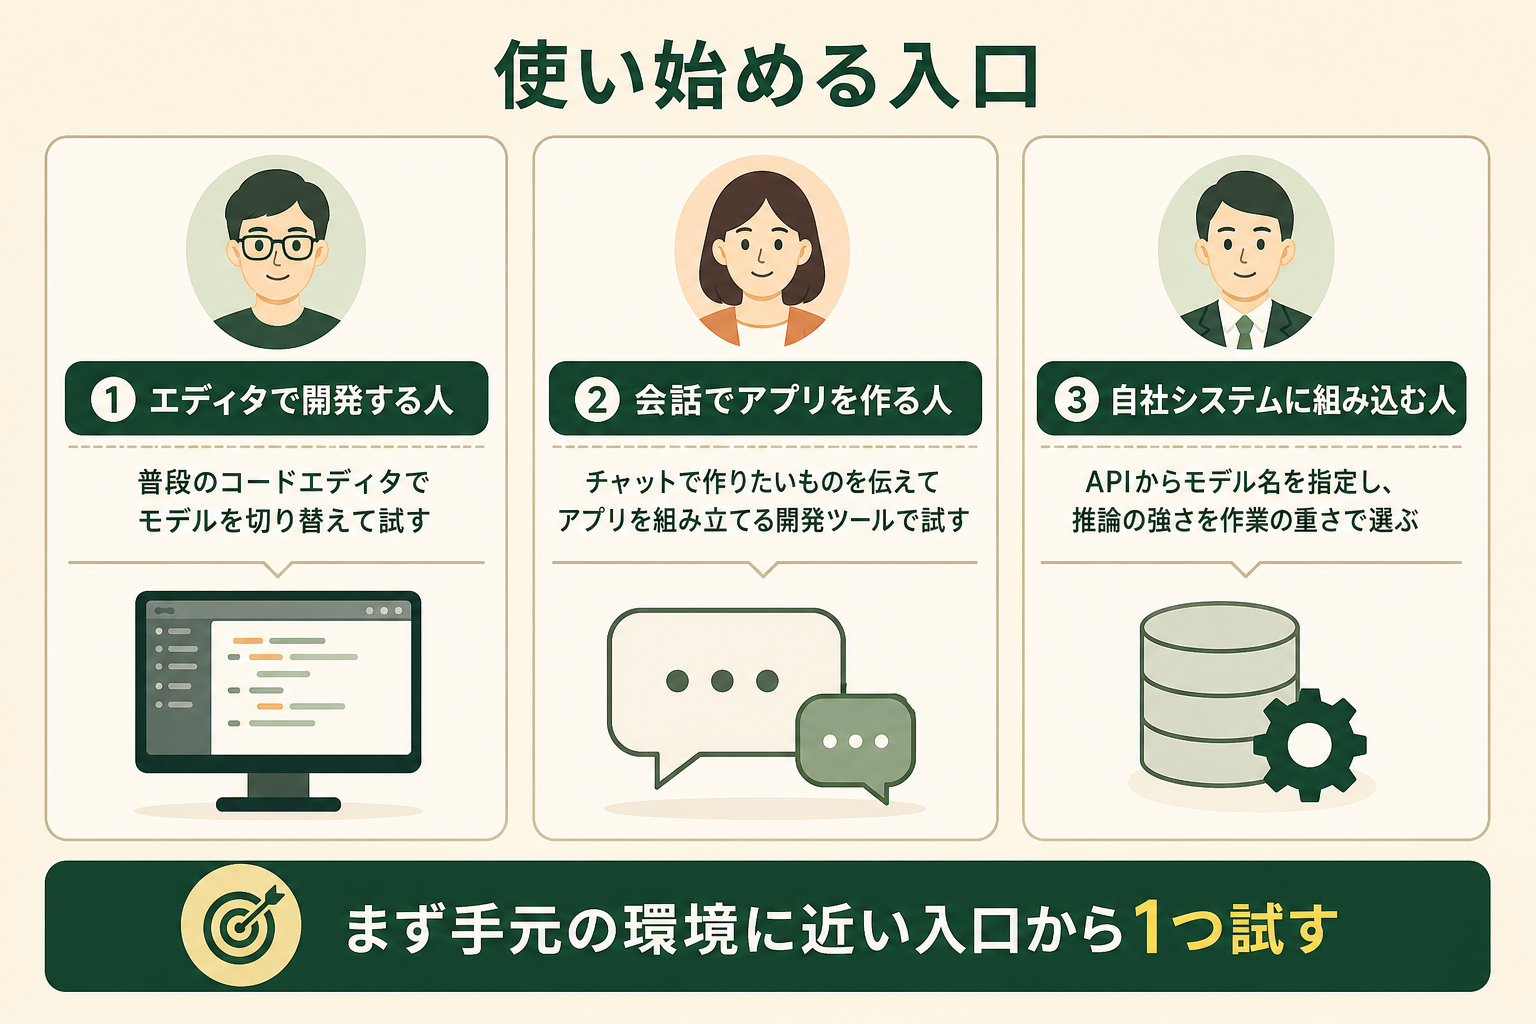
Grok 4.7は、Cursor、Grok Build、Grok APIのほか、他社のコーディング支援ツールやモデルを切り替えて使えるサービス、クラウド経由でも使えます。まずは手元の環境に近い入口から1つ選ぶと、準備に時間をかけずに試せます。
Cursorで使う
Cursorは、AIを組み込んだコードエディタです。モデルの選択肢からGrok 4.7を選ぶだけで、普段のエディタのまま試せます。すでにCursorでGrok 4.6や他社モデルを使っている場合は、同じタスクを切り替えて比べると違いを確かめやすくなります。
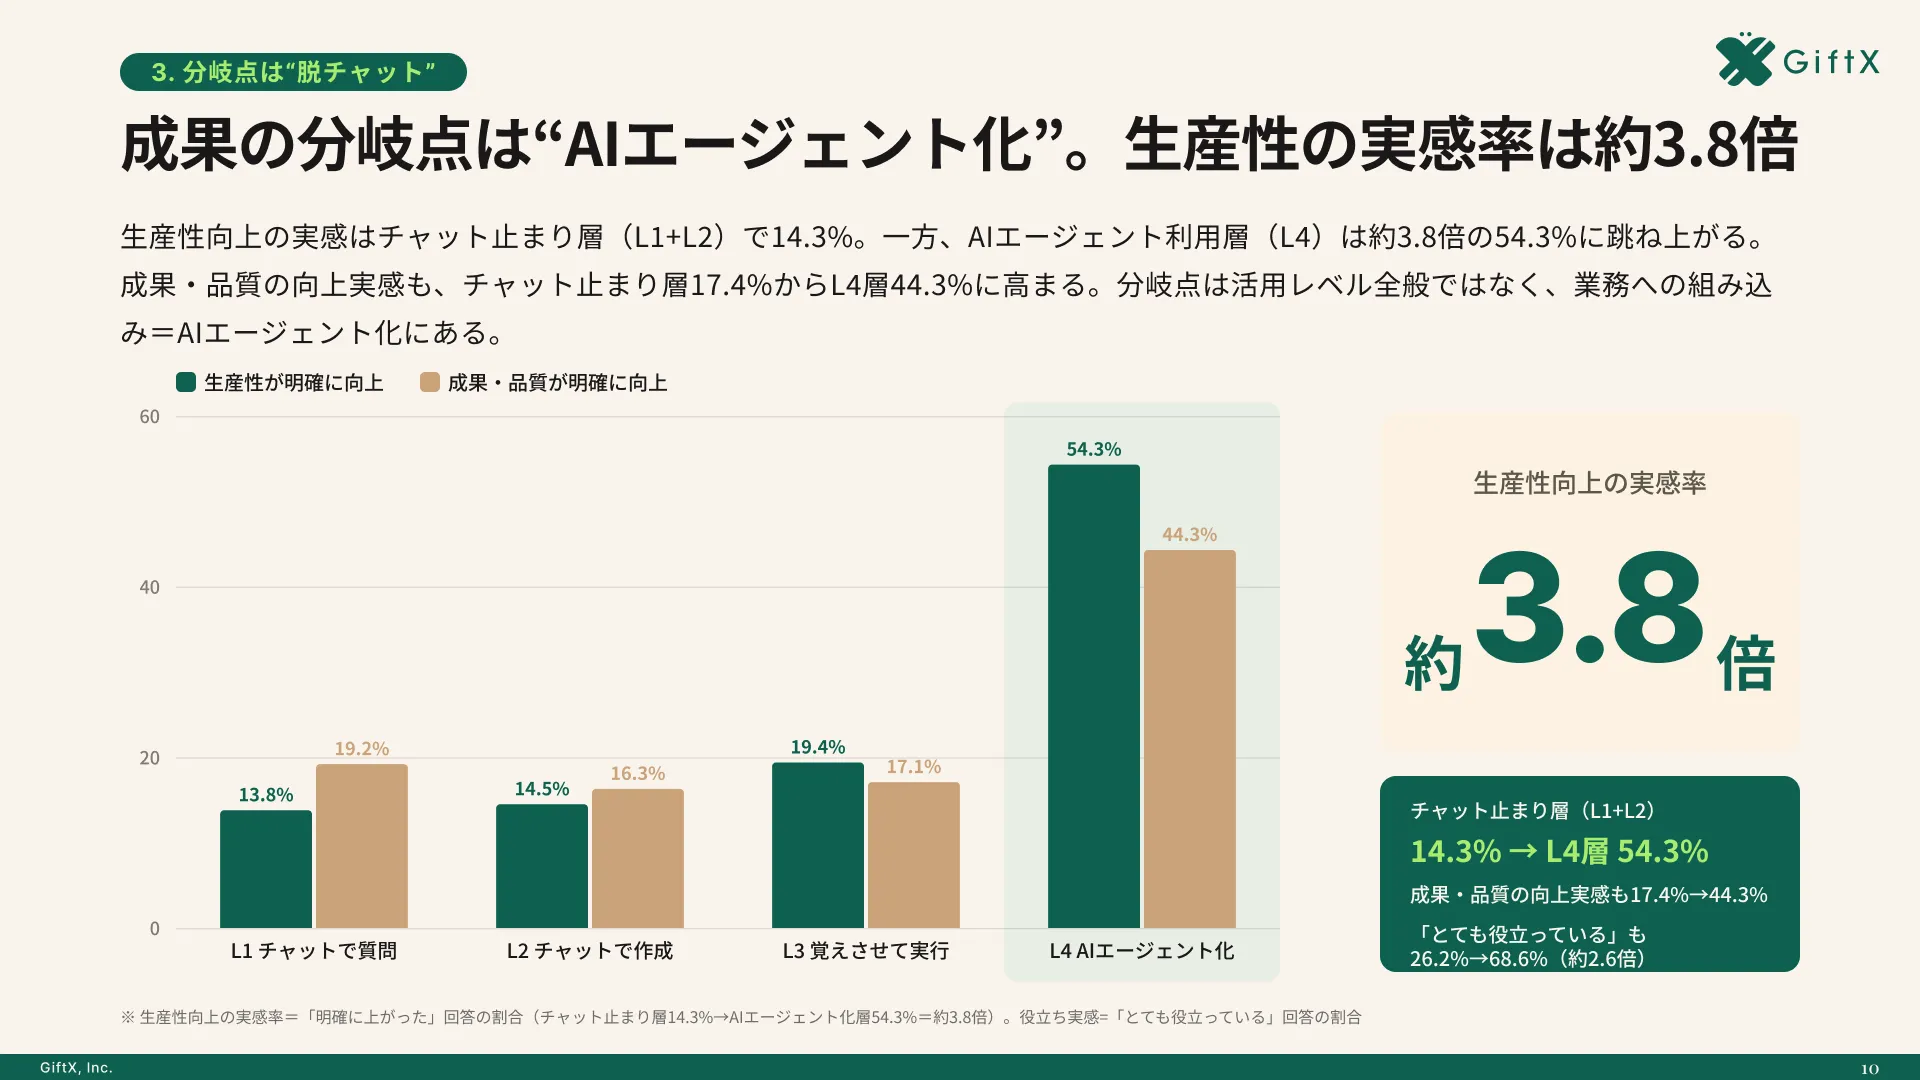
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
Grok Buildで使う
Grok Buildは、SpaceXAIが提供するAI開発ツールです。チャットで作りたいものを伝えてアプリを組み立てる使い方と、ターミナルで動くコーディングエージェントとしての使い方があります。公式発表では、Grok BuildでGrok 4.7を無料で試せると案内されています。
関連記事:Grok Buildとは?アプリ構築とターミナル版の違い・使い方を整理
APIで使う
自社のシステムに組み込む場合は、SpaceXAIのAPIからモデル名「grok-4.7」を指定して呼び出します。APIとは、プログラムから機能を呼び出すための接続口です。
推論の強さは既定で high になっており、簡単な処理では low や medium に下げると応答が速くなり、消費トークンも抑えられます。難しいタスクだけ xhigh に上げるといったように、処理の重さで使い分けるとコストを管理しやすくなります。
Grok 4.6からGrok 4.7へ乗り換えるべきか
料金が同じなので、Grok 4.6を使っている場合は乗り換えを前向きに検討してよい状況です。とくに数時間かかるコーディングや、長い資料をもとにした文書作成では、自己検証と長い文脈の管理が強化された効果を受けやすくなります。
一方で、すぐに全面移行するより、まず手元の代表的なタスクで比べるほうが安全です。これまでの指示文で出力の形式が変わらないか、推論の強さを上げたことで消費トークンが増えていないかを確かめます。Batch APIでまとめて処理している場合、Grok 4.7は非対応である点も確認が要ります。
ターミナル作業や臨床系の推論のように、ベンチマークで他社モデルが上回る領域もあります。モデルを1つに固定せず、作業ごとに向いているものを選ぶ前提で比較しておくと判断しやすくなります。
新しいAIモデルで業務を任せ始めるときに陥りがちな3つの落とし穴
新しいモデルが出ると、性能の数値に目が向きやすくなります。ただ、業務で成果につなげるには、モデル選び以上に任せ方の設計が効いてきます。
落とし穴1|新しいモデルが出るたびに全業務を一斉に切り替える
新モデルの評判を見て、使っているツールや業務を一度に切り替えると、どこで品質が変わったのかを追えなくなります。比較の基準が崩れ、問題が起きても原因を切り分けられません。
落とし穴2|ベンチマークの比較から入り、自社業務での検証が始まらない
公開されたベンチマークは参考になりますが、自社の作業にそのまま当てはまるとは限りません。どのモデルが最適かを机上で決めようとするほど、実際に試す段階が遠のきます。
落とし穴3|チャットで試すだけで、業務の流れに組み込まない
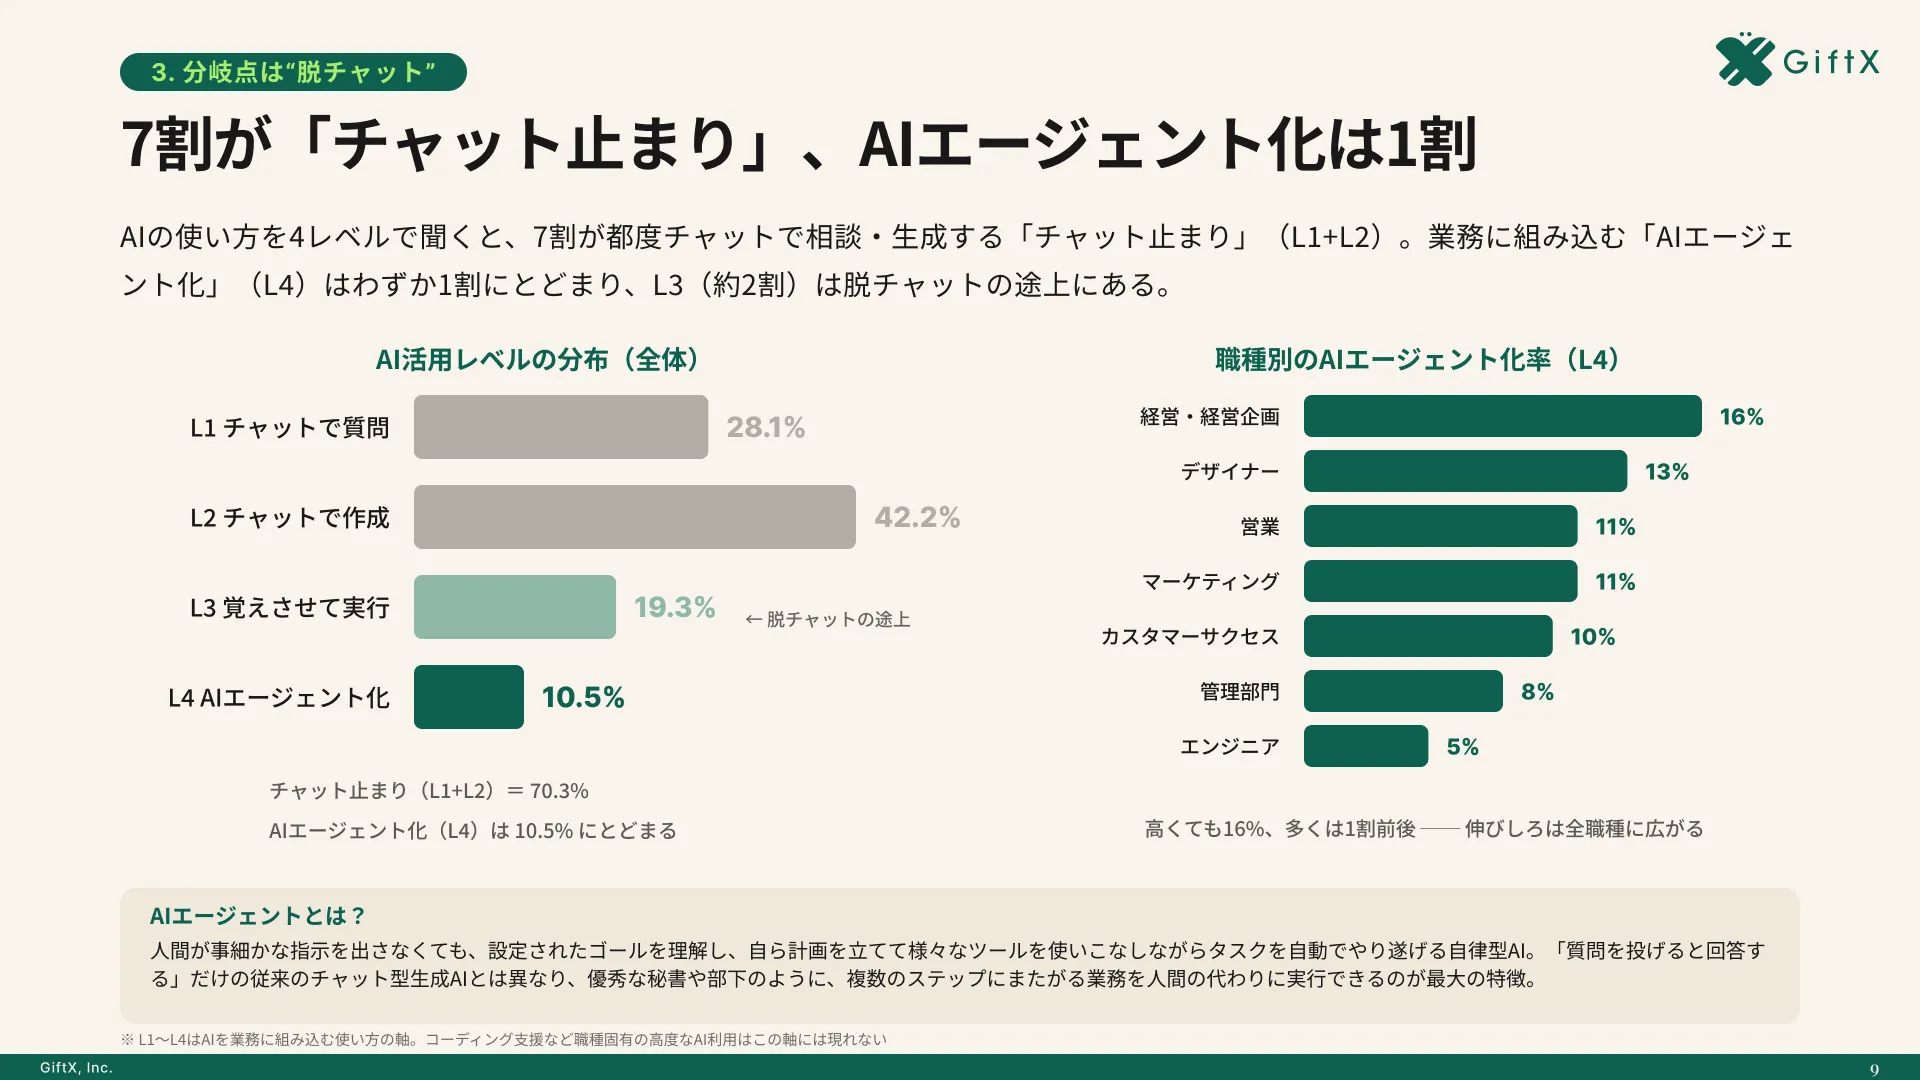
チャット画面で質問するだけでは、長い作業を任せられるモデルの強みを活かしきれません。GiftXの調査では、エンジニアのAI利用率は74.7%と7職種で最も高い一方、AIエージェントに業務を任せる段階まで進んでいる人は5%にとどまりました。
詳細な調査データは「ビジネス職生成AI活用実態調査(2026年版)」にてご覧ください。
スモールスタートで1業務をAIエージェントに任せる
モデルの性能を業務の成果に変えるには、スモールスタートで1業務をAIエージェントで自動化・効率化することがポイントです。GiftXでも、AIコーディングエージェントに実装とテストを任せ、人は要件の整理とレビューに集中する形で、機能追加1件あたり平均2日かかっていた作業を平均半日に短縮しています。
GiftXでは、こうしたスモールスタート前提のAIエージェント構築を1業務単位から伴走支援しています。詳細は AIエージェント構築支援サービス をご覧ください。
Grok 4.7のよくある質問
Grok 4.7はいつから使えますか?
2026年9月22日の発表と同時に提供が始まっています。CursorやGrok Build、APIなどの対応環境からすぐに利用できます。
Grok 4.7は無料で使えますか?
2026年9月時点で、恒常的な無料枠は発表されていません。APIは従量課金で、CursorやGrok Buildは各サービスの料金体系に従います。公式発表では、Grok BuildでGrok 4.7を無料で試せると案内されています。
Grok 4.6は引き続き使えますか?
2026年9月時点で、Grok 4.6の提供終了は発表されていません。APIではモデル名を指定して呼び出すため、利用できるモデルの一覧を確認したうえで、一部のタスクだけGrok 4.7に切り替えて試せます。
推論の強さはどれを選べばよいですか?
既定は high です。短い質問や定型処理なら low か medium、数時間かかる開発や調べものなら xhigh と、作業の重さで選びます。上げるほど精度が出やすい一方、応答時間と費用が増えます。
まとめ|Grok 4.7は長い作業を任せたいときの有力な選択肢
Grok 4.7は、大きな新ベースモデルと長時間タスク中心の学習によって、コーディングと知識労働の両方でGrok 4.6から性能を伸ばしたモデルです。API料金は据え置かれており、既存のGrok 4.6ユーザーにとっては試すハードルが低い状況です。一方、ベンチマークでは他社モデルが上回る領域もあるため、自社の作業に近い項目で判断するのが確実です。導入を進める際は、全業務を一度に切り替えず、スモールスタートで1業務をAIエージェントに任せるところから始めると、効果を確かめながら広げていけます。
AI活用の伴走支援をご検討の方へ
本記事で紹介したAIモデルやAIエージェントの活用に向けて、自社の業務でも具体的に進めたい・相談したいとお考えの方は、ぜひGiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせて1業務単位のスモールスタートから本番運用まで、AIエージェント構築をワンストップで支援します。ユースケースの洗い出しから、PoC、本番運用、社内ナレッジ化まで伴走します。
AI活用にご関心のある方は、ぜひ一度ご相談ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら