ChatGPTが回答を作る仕組みを5ステップで図解

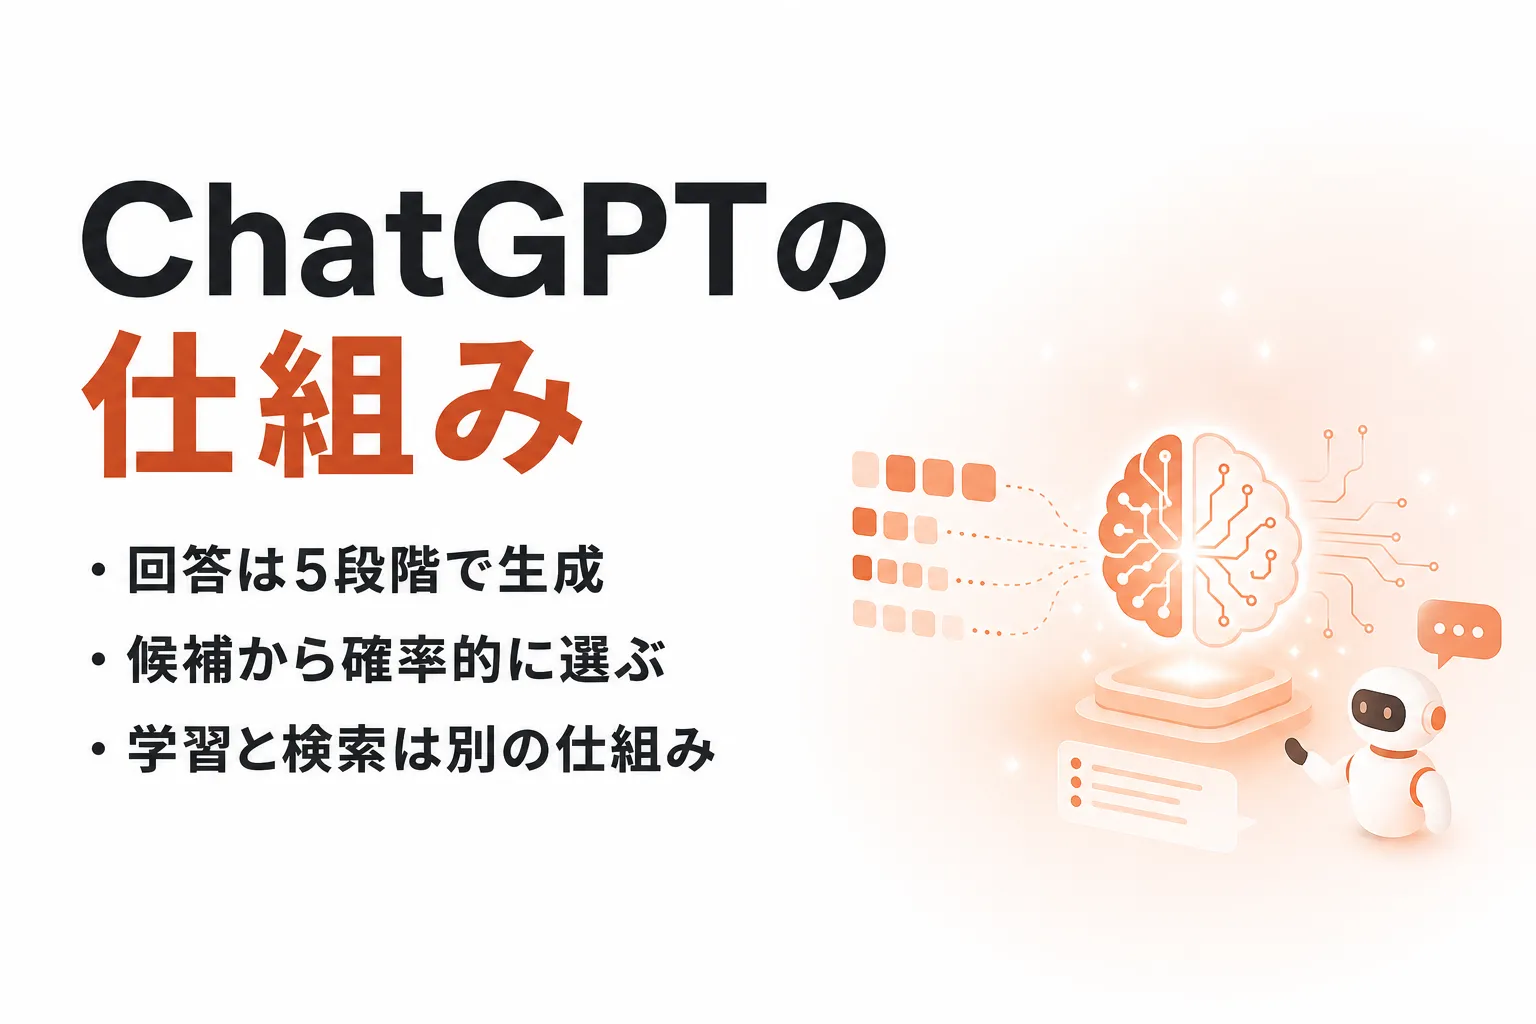
ChatGPTは、OpenAIが提供する対話型の生成AIサービスです。回答を作る基本は「文章の続きを一度に完成させる」ことではありません。入力と、それまでに生成した内容を手がかりに、次に置く小さな単位を予測して追加する処理を繰り返します。
ステップ1|入力をトークンに分ける
利用者が入力した文章は、まずトークンと呼ばれる処理単位に分けられます。トークンは必ずしも1単語ではなく、日本語では文字や短い語のまとまり、英語では単語や単語の一部になることがあります。モデルは文章をそのまま読むのではなく、各トークンを数値表現へ変換して扱います。
ステップ2|Transformerが文脈を処理する
数値化されたトークンは、モデルの土台であるTransformerへ渡されます。Transformerは、入力中のどの部分が互いに関係しているかを計算し、質問の条件や直前までの会話を踏まえた文脈表現を作ります。
ステップ3|次のトークンの確率分布を計算する
モデルは文脈をもとに、次に続き得るトークンごとの確率分布を計算します。ここで得られるのは「正解の1語」ではなく、複数候補と、それぞれが続きとしてどの程度あり得るかという分布です。
ステップ4|分布から1つを選ぶ
生成時には、確率分布を使って次のトークンを選びます。常に確率が最大の候補だけを選ぶとは限りません。候補の選び方に幅を持たせることで、同じ入力からも表現の異なる回答が生まれます。
ステップ5|選んだトークンを加えて繰り返す
選ばれたトークンを文末へ追加し、更新された文脈で次の確率分布をもう一度計算します。終了を示すトークンが選ばれるか、出力上限などの条件に達するまで、この処理を繰り返して回答を組み立てます。この方式は自己回帰生成と呼ばれます。
「GPT」は何の略か
ChatGPTの「GPT」は、Generative Pre-trained Transformer(生成可能な、事前学習済みの、トランスフォーマー)の頭文字です。3つの言葉はそれぞれ性質を表しています。Generativeは「文章を生成する能力が高いこと」、Pre-trainedは「大量のデータであらかじめ学習を済ませていること」、Transformerは「その学習に使われたAIの構造の名前」を意味します。
GPT・大規模言語モデル(LLM)・生成AIの関係
仕組みを理解するうえで混同しやすいのが、関連する言葉どうしの関係です。もっとも広い概念が生成AIで、その中に大規模言語モデル(LLM、Large Language Model、膨大なテキストを学習した言語処理のAI)が含まれます。GPTはこのLLMの一種で、ChatGPTはGPTを「対話用に調整した製品」という位置づけになります。LLM自体はChatGPTだけのものではなく、ほかの対話型AIサービスにも共通する基盤技術です。整理すると、生成AIという大きな枠の中にLLMがあり、そのLLMの代表例がGPTで、GPTを誰でも使いやすい対話サービスに仕立てたものがChatGPT、という入れ子の関係になります。「ChatGPT=GPT=LLM=生成AI」とすべてを同じ意味で使う説明も見かけますが、厳密には対象とする範囲が異なるため、仕組みを語るうえではこの階層を区別しておくと混乱を避けられます。
関連記事:生成AIの種類とは?主要6カテゴリと代表サービスを一覧で解説
Transformerが文脈を捉える仕組み

ChatGPTの仕組みを語るうえで欠かせないのが、Transformer(トランスフォーマー)と呼ばれるAIの構造です。2017年に発表されたTransformerの論文では、アテンションを中心に系列データを処理する設計が示されました。この構造により、入力中の離れた位置にある情報の関係も計算しやすくなり、大規模な言語モデルの学習を支える土台になりました。
アテンション機構が文脈上の関係を計算する
Transformerの中核にあるのが、アテンション機構(注意機構)です。これは文章の中で「どのトークンが、ほかのどのトークンと強く関係するか」を重みとして計算する仕組みです。たとえば、同じ語でも周囲の語によって指す内容が変わる場合、前後の情報との関係が次トークンの予測に反映されます。
アテンションは、人間と同じ方法で意味を理解していることの証明ではありません。一方で、入力内の関係を計算し、質問の条件や代名詞の参照先などを生成へ反映するうえで重要な役割を果たします。
ChatGPTが学習・調整される仕組み

ChatGPTの学習工程は、固定された普遍的な「3段階」と考えるより、土台を作る事前学習と、対話サービスとして振る舞いを整える事後学習に分けると理解しやすくなります。実際の工程や手法はモデル世代によって変わり得るため、特定の調整方法だけをChatGPT共通の手順とみなさないことが大切です。
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
事前学習|大量のテキストから言語パターンを学ぶ
事前学習では、大量のテキストを使った次トークン予測を通じて、言葉の使われ方、文章構造、概念同士の関係などをモデルのパラメータへ反映します。この工程で得るのは資料を検索できる索引ではなく、文脈に応じた続きを計算するためのパターンです。そのため、学習した内容を正確な出典付きで取り出せるとは限りません。
事後学習|指示追従や安全性を整える
事後学習では、お手本となる応答や人・AIによる評価などを使って、指示に沿う能力、役立ち方、安全性を調整します。代表的な研究例として、人のフィードバックを使ったInstructGPTがありますが、すべての現行モデルが同じ工程だけで作られているという意味ではありません。
会話した内容がその場でモデルの再学習になるわけではない
現在の会話内容が文脈として参照されることと、その場でモデル本体のパラメータが更新されることは別です。会話履歴やメモリ機能によって過去の情報が応答に使われる場合でも、それだけで即時に事前学習や事後学習がやり直されているわけではありません。
ChatGPTの回答が毎回変わる理由
ChatGPTは次トークンの確率分布から候補を選ぶため、同じ質問でも表現や例が変わることがあります。常に最大確率の候補だけを選ぶ決定的な方法に限定すると文章が単調になりやすく、一定の幅を持たせると多様な回答を作れます。確率分布から候補を選ぶ代表的な考え方は、言語モデルのサンプリング研究でも整理されています。
この揺らぎは創造的な案出しでは利点になりますが、数値や規程など再現性が必要な業務では注意点です。重要な条件をプロンプトに明記し、出力形式を固定し、別の資料で検証する運用が必要になります。
Web検索・RAG・ツール利用は基本モデルとどう違うか
次トークン生成だけでは、学習後の最新情報や社内の非公開情報を自動では参照できません。そこで、ChatGPTの周辺機能やAIシステムでは、必要な情報や操作手段を外から与える仕組みが組み合わされます。
- Web検索:検索結果を取得し、その内容を回答の文脈へ加える
- RAG:社内文書などから関連箇所を検索し、根拠としてモデルへ渡す
- ツール利用:計算、ファイル操作、外部サービスへの処理などをモデル外の機能へ依頼する
いずれも、検索や操作そのものを次トークン予測だけで代替するのではなく、取得した結果をモデルが読んで回答や次の行動を組み立てる構成です。したがって、検索結果が不十分なら回答も不十分になり、ツールの実行権限や確認手順にも別の安全設計が必要です。
仕組みから見えるChatGPTの限界と注意点
ChatGPTの仕組みを理解すると、その強みだけでなく、避けられない限界も見えてきます。これらは使い方の工夫で軽減できる部分もあり、業務に取り入れる前に押さえておきたいポイントです。
なぜハルシネーション(もっともらしい誤り)が起きるのか
ChatGPTは、文脈に続くトークンの分布から文章を生成します。文章として自然であることと、内容が事実であることは同じではありません。そのため、存在しない出典や誤った数値を、もっともらしい形で生成することがあります。これはハルシネーション(もっともらしい誤り)と呼ばれ、重要な情報は一次資料で裏取りする前提が欠かせません。
知識カットオフ:最新情報に弱い理由
モデルが持つ知識は、学習に使われたデータと調整の範囲に左右されます。学習後に起きた出来事や、公開されていない社内情報をモデル本体が自動で知ることはできません。最新情報を扱う場合はWeb検索、社内情報を扱う場合は権限管理されたRAGなどを併用し、参照元を確認する必要があります。
業務利用で押さえておきたいリスク
仕組み上の限界に加えて、運用面の注意点もあります。機密情報や個人情報は、契約プラン、データ利用設定、保存期間、接続する外部ツールの権限を確認してから扱う必要があります。また、学習データや評価方法に含まれる偏りが回答へ表れる場合もあります。最終判断と結果確認を人が担うことが、安全に活用する基本です。
仕組みを理解するとChatGPTはもっと使いこなせる
仕組みがわかると、ChatGPTを「なんとなく便利な道具」から「特性を踏まえて使い分けられる道具」へと位置づけ直せます。ここでは、理解が実際の使い方にどう活きるかを整理します。
プロンプトの工夫が効く理由がわかる
ChatGPTは直前までの文脈をもとに次の単語を予測するため、与える指示や前提情報が具体的なほど、出力も狙いに近づきます。役割や条件、出力の形式をあらかじめ伝えると精度が上がるのは、文脈が予測の手がかりになるという仕組みから説明できます。プロンプトの工夫が効くのは、こうした理由があるからです。
関連記事:ChatGPTの使い方|初心者が今日から実践できる5つのプロンプトのコツ
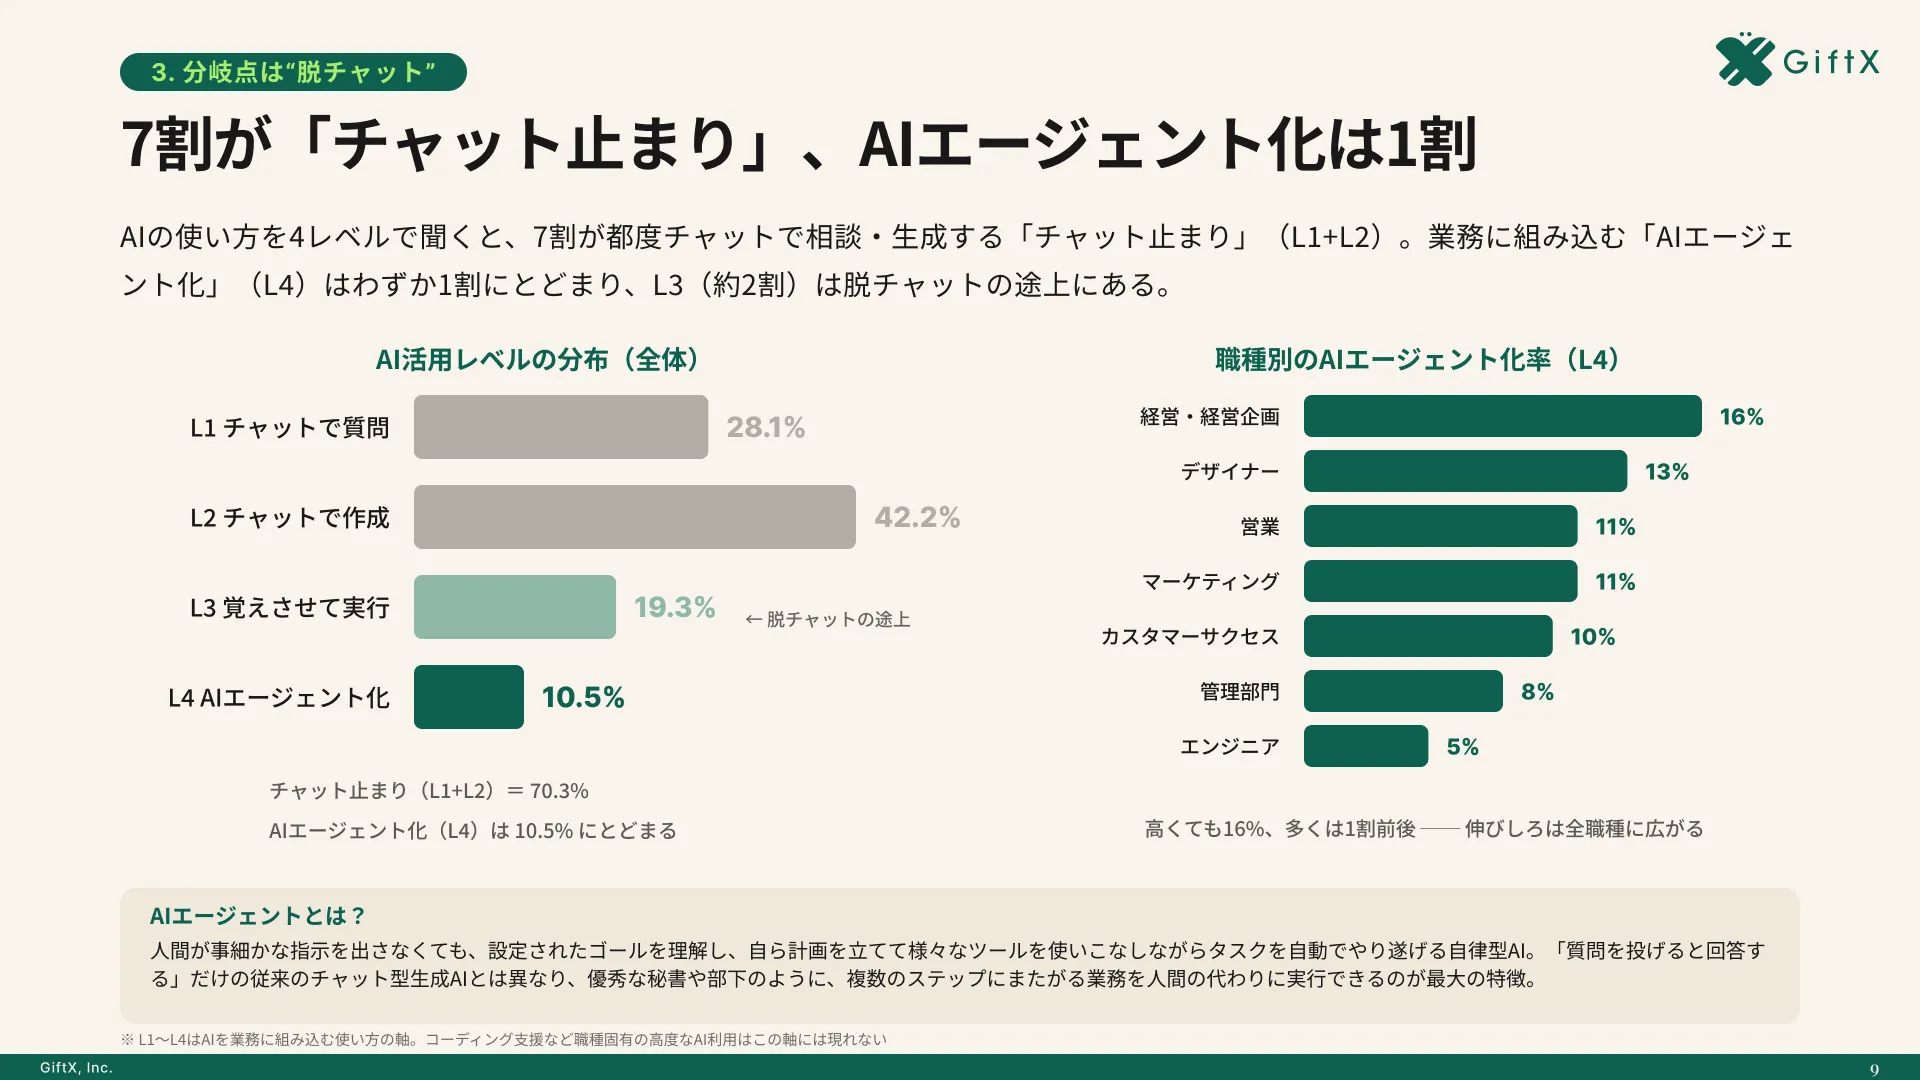
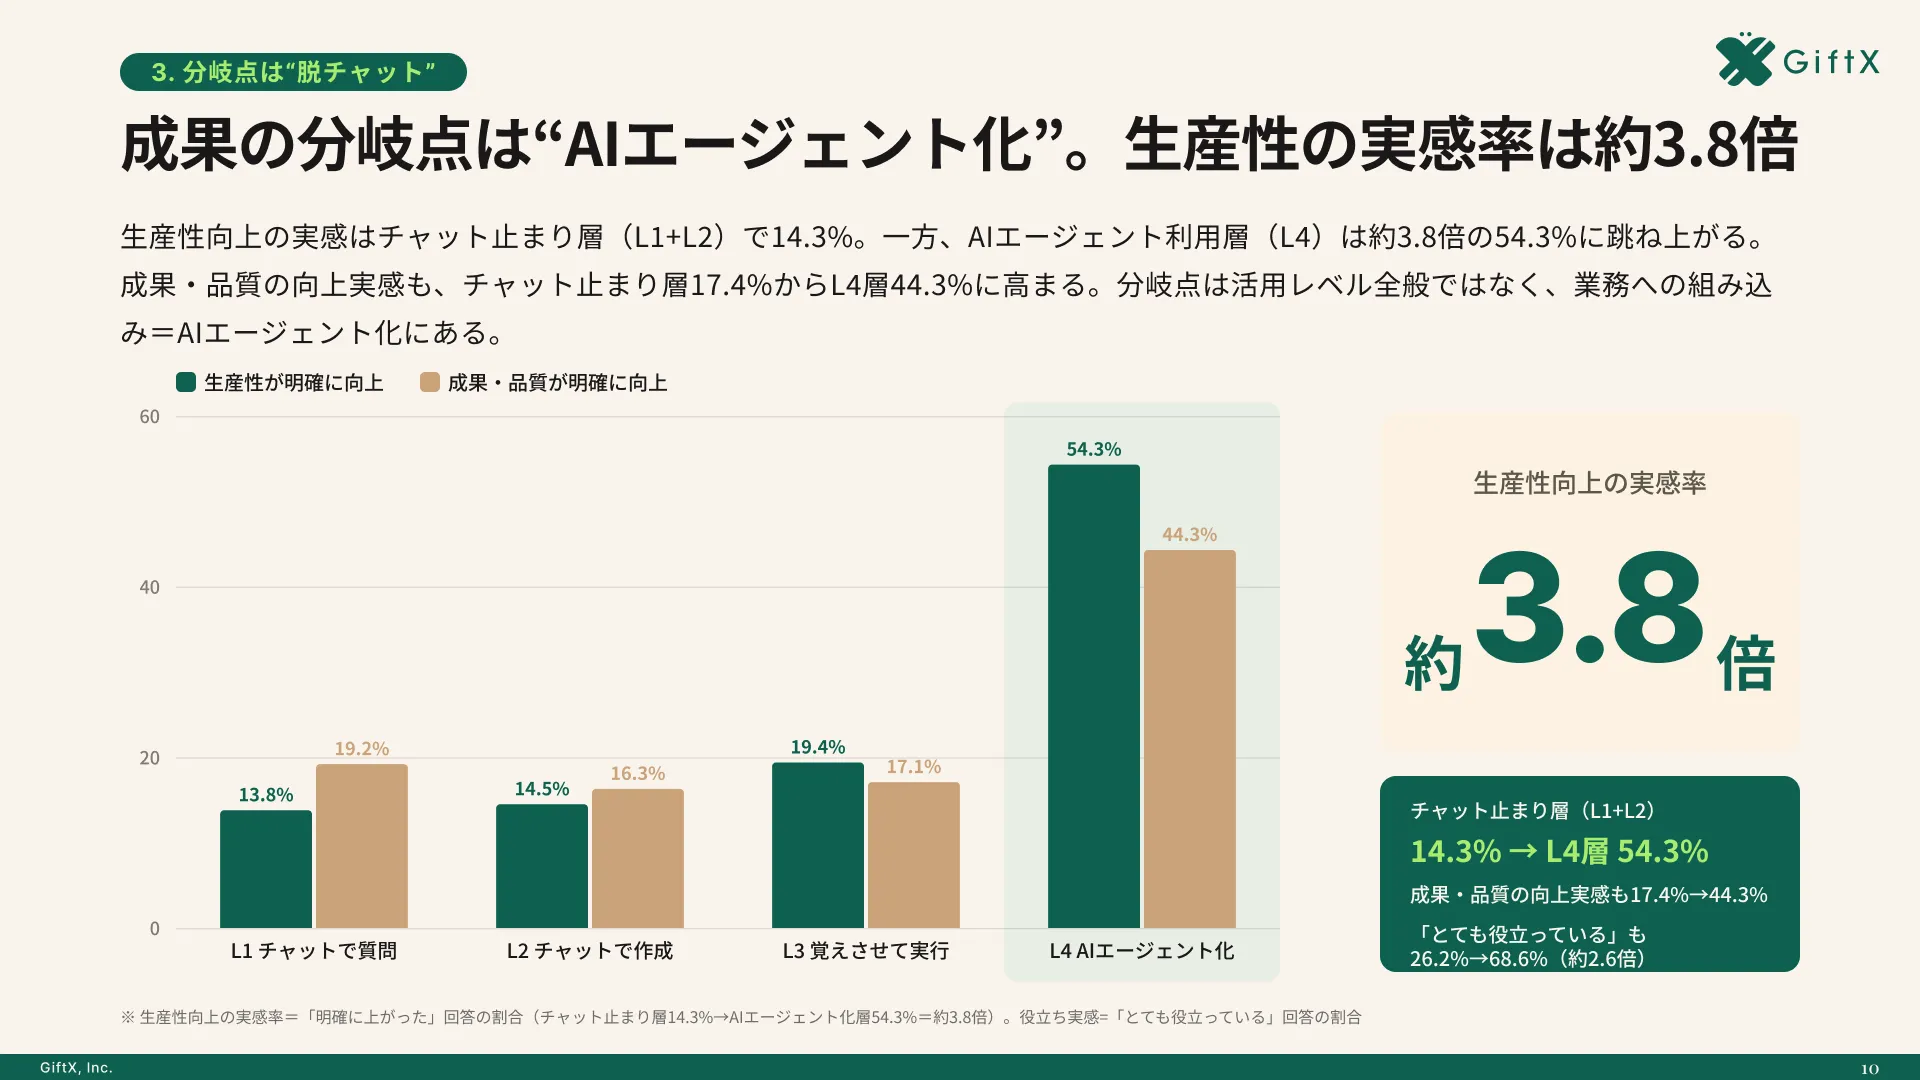
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
進化を続けるモデルと、変わらない基本
ChatGPTのモデルは継続的に新しい世代へと更新され、扱える文章量や回答の精度は年々向上しています。一方で、「文脈をもとに次の単語を予測する」という基本の仕組みは大きく変わっていません。モデル名や性能の違いに振り回されず、土台となる考え方を押さえておくことが、長く使いこなすうえでの近道になります。
関連記事:ChatGPTとは?できること・新機能・料金プランを解説
ChatGPTの仕組みを理解したうえでAI活用を始めるときに陥りがちな3つの落とし穴
仕組みを理解すると、ChatGPTをはじめとするAIを自社で活用したくなる方も多いはずです。ただし、いざ取り入れようとすると、技術そのものよりも進め方でつまずくケースが目立ちます。仕組みがわかっても、どの業務にどう適用するかという設計を誤ると、期待した効果につながりません。ここでは、AI活用を始める段階でとくに陥りやすい共通のパターンを3つ取り上げ、それぞれの回避の考え方を整理します。
落とし穴1 いきなり全てをやろうとする
仕組みを理解すると応用の幅広さが見えてくるぶん、最初から複数の領域を一気にAI化しようとしがちです。しかし対象を広げすぎると、出力の検証や運用ルールづくりが追いつかず、かえって現場が混乱します。前述のとおりChatGPTは確率で言葉を選ぶ性質上、出力の確認作業が必ず発生します。対象が多いほどこの確認負荷も増えるため、まずは効果を確かめやすい1つの作業に絞ることが、結果的に定着への近道になります。
落とし穴2 壮大なAI戦略から考えて手が止まる
「全社のAI戦略を固めてから着手したい」と考えすぎると、計画づくりだけで時間が過ぎ、いつまでも実行に移れません。AIの精度や使い勝手は実際に試してみないと判断が難しく、机上の検討だけでは適否を見極められないのが実情です。小さく試して学びながら広げるほうが、現場の納得も得やすく、結果的に早く成果につながります。完璧な計画よりも、まず動かして得られる学びを重視する姿勢が向いています。
落とし穴3 既製のチャット型AIだけでは業務フローに組み込めない
ChatGPTのような汎用のチャット型AIは手軽に試せる一方、自社の業務手順やデータに合わせた作り込みが難しく、毎回手作業で指示文を打ち込んだり結果を貼り付けたりする使い方に留まりがちです。これでは一部の作業は速くなっても、業務全体の流れはなかなか変わりません。継続的に成果を出すには、必要な情報を自動で参照し、定型の手順を一貫して進められるレベルまで設計する視点が欠かせません。手軽さと作り込みのどちらを優先すべきかは、任せたい業務の頻度や重要度に応じて見極めることが大切です。
スモールスタートで1業務をAIに任せるのが結論
これらの落とし穴を避ける考え方が、スモールスタートです。壮大な構想から入るのではなく、まず1業務をAIエージェント(特定の作業を自律的に進めるAI)に任せ、効果を確かめながら少しずつ広げていくのが現実的な進め方になります。1つの業務で成果と課題が見えれば、次にどこへ広げるべきかの判断材料も得られ、社内の合意も進めやすくなります。ChatGPTの仕組みを理解したうえで「どの作業なら任せられるか」を見極めることが、その第一歩になります。GiftXでは、こうしたスモールスタート前提のAIエージェント構築を1業務単位から伴走支援しています。詳細はAIエージェント構築支援サービスをご覧ください。
ChatGPTの仕組みに関するよくある質問
最後に、ChatGPTの仕組みについてよく寄せられる疑問を整理します。
ChatGPTのGPTとは何の略ですか?
Generative Pre-trained Transformer(生成可能な、事前学習済みの、トランスフォーマー)の頭文字です。文章を生成する能力、大量データでの事前学習、Transformerという構造の3つを表しています。
ChatGPTはどのように学習していますか?
大きく分けると、言語パターンを身につける事前学習と、指示追従や安全性を整える事後学習があります。事後学習にはお手本の応答、人やAIによる評価など複数の手法が使われ、具体的な工程はモデル世代によって変わります。
ChatGPTは内容を理解して答えているのですか?
人間と同じ方法で理解しているとは確認できません。入力中の関係をTransformerで計算し、次トークンの確率分布から文章を生成します。文脈を捉えて自然に応答できても、事実性を保証する仕組みではないため、もっともらしい誤りが生じることがあります。
まとめ
ChatGPTは、入力をトークンに分け、Transformerで文脈を処理し、次トークンの確率分布から候補を選ぶ処理を繰り返して回答を作ります。土台は大量の文章を使う事前学習で作られ、事後学習によって指示追従や安全性が調整されます。Web検索・RAG・ツール利用は、この基本モデルへ外部の情報や操作手段を加える仕組みです。
自然な文章と事実性は同じではないため、ハルシネーションや情報の古さは人が検証する必要があります。仕組みを理解しておけば、案出しには幅を活かし、数値や規程には根拠確認を加えるなど、用途に応じて使い分けられます。業務へ取り入れる際は、確認基準を決めた1業務から始めるのが現実的です。
ChatGPTを業務での自動化につなげたい方へ
本記事で紹介したChatGPTの仕組みを踏まえて、自社の業務でも具体的にAI活用を進めたい・相談したいとお考えの方は、ぜひGiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせて1業務単位のスモールスタートから本番運用まで、AIエージェント構築をワンストップで支援します。ユースケースの洗い出しから、PoC、本番運用、社内ナレッジ化まで伴走します。
AI活用にご関心のある方は、ぜひ一度ご相談ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら