GPT-6.1 Solとは|GPT-6 Solを更新したモデル
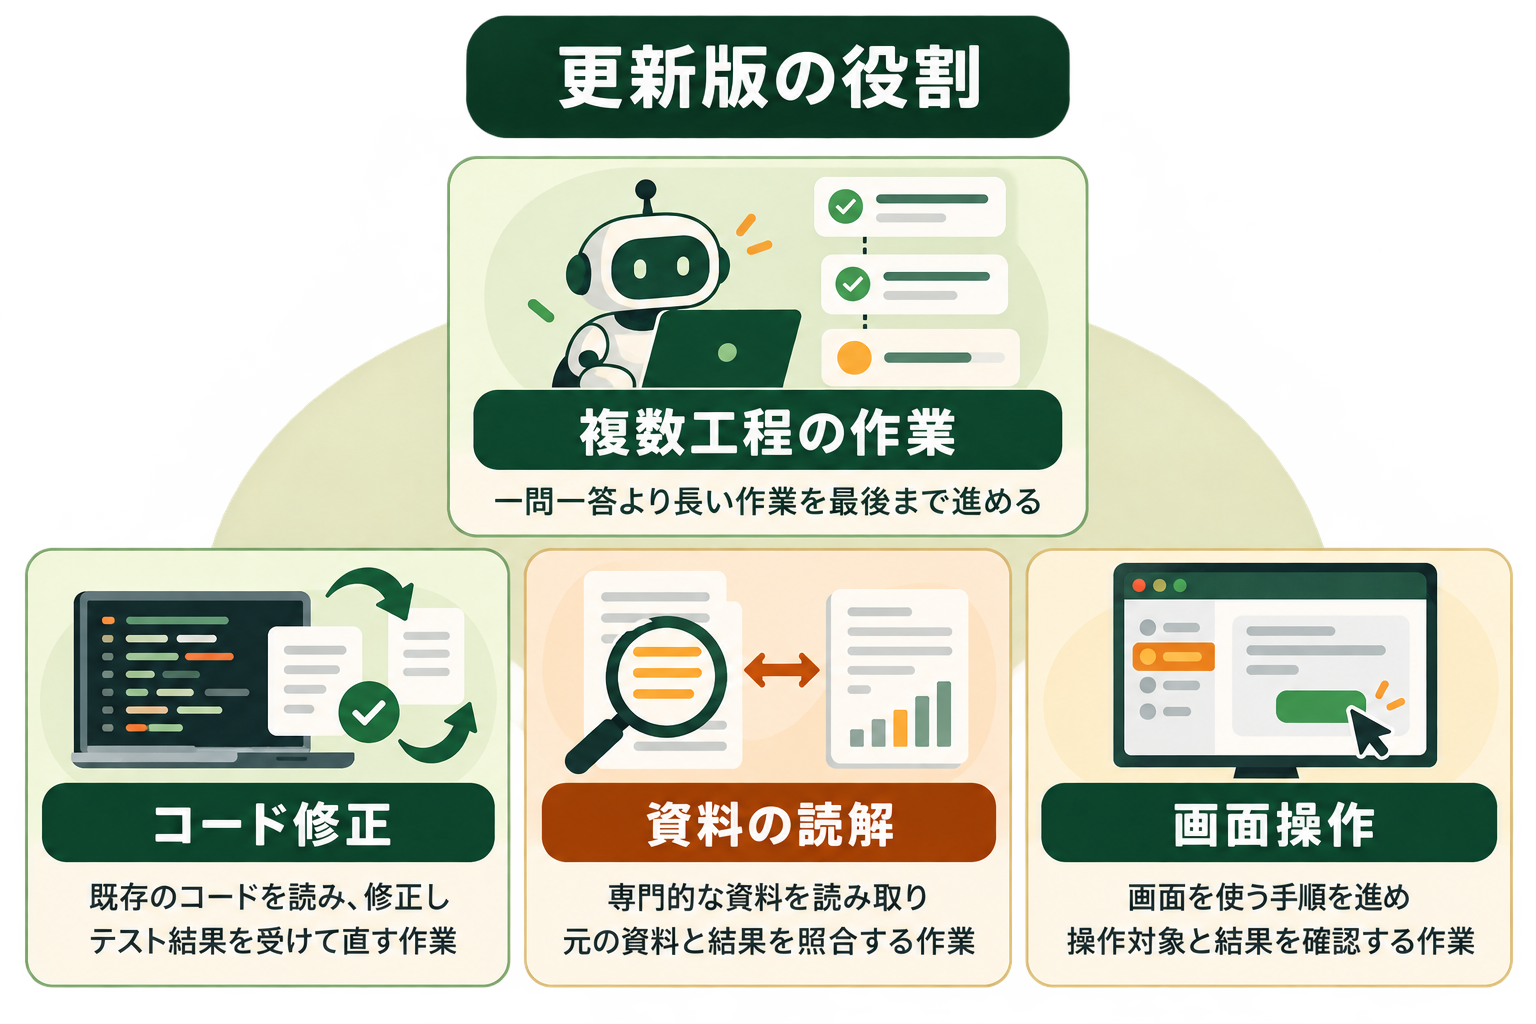
GPT-6.1 Solは、OpenAIが2026年9月29日(米国時間)に発表したGPT-6 Solの後継モデルです。複数の手順を伴うコーディング、コンピュータ操作、専門的な資料を扱う作業の改善を主な特徴として示しています(出典: openai.com)。
発表全体の位置づけや各機能の提供対象は、OpenAI DevDay 2026の発表まとめで確認できます。
名称に「6.1」とある通り、別の軽量モデルLunaではなく、Solの能力を引き上げる更新です。OpenAIは、最上位モデルGPT-6 Astraに近い結果を、一部の評価ではより低い作業単価で得られると説明しています。ただし、あらゆる課題でAstraと同じ性能になるという意味ではありません。
どのモデルの後継か
GPT-6.1 Solが直接更新するのはGPT-6 Solです。先行するSolと比べ、複雑なコード修正、資料を読み取る作業、画面操作を含む作業に対してOpenAIが改善を報告しました。GPT-6 Lunaは、短い分類や抽出など大量の軽い処理を担う別の選択肢です。
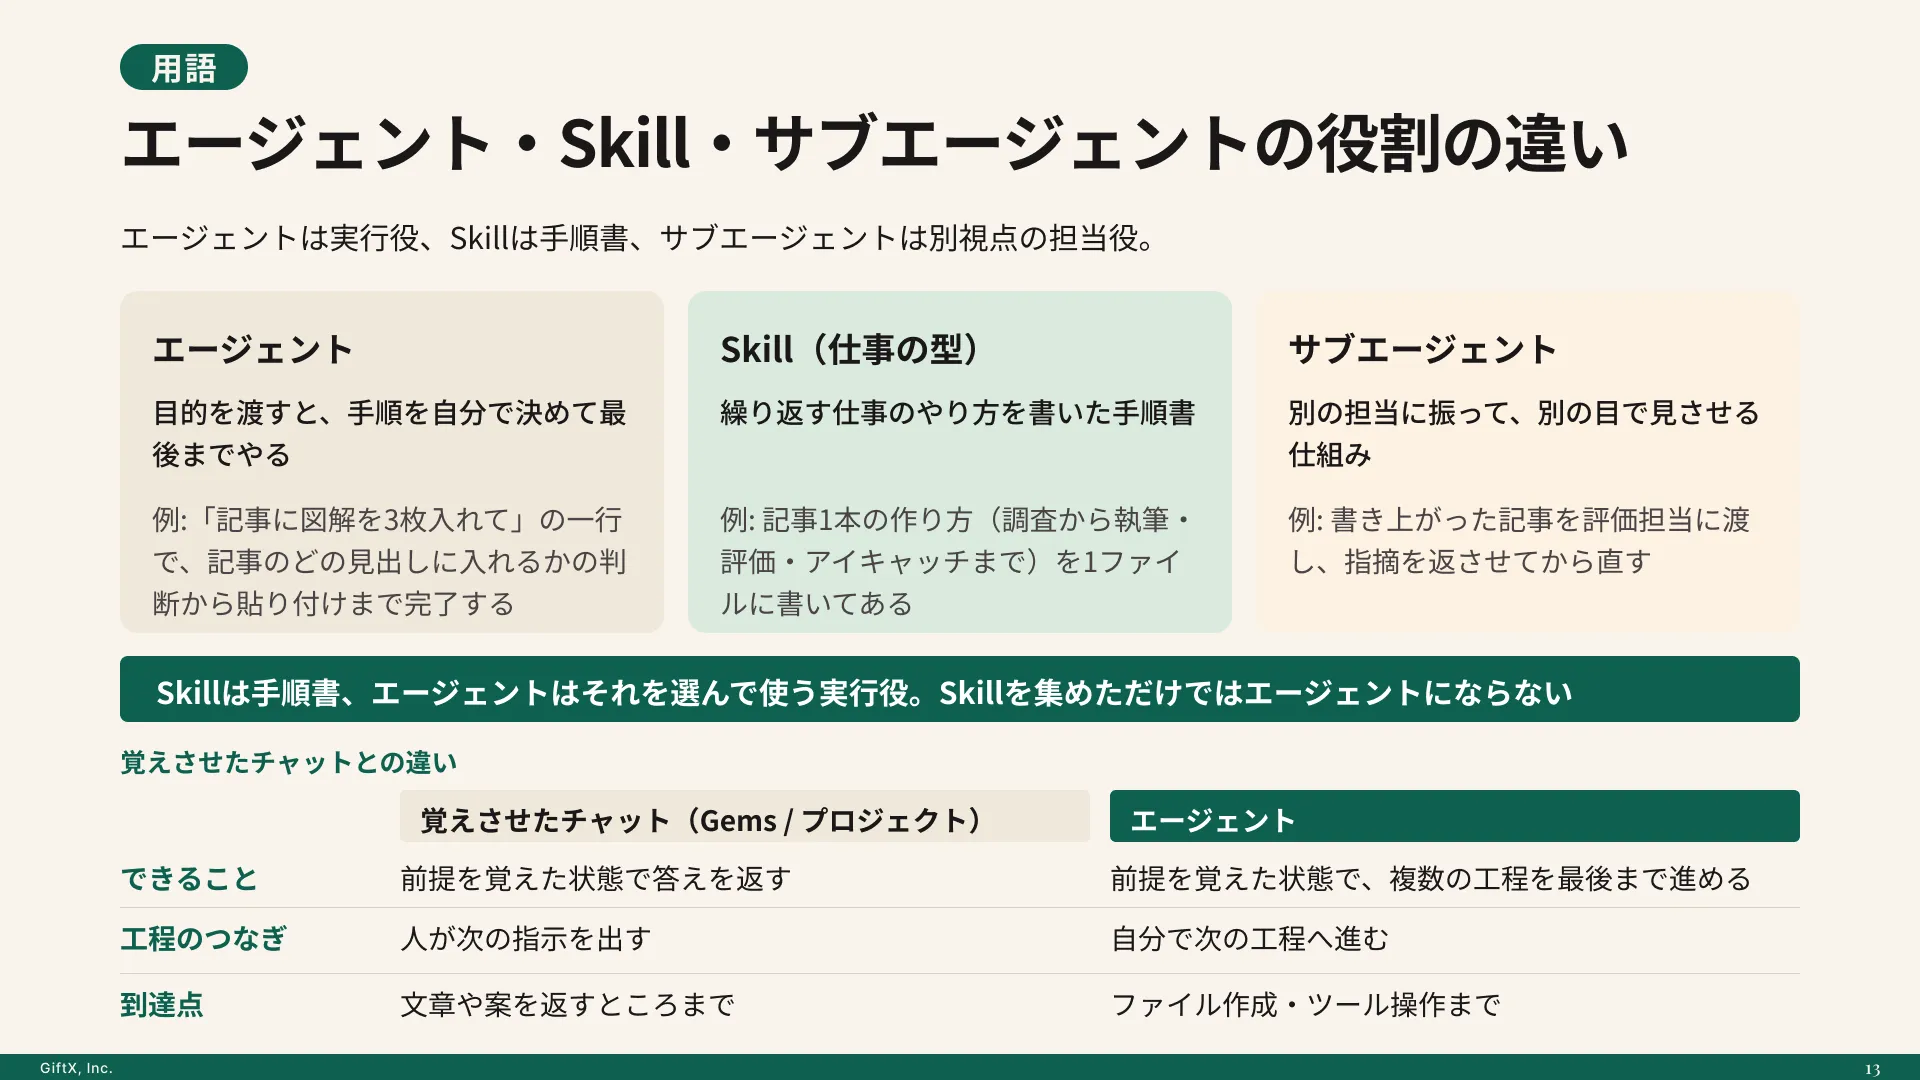
ここでいう「エージェント」は、質問への回答だけで終わらず、必要なツールを呼び出し、複数工程を進めるAIの使い方を指します。OpenAIの紹介文が強調するのも、単発の文章生成より、作業を最後まで進める場面です。
たとえば、既存のコードを読み、修正案を作り、テスト結果を受けて直す作業は、単発の質問より工程が長くなります。途中の判断が次の入力を変えるため、最初の回答の文章だけを比べても、どちらのモデルが実用的かは分かりません。GPT-6.1 Solを検討する際は、最後まで完了できた割合を見ます。
発表日と提供開始を混同しない
OpenAIの発表では、GPT-6.1 Solの標準版は発表日からAPI、ChatGPT Work、Codexで利用できるとされています。一方、より速い「Ultrafast」は今後数日で提供予定とされており、標準版と同時に使えるわけではありません(出典: openai.com)。
表示されるモデルや機能は、契約プランと利用する製品によって違います。「ChatGPTで利用可能」という一文だけで通常のチャット画面にも出ると考えず、後述する提供先を確認してください。
発表当日の案内は、将来の提供予告と、すでに利用できる範囲を同じページで扱っています。社内向けの導入案内を書く場合も、「提供予定」と「現在利用可能」を別の欄に分けると、利用者が画面にない機能を探さずに済みます。特に速度が必要な処理は、Ultrafastの提供を待つ判断と、現在の標準版で測る判断を分けてください。
GPT-6.1 SolとGPT-6 Sol・Astraの違い
GPT-6.1 Solの位置づけを理解するには、能力の説明と料金を分けて比べるのが近道です。OpenAIが示す「Astraに迫る性能」は、コーディングや画面操作などの評価での表現であり、個々の作業の成否を保証するものではありません。
以下の単価は2026年9月時点のOpenAI公式情報に基づく、標準処理・短いコンテキストのAPI価格です(出典: developers.openai.com)。
| 比較項目 | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|---|
| 位置づけ | 従来のSol | Solの更新版 | 最上位モデル |
| 標準入力単価 | 100万トークンあたり2ドル | 100万トークンあたり2ドル | 100万トークンあたり10ドル |
| 標準出力単価 | 100万トークンあたり10ドル | 100万トークンあたり10ドル | 100万トークンあたり50ドル |
| キャッシュ入力単価 | 100万トークンあたり0.20ドル | 100万トークンあたり0.10ドル | 100万トークンあたり1ドル |
GPT-6.1 Solの標準入力・出力はGPT-6 Solと同額です。「Astraの5分の1」はAstraと比較した標準トークン価格を指し、GPT-6 Solから標準価格が5分の1になったわけではありません。
表の価格だけを見ると、旧Solからの更新で費用が必ず下がるように見えるかもしれません。しかし請求額には、通常入力、キャッシュされた入力、出力、選んだ処理モードがそれぞれ効きます。新モデルで回答が長くなれば、入力単価が同じでも出力費用は増えます。比較は単価表と実際のトークン内訳を組み合わせて行います。
関連記事:GPT-6 Sol・Lunaとは?GPT-5.6から半額になった料金とAstraとの違い
大きな価格差はキャッシュ入力
同じ文書や長い指示を繰り返し送る場合、再利用できた入力を通常より安く扱う仕組みがキャッシュ入力です。GPT-6.1 Solでは100万トークンあたり0.10ドルで、GPT-6 Solの0.20ドルから半額になりました(2026年9月時点、出典: developers.openai.com)。
ただし、すべての入力が自動的にキャッシュ価格になるわけではありません。実際の請求では、再利用できた入力の量と通常入力の量を分けて見る必要があります。短い一回限りの依頼では、この差がほとんど効かない場合もあります。
キャッシュ効果を見積もる
仮に100万トークンすべてがキャッシュ入力として請求されれば、その部分だけは旧Solの0.20ドルから新Solの0.10ドルになります。一方、キャッシュが成立しない100万トークンなら、両モデルとも通常入力の2ドルです。この例は単価の関係を示すもので、特定の呼び出しでキャッシュが成立することを保証しません。実測では使用量の内訳を確認します。
推論の深さを指定するときの注意
GPT-6 Solは推論を使わないnoneを選べますが、GPT-6.1 Solはlow、medium、high、xhigh、maxに対応し、noneとminimalには対応していません(出典: developers.openai.com)。従来の呼び出しでnoneを指定しているなら、モデル名だけの置き換えでは設定が合いません。
機械的な分類や定型変換をnoneで大量に動かしている場合は、GPT-6 Lunaや旧Solを含めて比べる方が合理的です。新しい版だから常に速く安いと決めず、実際の入力と出力で測定します。
切り替え時に推論設定を記録する
推論の深さは回答品質だけでなく、出力トークンや処理時間にも関わります。比較時にはモデルと推論設定を一緒に記録してください。旧Solのnoneと新Solのmediumを比べて出た費用差を、モデル単体の価格差として扱うと判断を誤ります。旧設定をそのまま使えないこと自体を、移行工数として見積もる必要があります。
GPT-6.1 Solでできること|性能評価から読み取れること
OpenAIは複数の評価で、GPT-6.1 SolがGPT-6 Solを上回ったと公表しています。評価対象には、実際のコードベースで長い修正を行うDeepSWE、複雑なPDFを読むGDP.pdf、複数ツールを使うAutomationBench、コンピュータ操作を試すOSWorldなどがあります(出典: openai.com)。
コーディングと複数工程
DeepSWE v1.1ではGPT-6.1 SolがAstraと同等の結果を示し、GPT-6 Solの最高スコアを6.4ポイント上回ったとOpenAIは説明しています。ただし比較した推論設定と作業コストは同一ではありません。自分のコードベースでも同じ差が出ると断定せず、修正の成功率とレビューの手間を測る材料として扱います。
AutomationBenchでは、中程度の推論設定においてGPT-6 Solから4.8ポイント改善したとされています。この評価はツールをまたぐ作業を対象にするため、単純な質問応答だけでモデルを選ぶと見えない違いがあります。一方、評価用の作業と自社の手順が違えば、順位も変わり得ます。
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
公開評価を自社の作業に移す
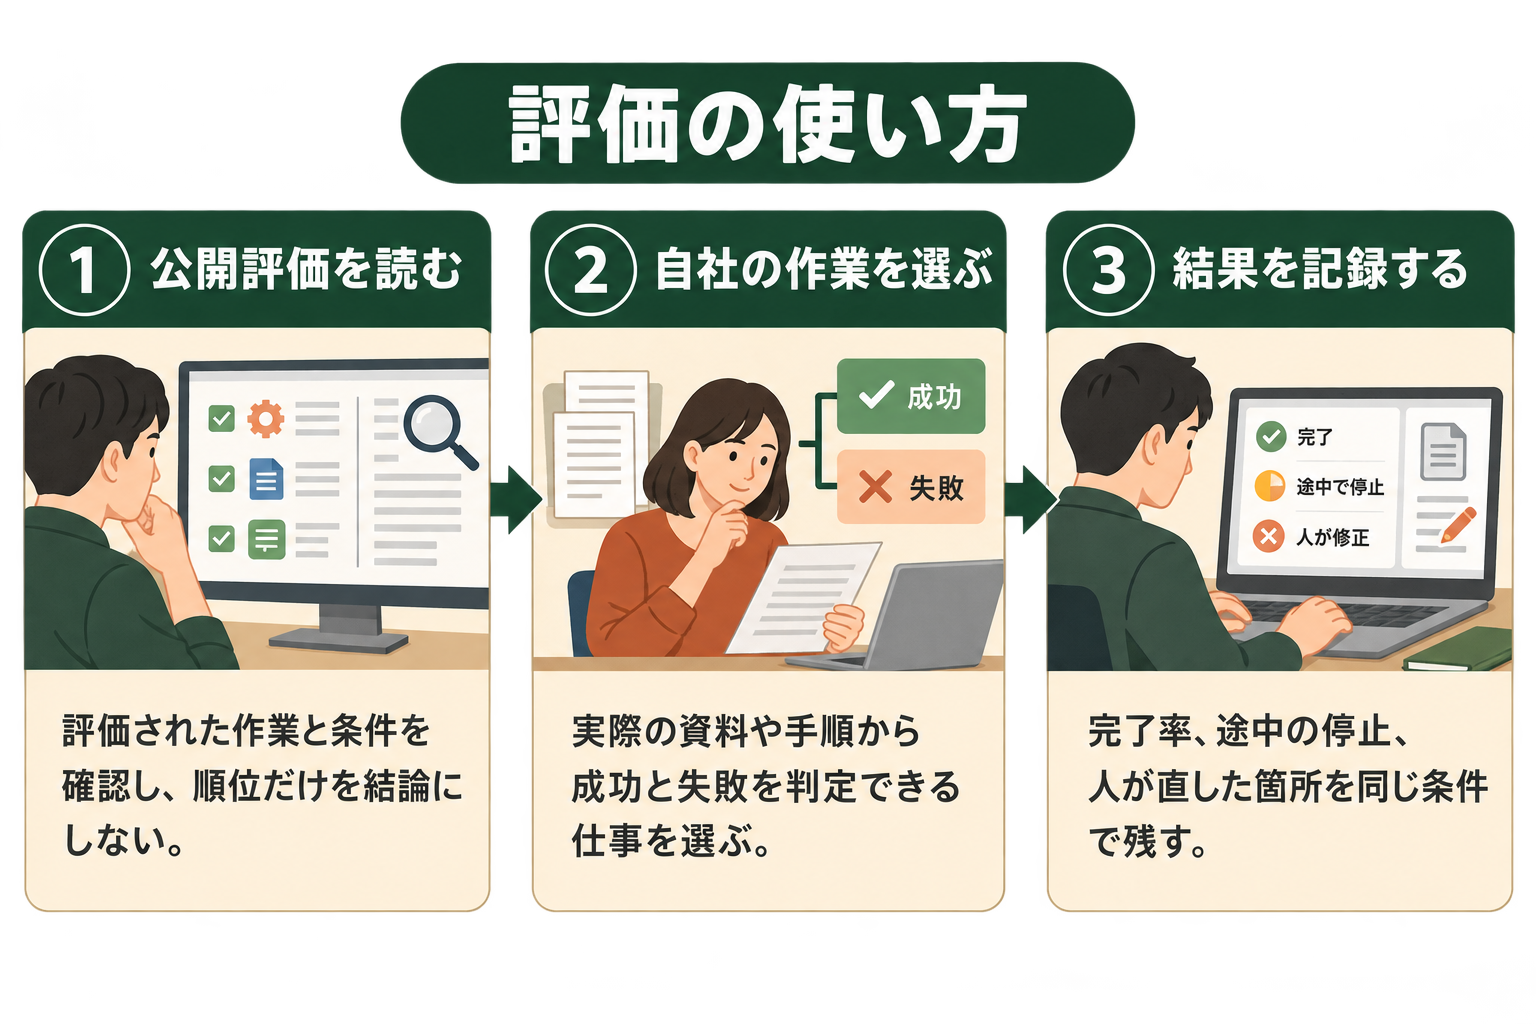
複数工程の作業では、一度の成功だけでは十分ではありません。同じ種類の作業を複数回試し、手順が途中で止まった位置、誤ったツールを選んだ回数、最後に人が直した箇所を残します。モデルを変えた効果と、周辺の指示やツール設定を変えた効果を混ぜないためです。公開ベンチマークは比較対象を絞る入口として使い、自社の合格基準は別に作ります。
画面操作と事実性
OSWorld 2.0の一部評価では、最大推論設定のGPT-6.1 SolがGPT-6 Solを7ポイント上回り、Astraとの差は2.1ポイントだったとOpenAIは報告しています。画面操作を含む手順を任せる場合の参考になりますが、画面構成や権限設定が変わる自分の環境での成功率ではありません。
事実性の評価では、難しい質問に対する誤りを含む回答の割合が、低い推論設定で11.4%から7.7%へ下がりました。OpenAIは、これは過去に誤りを指摘された会話を使う難しい評価で、通常利用の誤り率を表さないと明記しています(出典: openai.com)。数値だけを抜き出して「誤答率7.7%」と一般化しないことが大切です。
正確性評価を実務で使う
資料の要約や調査で使うなら、正しい答えに到達したかに加え、引用元を追えるかも確認します。改善した評価値は、確認を省けるという根拠にはなりません。誤りが許されない作業では、回答を実行前に人が確認する工程や、元資料と突き合わせる工程を残します。
GPT-6.1 Solの料金と費用が変わる条件
APIの標準価格は、100万トークンあたり入力2ドル、キャッシュ入力0.10ドル、出力10ドルです。長い入力や処理モードによって価格は変わるため、見積もりでは基本単価だけを掛けないでください(2026年9月時点、出典: developers.openai.com)。
以下は2026年9月時点のGPT-6.1 SolのAPI料金です。単位はいずれも100万トークンあたりで、標準処理の価格を示します(出典: developers.openai.com)。
| 1回の入力条件 | 通常入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| 27.2万トークン以下 | 2ドル | 0.10ドル | 10ドル |
| 27.2万トークン超 | 4ドル | 0.20ドル | 15ドル |
27.2万トークンを超える入力
1回のリクエストで入力が27.2万トークンを超えると、入力とキャッシュ入力は2倍、出力は1.5倍の単価が、そのリクエスト全体に適用されます(2026年9月時点、出典: developers.openai.com)。コンテキストウィンドウは105万トークンですが、読める上限と安く使える範囲は同じではありません。
大量の資料を丸ごと渡す場合は、必要な部分の抽出や事前の分割を検討します。短い入力を繰り返す場合はキャッシュの効き方、長い入力をまとめて送る場合は割増の境界を先に見ると、費用の見込みを立てやすくなります。
長い入力の見積もり
たとえば、29万トークンの入力を1回送る見積もりに、通常の入力単価をそのまま掛けるのは適切ではありません。27.2万トークンを超えた場合は、超過した部分だけでなくリクエスト全体の単価が変わるためです。複数の資料をまとめて渡す設計では、境界をまたぐ頻度を使用ログで確認し、資料の分割後に回答品質が落ちないかも併せて試します。
標準・Batch・Flex・Fastの違い
OpenAIのモデル資料では、BatchとFlexは標準より50%低い料金、Fastは標準の2倍と案内されています(2026年9月時点、出典: developers.openai.com)。待ち時間を許せる処理か、応答の速さが必要な処理かで選択します。処理方式の料金差とモデル間の性能差を一つの数字にまとめると判断を誤りやすくなります。
なお、GPT-6.1 SolのUltrafastは発表時点では今後の提供予定です。将来の速度向上を前提に、今日動かす処理の所要時間を見積もらないようにします。
夜間にまとめて処理する仕事と、利用者が画面で待つ仕事は、同じモデルでも選ぶ処理方式が異なります。まず待ち時間の許容範囲を決め、使える処理方式の条件を公式資料で確認してください。月額の見積もりでは、一回あたりの平均費用だけでなく、処理件数が増えた日の上限も見ると予算管理に役立ちます。
GPT-6.1 Solの入力形式と長い文脈で確認すること
GPT-6.1 Solのモデル資料では、テキストと画像を入力でき、コンテキストウィンドウは105万トークン、最大出力は12万8000トークンとされています。音声と動画の入力には対応していません(出典: developers.openai.com)。対応形式と文脈の上限は、実際にその量を一度に渡すべきかとは別の話です。
画像を含む資料の読み取り
画面のスクリーンショットや図表を入力に含められるため、文字だけでは伝わりにくい配置も対象にできます。ただし、画像から読み取った細部が常に正しいと仮定せず、数字、固有名詞、画面上の操作対象を元の画像と照合してください。重要な判断に使う場合は、モデルの説明から元の場所を確認できる形で結果を残します。
画像対応は、画像から画像を生成できるという意味ではありません。また、動画や音声をそのまま入力する設計には使えません。従来の処理がどの形式を渡しているかを洗い出し、対応していない形式は別の処理手順が必要か検討します。
長文を一度に入れる前に
105万トークンの文脈上限は、複数の資料や長い履歴を扱える余地を示します。一方、投入する情報が増えるほど、探したい箇所が紛れたり、不要な情報に処理費用がかかったりします。必要な範囲を先に選び、回答に使った根拠を示せるかを試してください。
見積もりには、27.2万トークンを超える入力の割増条件も反映します。長い資料を一度で読ませる方法と、検索や分割で必要部分だけ渡す方法を、同じ質問で比べると判断しやすくなります。分割すると前後関係が欠ける場合もあるため、安さだけで方法を決めず、正確さと確認の手間も記録します。
長文を評価するときの試験項目
長い文脈を使う試験では、資料の先頭・中ほど・末尾からそれぞれ答えを探す質問を用意します。一箇所の質問だけが正解でも、全体を同じ精度で参照できるとは限りません。資料にない答えを問う例も入れ、分からないと答えられるか確認します。入力が増えたときの所要時間と費用、回答の根拠を一緒に残せば、上限の大きさに頼った設計を避けられます。
検索や分割を使う場合は、取り出した文書が本当に必要な資料だったかも評価対象にします。モデルの回答が誤ったとき、検索の失敗なのか、資料の解釈の失敗なのかを分けて見るためです。使える文脈が広がっても、資料の整理や権限の確認は引き続き必要です。
GPT-6.1 Solの使い方|利用できる場所
OpenAIは、Plus、Pro、Business、Enterprise、Eduの利用者向けにChatGPT WorkとCodexでGPT-6.1 Solを提供すると説明しています。通常のChatGPT Chatでは、発表時点でまだ選べません。開発者はAPIのモデルIDgpt-6.1-solで利用できます(出典: openai.com)。
ChatGPT WorkとCodex
契約プランが対象でも、使う画面が通常のチャットかWork・Codexかで提供状況が変わります。利用前に製品とプランの両方を確認してください。組織の利用では、管理者の設定や利用枠も合わせて確認するのが実務的です。
モデル名を選べるようになったら、最初は既存の一つの作業で旧Solと結果を並べます。期待する出力、失敗の種類、作業を完了するまでの手直しを記録しておくと、単純な応答の印象だけに頼らず判断できます。
WorkとCodexでは、利用者が入力する画面や使える道具が異なります。片方での感触をもう片方の性能評価として流用しないようにします。業務で使う場合は、実際に利用する製品で権限や承認の流れも含めた試験を行い、モデルの改善が工程全体の短縮につながるかを確認します。
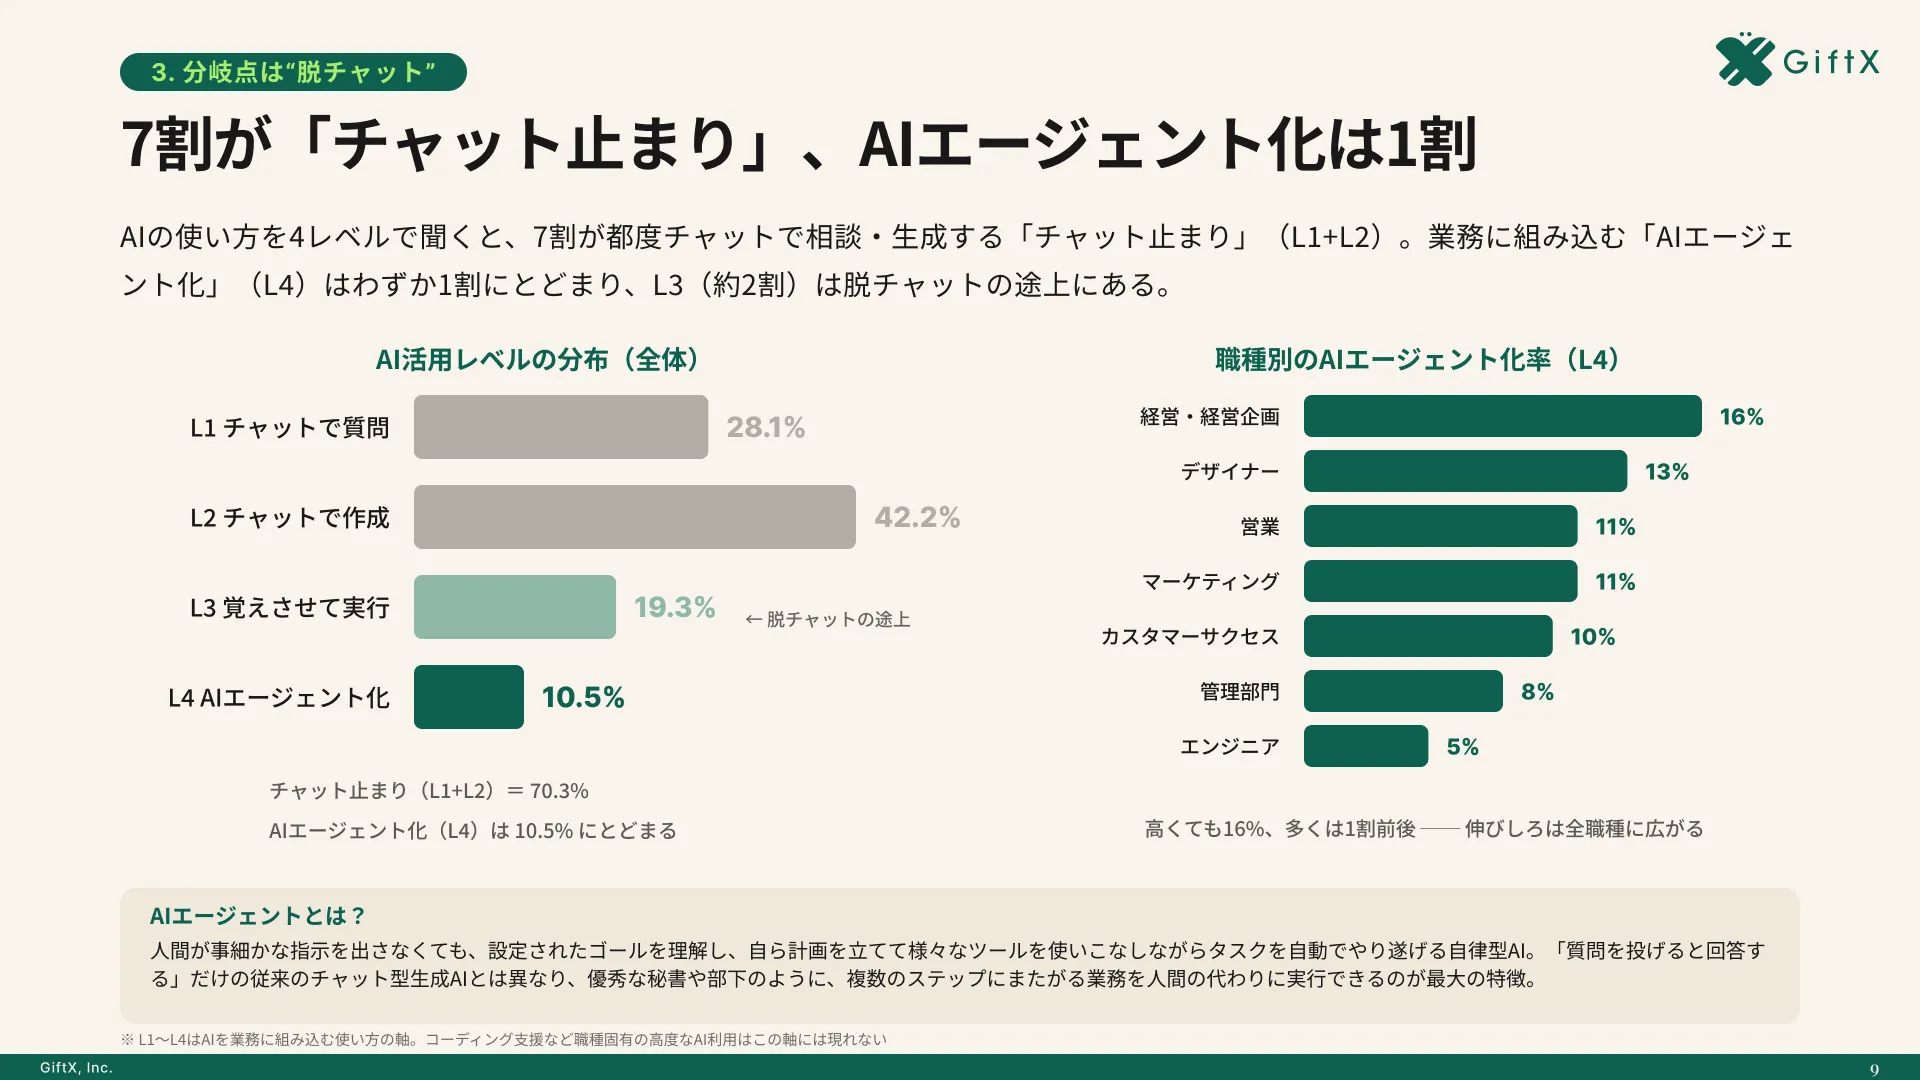
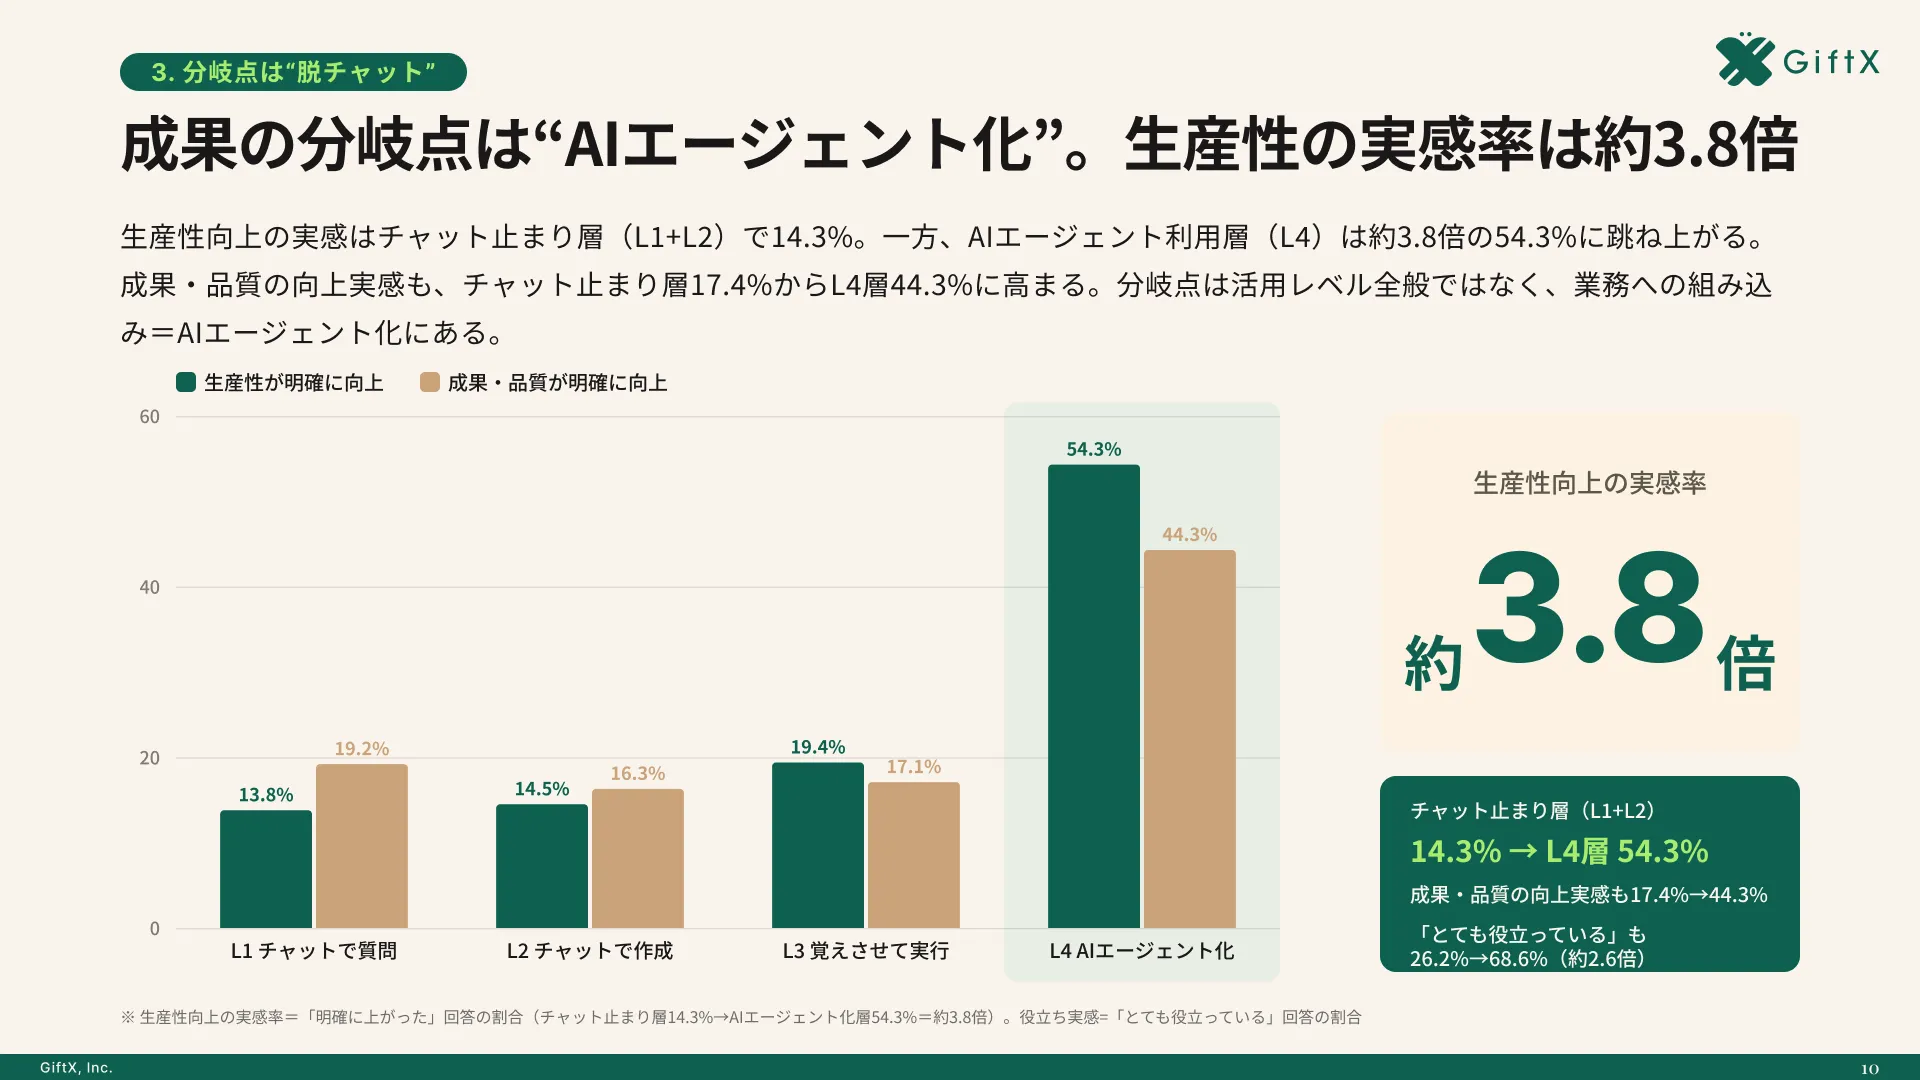
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
関連記事:Codexとは?OpenAIのコーディングAIエージェントの仕組み・使い方・料金を徹底解説
APIで指定する際の確認項目
APIではgpt-6.1-solを指定できます。ツール呼び出しを使う場合はResponses APIを使い、Chat Completionsはツール呼び出しなしの利用に限るとモデル資料に記載されています(出典: developers.openai.com)。既存アプリがツールを使っているなら、この条件を先に確認してください。
既存の呼び出しが複数のモデルを切り替える設計なら、モデルごとの対応機能を一覧にしておくと移行しやすくなります。選択したモデルとAPI経路の組み合わせで何が実行できるかを、実際のリクエストで確かめます。
関連記事:ChatGPT APIとは?料金の実額と上限設定、Web版との違い・できること
入出力と設定の互換性
入力はテキストと画像に対応しますが、音声と動画には対応していません。推論設定の既定はmediumです。GPT-6 Solでnoneを明示していた処理や、音声を前提にした処理をそのまま移す設計は見直しが必要です。
モデルを指定する箇所だけでなく、APIの経路、推論設定、入出力の形式も移行対象です。実装前にはモデル資料の対応一覧を確認し、小さなテストでエラーの種類と結果の形を確かめます。ドキュメントの更新によって対応範囲が変わり得るため、この記事の記述を固定仕様として扱わず、導入時の公式資料を再確認してください。
GPT-6.1 Solの導入方法|切り替え判断に使う5つの確認項目
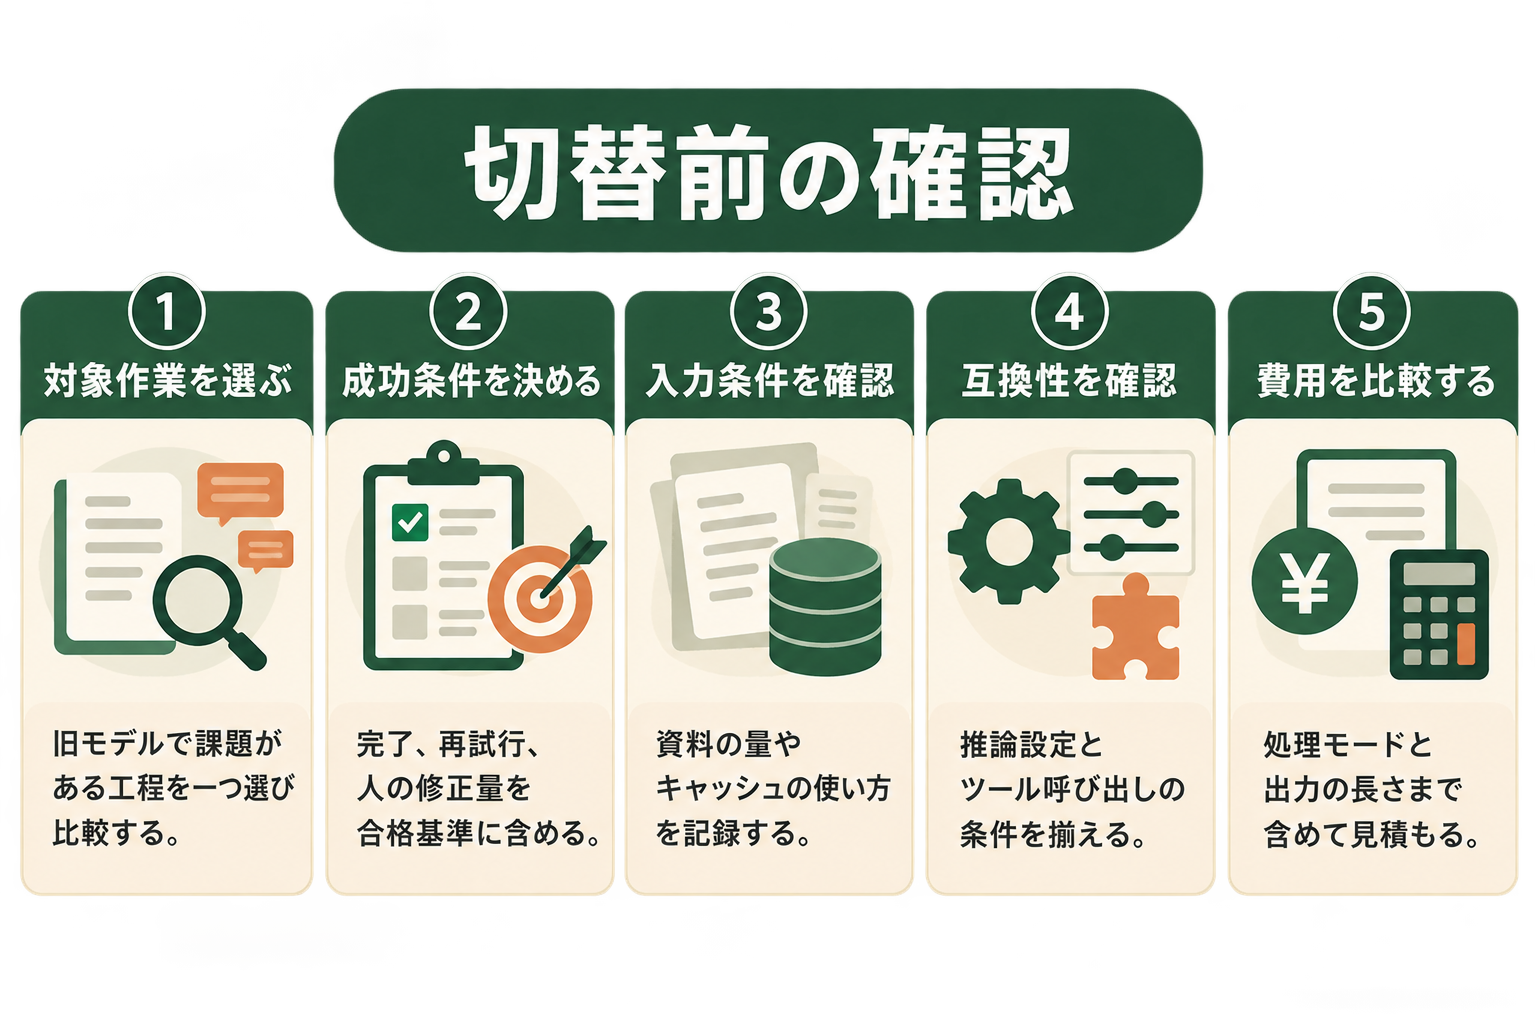
GPT-6.1 Solへの更新は、性能の宣伝文句だけでなく、具体的な処理の合格条件から判断します。次の5項目を一つの作業に当てはめれば、切り替えの必要性が見えます。
- 対象作業:長いコード修正や画面操作など、旧Solで課題がある工程を一つ選ぶ
- 成功条件:正答だけでなく、完了までの再試行回数と人による修正量を決める
- 入力条件:キャッシュの利用量と27.2万トークンの境界を確認する
- 互換性:
reasoning.effortとツール呼び出しの設定を確認する - 費用:標準単価だけでなく処理モードと出力トークンを含めて比べる
一度にすべての処理を切り替えると、どの条件が結果を変えたのか分からなくなります。まず同じ入力を旧Solと新Solで試し、成功率と費用の両方を比較します。Astraは、Solで合格基準に届かない難しい作業の比較対象として残しておきます。
比較用の作業をどう選ぶか
最初の比較対象には、成功と失敗を後から確認できる仕事を選びます。たとえば、コード修正ならテストの通過だけでなく、変更の意図を満たしたか、レビューで何を直したかまで記録します。資料の読み取りなら、元資料のどこに答えがあるかを確認します。成功条件が曖昧なまま試すと、文章の印象だけで新モデルを高く評価しがちです。
代表的な入力を数件だけ選ぶ場合も、簡単な例だけに偏らないようにします。旧Solが失敗した例、旧Solで問題のなかった例、境界が判断しにくい例を含めると、改善と後退を両方見られます。同じ指示と資料を使い、推論設定やツール条件を記録して比較します。
切り替えるか残すかを決める
新Solで失敗が減り、人の修正量も減るなら、費用の増減を含めて切り替えを検討できます。品質の差が小さく、互換性の修正が多い場合は、旧Solを維持する判断もあります。Solで合格しない作業はAstraを比較対象にし、単純な大量処理ならLunaなど別の候補を確認します。
検証の結果は、モデル名だけでなく、入力の種類、推論設定、ツール、合格率、平均の出力長、請求されたトークンの内訳を一緒に残します。導入後に費用や品質が変わったとき、どの条件が原因か追いやすくなります。モデルを更新した日付も残しておけば、将来の再評価に使えます。
GPT-6.1 Sol導入で陥りがちな3つの落とし穴
新しいモデルの性能が上がっても、切り替えるだけで作業が安定するわけではありません。対象となる手順と合格条件を小さく定義することで、違いを見極められます。
落とし穴1|すべての作業を同時に移す
対象が広いと、モデルの差と手順の差を切り分けられません。失敗時にどこを戻すかも曖昧になります。最初は一つの作業に限って比較します。
落とし穴2|ベンチマークの順位だけで決める
公表された評価は、入力、推論設定、ツール、採点基準を固定した結果です。自分の作業に必要な品質と費用を決めてから、同じ条件で試します。
落とし穴3|チャットの利用だけで終える
回答を眺めるだけでは、繰り返す工程へモデルの改善を生かしにくくなります。人の確認点を残したうえで、必要なツールと手順につなぎます。
スモールスタートで1業務をAIエージェントに任せる
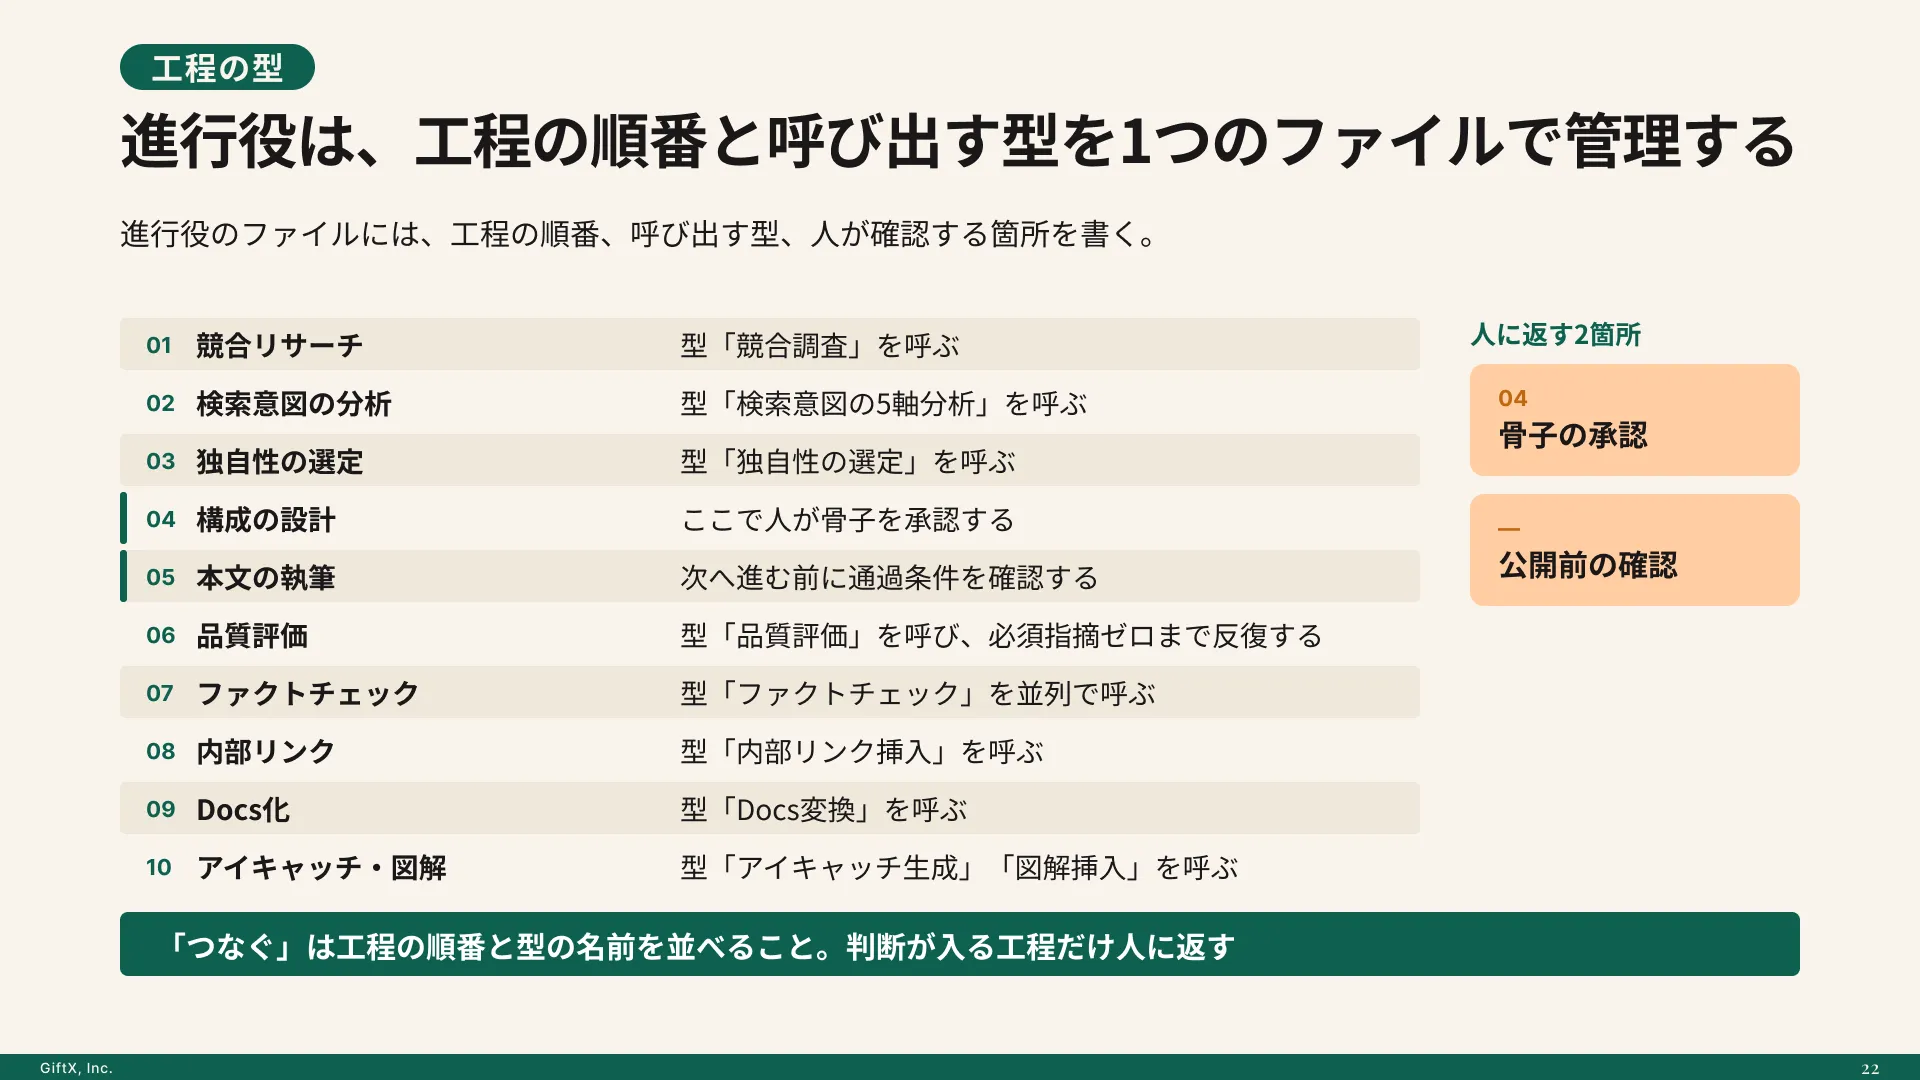
切り替えを考えるなら、一つの定型的な作業で入力、結果、確認者を決め、旧Solと新Solを比較します。合格条件を満たした工程だけをAIエージェントへつなぎ、例外時は人に戻せるようにします。これなら性能と費用の差を実際の運用で見極められます。
GiftXでは、このような小さな単位からのAIエージェント構築を伴走しています。進め方はAIエージェント構築支援サービスをご覧ください。
運用後も、失敗した作業と人が修正した箇所を記録し、切り替え前に決めた合格条件を定期的に見直します。モデルが更新されても、どの工程を自動化するかは利用する側が決める必要があります。
GPT-6.1 Solのよくある質問
GPT-6.1 Solは通常のChatGPTで使えますか?
2026年9月の発表時点で、OpenAIは通常のChatGPT Chatではまだ利用できないと説明しています。提供先はChatGPT Work、Codex、APIです。Plusなどの対象プランに入っていても、利用する製品の画面を確認してください。
GPT-6 SolとAPI料金は違いますか?
標準処理の入力2ドル・出力10ドルは同額です。キャッシュ入力は100万トークンあたり旧Solの0.20ドルから新Solの0.10ドルに下がりました(2026年9月時点、出典: developers.openai.com)。処理モードと長い入力の割増にも注意が必要です。
キャッシュ入力の単価差が実際の請求額にどれほど効くかは、再利用できる入力の割合で変わります。過去の請求データにある通常入力、キャッシュ入力、出力の量を分けて比較してください。推論設定の違いで出力が増える場合もあるため、単価だけで年間費用を予測しない方が安全です。
GPT-6.1 SolはAstraを置き換えますか?
OpenAIは一部の評価でAstraに近い結果を示しますが、難しい研究作業ではAstraが最高スコアだったとも説明しています。個別の作業では、必要な品質と実際の費用を比べて選ぶのが適切です。
まずSolで合格基準を満たせるかを見て、満たせない部分にAstraを試すと、追加費用に見合う改善があるか判断できます。公開ベンチマークの順位をすべての仕事に当てはめず、自社の評価用データを同じ条件で使うことが大切です。
まとめ|GPT-6.1 Solは一つの作業で切り替えを試す
GPT-6.1 Solは、GPT-6 Solからコーディングや複数工程の処理を改善した更新モデルです。標準API価格は旧Solと同じで、キャッシュ入力が安くなりました。通常のChatGPT Chatではまだ利用できず、Work、Codex、APIが対象です。推論設定のnoneに対応しない点も移行時の確認事項です。
まず一つの作業で旧Solと比較し、品質、修正量、費用を測ってください。Astraへの切り替えも同じ基準で判断できます。小さな工程からAIエージェントに組み込むと、モデルの違いを作業の成果として確かめやすくなります。
GPT-6.1 Solを業務に組み込みたい方へ
GPT-6.1 Solを自社の手順に組み込み、繰り返す作業を改善したい方は、GiftX AIエージェント構築支援にご相談ください。
GiftX AIエージェント構築支援では、対象となる1業務の選定から、試作、評価、本番運用まで伴走します。モデルの比較だけで終わらず、人が確認すべき工程とAIに任せる工程を整理します。
ご自身の業務でどこから始めるか、具体的に検討したい方はお問い合わせください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら