OpenAIのJalapeñoとは|Broadcomと開発したAI推論チップ
OpenAI Jalapeño(ハラペーニョ)は、学習済みのAIモデルから回答を生成する「推論」に特化したカスタムチップです。OpenAIは2026年6月24日(米国時間)に開発を発表し、同年8月26日に主要なベンチマーク結果を公開しました。OpenAIが自社向けに設計した最初のチップであり、汎用販売を前提とした製品ではありません。
Jalapeñoを共同開発した3社の役割
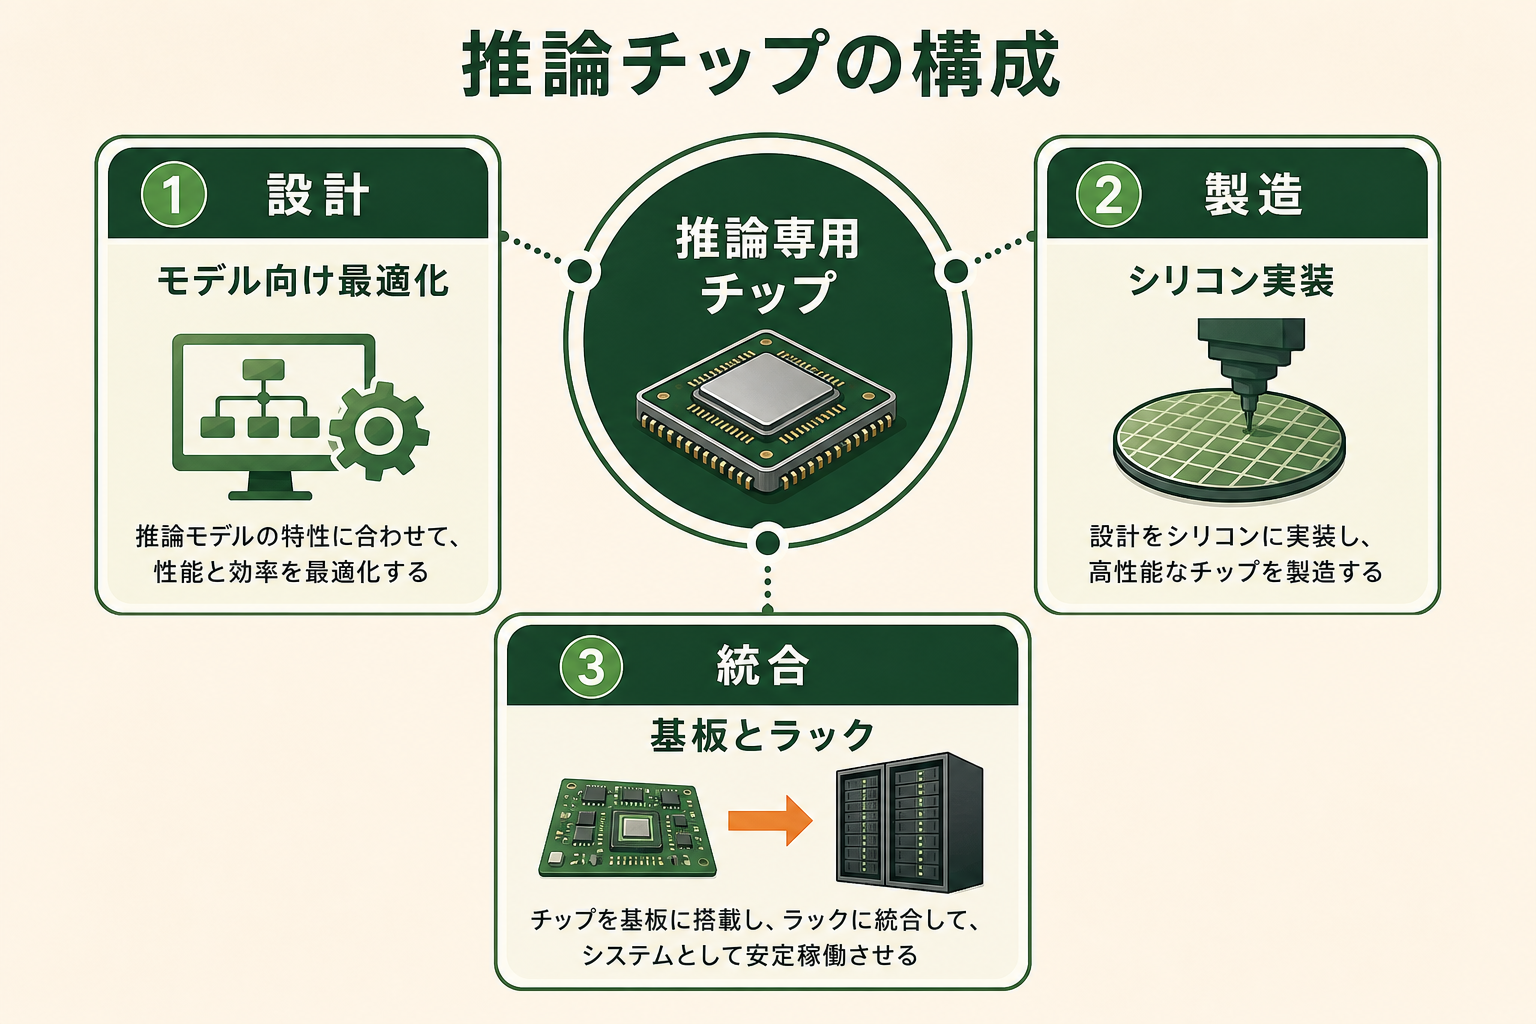
開発体制では、OpenAIがアーキテクチャを設計し、Broadcomがシリコン設計とネットワーク技術を担当しました。Celesticaはボード、ラック、システムの設計と製造に関わっています。単独企業のチップではなく、モデルを持つOpenAIと半導体・システムの専門企業が共同で作った推論基盤です。
OpenAIによると、最初の設計からテープアウトまでの期間は9か月でした。テープアウトは、半導体の設計データを製造工程へ引き渡す節目です。この9か月は量産やデータセンターへの配備までを含む期間ではないため、「9か月で開発と導入がすべて完了した」という意味ではありません。
Jalapeñoは、OpenAIが進めるフルスタック戦略の一部です。フルスタックとは、モデルだけでなく、ソフトウェア、チップ、ネットワーク、データセンターまでを一体で最適化する考え方を指します。OpenAIの発表では、既存の外部アクセラレーターを一律に置き換えるのではなく、用途に応じて組み合わせる方針が示されています。
Jalapeñoは学習用ではなく推論用
大規模言語モデル(LLM)は、大量のデータを使って能力を獲得する「学習」と、学習済みモデルが入力に応じて回答を作る「推論」という段階を持ちます。Jalapeñoが対象にするのは後者です。利用者がChatGPTやAPIへ質問を送り、モデルがトークンを順番に生成する処理を効率化します。
推論では、同じモデルを繰り返し動かしながら、多数の利用要求に短時間で応える必要があります。応答待ち時間、1秒あたりの処理量、消費電力のバランスを取る必要があります。Jalapeñoは推論処理に設計の焦点を絞り、OpenAIのモデルとサービスに合わせた効率向上を狙っています。
名前の読み方は「ハラペーニョ」
Jalapeñoは英語圏でも使われるスペイン語由来の名称で、日本語では一般に「ハラペーニョ」と読みます。OpenAIの日本語ページでも「Jalapeño」と表記されているため、検索や資料ではアルファベット表記を併記すると対象を特定しやすくなります。
Jalapeñoが担う役割とできること
Jalapeñoの役割は、OpenAIのAIサービスで増え続ける推論処理を、より低い遅延と高い電力効率で実行することです。利用者向けの新しいチャット機能やモデル名ではなく、応答を支える計算基盤の構成要素です。
具体的には、次のような改善を目指して設計されています。
- 同じ電力条件で、より多くの推論要求を処理する
- 最初の応答や後続トークンの待ち時間を短くする
- 大規模モデルが参照するデータをチップの近くに保持する
- モデルとハードウェアを同時に最適化しやすくする
これらの改善が、AIサービスの安定した大規模運用を支えます。ただし、チップ単体の改善が、そのまま利用者の画面で同じ倍率の速度向上になるわけではありません。実際の応答時間には、モデルの処理以外にも通信、要求の待ち行列、安全性の確認、外部ツールの実行などが関わります。
高頻度の対話処理に向く
OpenAIはJalapeñoについて、特に応答性が重視される対話型ワークロードで高い性能を示したと説明しています。ワークロードとは、チップに実行させる処理内容と負荷条件の組み合わせです。同じチップでも、モデルの大きさ、入力文の長さ、生成する文章量、同時利用数によって結果は変わります。
Jalapeñoの価値は、最高速度だけではなく、一定の応答性を保ちながら処理量を増やせる点にあります。OpenAIのように大量の推論を継続する事業者では、1回あたりの小さな効率差が、全体の電力や設備規模に大きく影響します。
利用者が直接操作する機能ではない
Jalapeñoには、一般的なソフトウェアのようなログイン画面や設定画面はありません。利用者がチップを選択してAIを動かすのではなく、OpenAIが自社インフラへ配備し、対応する処理を裏側で割り当てます。
このため、「Jalapeñoを使う」という表現は二つに分けて考える必要があります。OpenAIにとってはチップを配備し、モデルを最適化することです。一方、ChatGPTやAPIの利用者にとっては、将来Jalapeñoを含む基盤上で提供されるサービスを間接的に利用することになります。
Jalapeñoの仕組み|LLM推論に最適化した設計
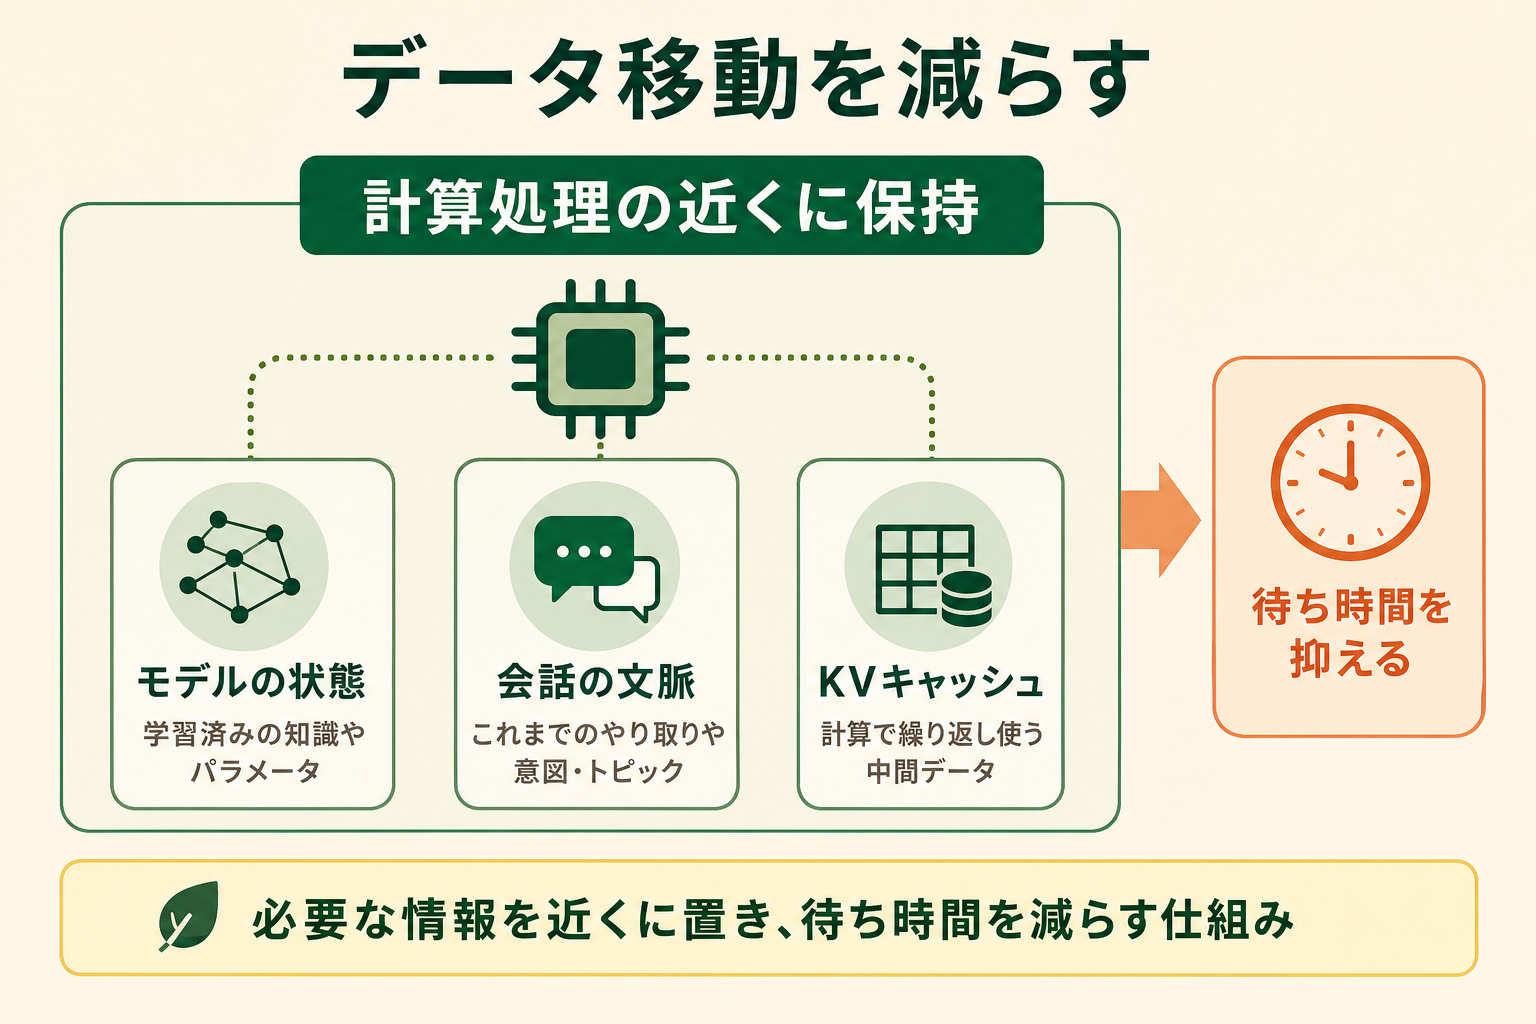
Jalapeñoの設計上の中心は、推論中に繰り返し使うモデルの状態をチップの近くに置き、データ移動を減らすことです。計算そのものが速くても、必要なデータを遠いメモリや別の装置から待つ時間が長ければ、応答全体は速くなりません。
モデルの状態とKVキャッシュを近くに保持する
LLMは文章を生成するとき、すでに読んだ入力や生成済みの文脈を参照します。その参照に使う中間データがKVキャッシュです。KVはKeyとValueの略で、注意機構が過去の文脈を効率よく参照するために保持する情報を指します。
長い文章や長時間の対話ではKVキャッシュが大きくなり、メモリへの読み書きが増えます。Jalapeñoは、こうしたモデルの状態をローカルに保ち、ネットワークをまたぐデータ移動を減らす方向で設計されています。これにより、計算装置がデータを待つ時間を抑え、低いレイテンシーを維持しやすくします。
レイテンシーは、要求してから結果が返るまでの待ち時間です。推論では、最初のトークンが出るまでの時間だけでなく、次のトークンが出る間隔も体感に影響します。OpenAIの資料にあるTBTはTime Between Tokensの略で、生成中に隣り合うトークンが出力される時間間隔を表します。値が小さいほど、文章が滑らかに表示されやすくなります。
モデルとチップを共同最適化する
汎用アクセラレーターは幅広いモデルや処理に対応する必要があります。カスタムチップは用途を限定できるため、OpenAIが使うモデル構造や推論ソフトウェアに合わせて設計できます。これは、すべての処理で自動的に優位になるという意味ではなく、対象ワークロードへの最適化余地が大きいという意味です。
OpenAIは、Codexと、現在の製品名ではGPT-6 Astraにあたる社内モデルのGPT-Astraをチップ向けソフトウェアの開発に利用したと説明しています。公開された3つのオープンモデルを2か月以内に移植し、選択したAttentionやMoEの処理ブロックで1.5〜1.8倍の改善を得たとしています。MoEはMixture of Expertsの略で、入力に応じて一部の専門ネットワークだけを動かすモデル構造です。
この1.5〜1.8倍は、対象とした処理ブロックの結果です。モデル全体の処理速度やChatGPT全体の応答速度を示す数値ではありません。数値を見る際は、どの範囲を測った結果かを確認する必要があります。
関連記事:GPT-6 Astraとは?使い方・料金・性能・GPT-5.6との違い
定格700W、測定ワークロードでは550W以下
OpenAIによると、Jalapeñoの定格は700Wで、ベンチマークに使ったワークロードでは持続消費電力が550W以下でした。定格は設計上想定する上限側の値であり、実際の消費電力は処理内容によって変わります。
この数値だけで、データセンター全体の電力や運用費を算出することはできません。サーバーにはチップ以外にもメモリ、ネットワーク、冷却、電源設備が必要です。OpenAIの比較はチップパッケージの電力を基準に正規化したもので、設備全体の総消費電力や総保有コストを比較したものではありません。
OpenAIが公表したJalapeñoの性能
OpenAIが2026年8月26日に公表した測定結果では、JalapeñoはGPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1Tという3つのオープンモデルで評価されました。モデル名の末尾にあるBは10億、Tは1兆規模のパラメーターを表します。
比較対象はモデルによって異なります。GPT-OSS 120BではNVIDIA GB200、DeepSeek R1 670BとKimi K2.5 1TではNVIDIA GB300が使われました。Jalapeñoと一つのNVIDIA製品を一律に比較した試験ではありません。
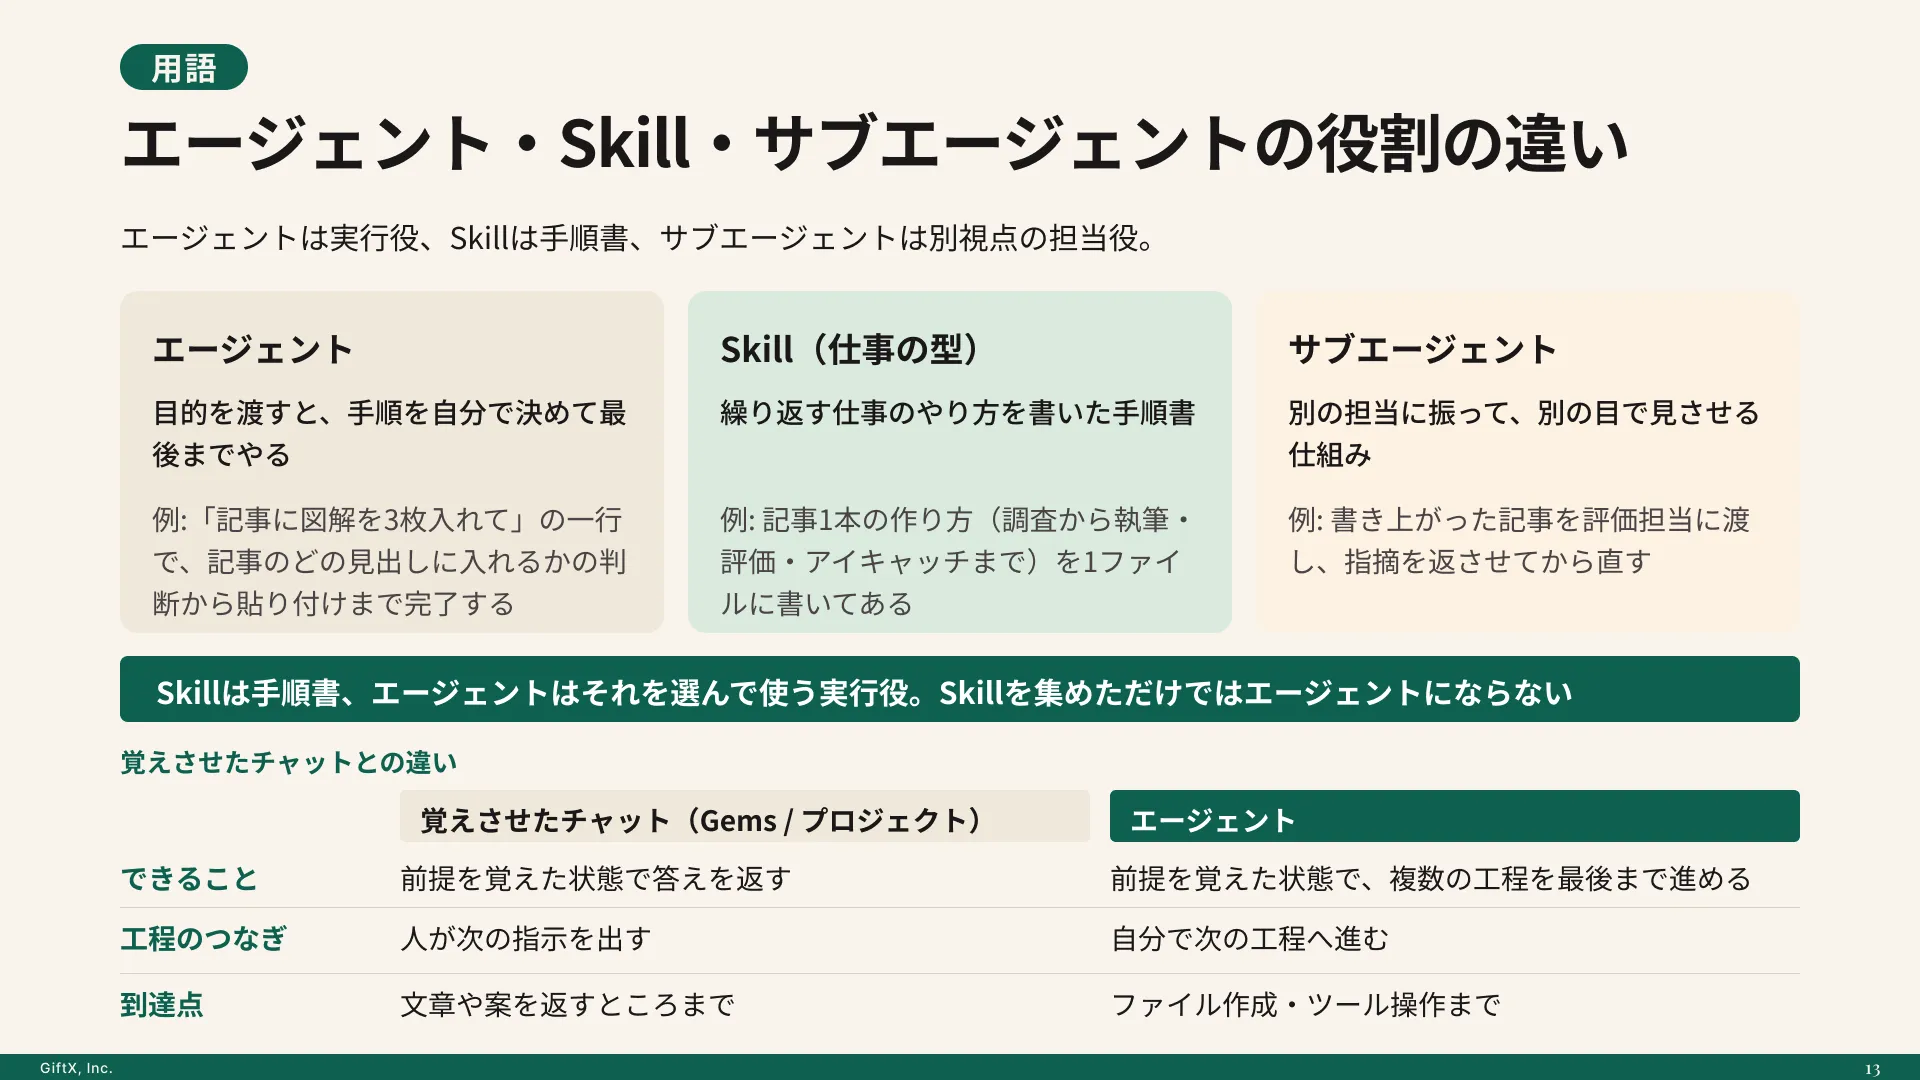
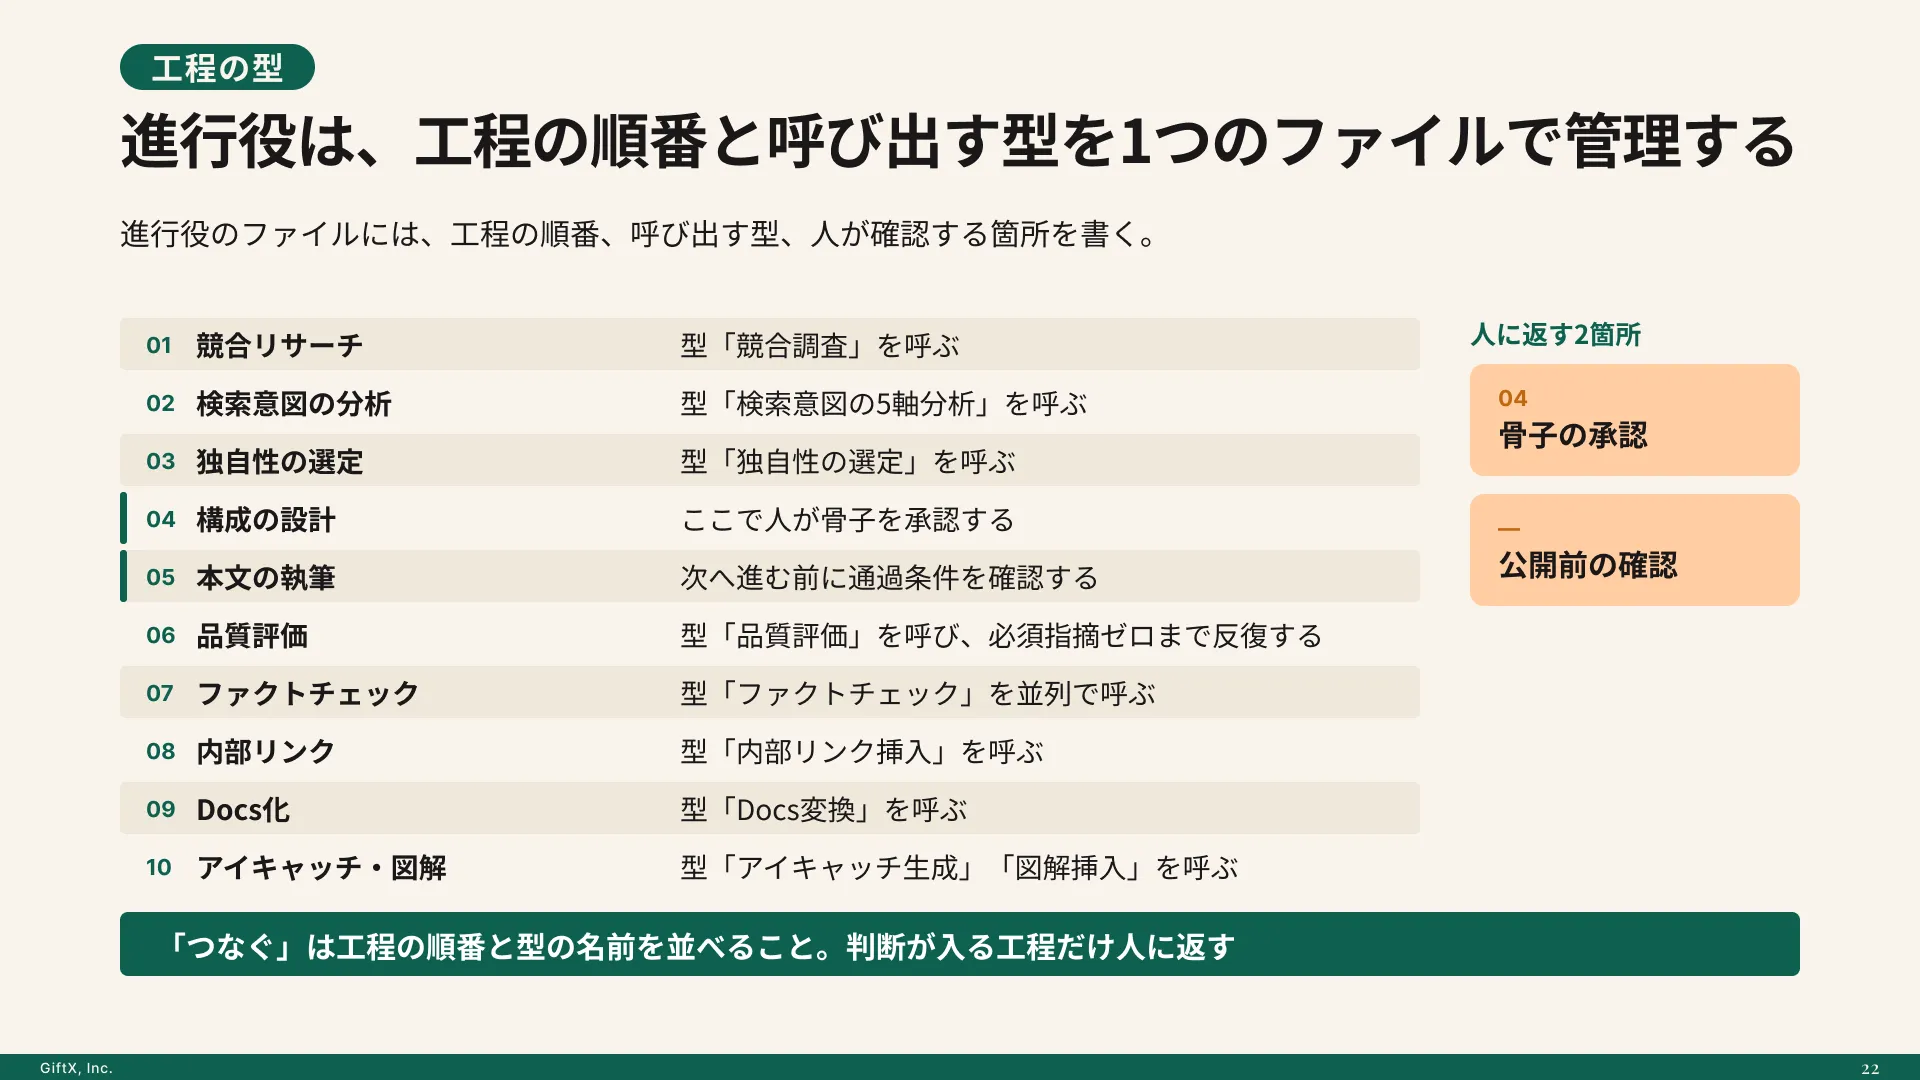
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
ピーク時の電力効率は1.5〜1.9倍
OpenAIは、ピーク時のスループットをチップパッケージの電力で割った値について、Jalapeñoが比較対象の1.5〜1.9倍だったと報告しています。スループットは、一定時間に処理できるトークンや要求の量です。電力効率が高いほど、同じ電力枠で多くの処理を実行できます。
公表された混合ワークロードの結果は次のとおりです。
| モデル | JalapeñoのTPS/kW | NVIDIA比較対象のTPS/kW |
|---|---|---|
| GPT-OSS 120B | 85,448 | GB200で44,960 |
| DeepSeek R1 670B | 19,641 | GB300で11,781 |
| Kimi K2.5 1T | 18,195 | GB300で11,862 |
TPS/kWは、1キロワットあたり1秒間に生成できるトークン数を示します。表はOpenAIが設定したモデル、精度、要求構成、システム条件での結果です。異なるモデルや設定でも同じ比率になるとは限りません。
エンドツーエンドのレイテンシーは1.7〜3.6倍低い
OpenAIは、同社の混合ワークロードにおけるエンドツーエンドのレイテンシーが、比較対象より1.7〜3.6倍低かったと説明しています。公表値では、GPT-OSSが1.03秒対1.80秒、DeepSeekが1.65秒対5.99秒、Kimiが1.56秒対5.31秒でした。
エンドツーエンドは、測定対象となる推論処理を入口から出口まで見た時間です。ただし、一般利用者のインターネット通信やサービス画面の描画時間まで含むとは限りません。実際の体感速度と比較するときは、測定範囲の違いに注意が必要です。
TBTの最小値は、GPT-OSSで0.69ミリ秒対1.87ミリ秒、DeepSeekで1.43ミリ秒対5.90ミリ秒、Kimiで1.44ミリ秒対5.48ミリ秒でした。この結果は、生成中のトークン間隔を小さくできる可能性を示します。
高い「53.7倍〜104.3倍」は条件を固定した比較
OpenAIのページには、53.7倍、104.3倍、56.1倍という大きな性能差も掲載されています。これは、両システムのレイテンシーを同じ水準にそろえた特定の測定点で、Jalapeñoが達成したスループット差です。チップ全体の平均性能や、あらゆる条件での電力効率を表す倍率ではありません。
大きな倍率だけを抜き出して「NVIDIAより100倍速い」と説明すると、測定条件を失ってしまいます。Jalapeñoの代表的な比較値としては、ピーク時の電力効率1.5〜1.9倍、混合ワークロードのレイテンシー1.7〜3.6倍低減を条件とともに示す方が適切です。
3モデルで測った理由
OpenAIは、自社の未公開モデルだけではなく、構造や規模の異なる3つのオープンモデルを使っています。これにより、特定の一モデルだけに最適化した結果ではないことを示そうとしています。一方、公開モデル3種類での測定だけで、すべてのOpenAIモデルや将来モデルの性能を保証することはできません。
今回の結果はOpenAI自身による測定です。測定方法と数値は公開されていますが、第三者が同じ環境で再現した独立検証ではありません。現時点では「OpenAIが公表した初期結果」として扱い、外部での追試や量産環境のデータを待つのが妥当です。
OpenAIのJalapeñoの使い方・始め方|利用者が直接選ぶチップではない
Jalapeñoは、PCへ装着したり、クラウドの管理画面で直接選んだりする一般販売のチップではありません。OpenAIが自社の推論基盤へ組み込み、サービスの裏側で使用する設計です。そのため、利用者向けの申込手順、SDK、専用APIは公開されていません。
ChatGPT利用者の場合
ChatGPT利用者がJalapeñoを使うために設定を変更する必要はありません。OpenAIが対応モデルや処理をJalapeñoへ割り当てれば、利用者はChatGPTを通じて間接的に利用することになります。
ただし、2026年8月31日時点で、どのChatGPTプラン、モデル、地域がJalapeño上で動いているかは公表されていません。OpenAIは2026年末までに導入を始める目標を示しており、現時点で一般提供が完了したとは確認できません。
OpenAI API利用者の場合
API利用者についても、Jalapeño専用のエンドポイントやチップ選択項目は発表されていません。既存のAPIを利用しながら、OpenAIによる基盤更新を待つ形になります。
将来、Jalapeñoの効率がAPIの応答性や供給量に反映される可能性はあります。しかし、対象モデル、提供地域、レート制限、サービス品質保証への反映方法は未公表です。システム設計や予算計画では、発表されていない改善を前提にしない方が安全です。
関連記事:ChatGPT APIとは?料金の実額と上限設定、Web版との違い・できること
開発者が今できる準備
Jalapeñoを直接試すことはできませんが、OpenAIサービスを利用する側では、基盤変更に依存しない準備ができます。
- 現在のAPI応答時間、トークン量、エラー率を記録します。
- モデル名やチップ名をコードへ固定せず、設定から切り替えられるようにします。
- 基盤が変わっても出力品質を比較できる評価用の入力を用意します。
- OpenAIのモデル更新情報と料金ページを継続して確認します。
この準備があれば、将来Jalapeñoが対象サービスへ導入された際に、導入前後の変化を自分たちの利用条件で確認できます。公表ベンチマークだけで効果を推定するより、実際の要求に近い測定を持つ方が判断しやすくなります。
OpenAIのJalapeñoの料金・購入方法|未公表の項目を整理
Jalapeñoの販売価格、レンタル価格、単体購入方法は公表されていません。そもそも現時点の位置付けはOpenAIの内部インフラ向けであり、一般の企業や個人が購入する製品として案内されていません。
次の表は、OpenAIの公式発表で確認できる提供状況を整理したものです(最新確認時点(2026年8月)、出典: openai.com)。
| 確認項目 | 2026年8月31日時点の状況 | 利用者への意味 |
|---|---|---|
| チップの販売価格 | 未公表 | 単体購入の予算は見積もれない |
| 一般向け購入方法 | 提供なし | 販売店や申込ページはない |
| 専用クラウド料金 | 未公表 | Jalapeño指定の利用プランはない |
| ChatGPT料金への反映 | 発表なし | 現行プランの変更を示す情報はない |
| API料金への反映 | 発表なし | 現行API価格の変更を示す情報はない |
チップの電力効率が高まっても、サービス料金が同じ比率で下がるとは限りません。料金には、チップ以外の設備、ネットワーク、モデル開発、安全対策、運用など複数の費用が含まれます。OpenAIはJalapeño発表時に、ChatGPTやAPIの値下げを発表していません。
購入可能性を調べる場合は、OpenAIの公式発表と料金ページを確認します。BroadcomやCelesticaが開発に参加していても、両社からJalapeñoを購入できるという発表はありません。共同開発先と販売元を分けて確認してください。
Jalapeñoの料金判断で確認する3項目
将来、Jalapeñoに関する新しい提供条件が出たときは、価格だけでなく次の3項目を確認します。
- 対象がチップ単体、専用クラウド、既存APIのどれか
- 最低利用量や契約期間などの利用条件があるか
- 現在使っているモデルと地域が対象に含まれるか
「Jalapeño対応」と書かれていても、利用形態によって費用の計算方法は変わります。既存APIの内部基盤として使われるだけなら、利用者はチップの価格ではなくAPI料金を比較します。専用の計算環境が提供される場合は、時間単価に加えて最低利用量やデータ転送費などを確認する必要があります。
関連記事:ChatGPTの料金プラン比較|Plus・Pro・Businessの違いと選び方
JalapeñoとNVIDIA GB200・GB300の違い
JalapeñoとNVIDIA GB200・GB300は、いずれも大規模なAI処理に使われる計算基盤ですが、狙いと提供方法が異なります。JalapeñoはOpenAIの推論処理に合わせた専用チップで、GB200・GB300は幅広いAIワークロードを支えるNVIDIAのプラットフォームです。ベンチマークの勝敗だけでなく、用途、入手性、ソフトウェアの広がりを含めて比較する必要があります。
| 比較項目 | OpenAI Jalapeño | NVIDIA GB200・GB300 |
|---|---|---|
| 主な目的 | OpenAIモデルの推論最適化 | 学習と推論を含む幅広いAI処理 |
| 設計・開発 | OpenAI、Broadcom、Celestica | NVIDIAと製造・システム各社 |
| 利用者 | OpenAIの内部基盤が中心 | クラウド事業者やデータセンター利用者 |
| 入手方法 | 一般提供なし | 対応クラウドやシステムを通じて提供 |
| 公開ベンチマーク | 3つのオープンモデルで初期結果を公開 | 多様なモデルと用途の実績がある |
表から分かるように、JalapeñoはOpenAI固有の推論効率を高めるための垂直統合が特徴です。GB200・GB300は、複数の開発環境や用途で使える汎用性と既存のソフトウェア基盤を持ちます。両者は完全な代替関係ではありません。
ベンチマークはモデルごとに比較対象が違う
OpenAIの初期結果では、GPT-OSS 120BだけがGB200との比較で、DeepSeek R1 670BとKimi K2.5 1TはGB300との比較です。3モデルの値をまとめて「GB300に対して最大何倍」と表現すると、GPT-OSSの比較条件が混ざります。
また、チップ数、数値精度、バッチ処理、入力と出力の長さなどが異なれば、結果も変わります。公式ページのグラフは、同じレイテンシーを目指す場合と、最大スループットを目指す場合で別の測定点を示しています。目的に近い条件を選んで読む必要があります。
JalapeñoはNVIDIAを直ちに置き換えるものではない
OpenAIは、Jalapeñoを含む自社開発基盤と、NVIDIAなど外部企業のアクセラレーターを組み合わせる方針です。フルスタック戦略の説明でも、特定の一種類へ集約するのではなく、複数の計算基盤を目的に応じて使う考え方が示されています。
OpenAIには学習用の大規模計算も必要です。推論専用のJalapeñoが優れた結果を示しても、学習や幅広い実験まで一台で担うとは発表されていません。「Jalapeñoの登場でOpenAIがNVIDIAを使わなくなる」という見方は、現時点の公式方針とは一致しません。
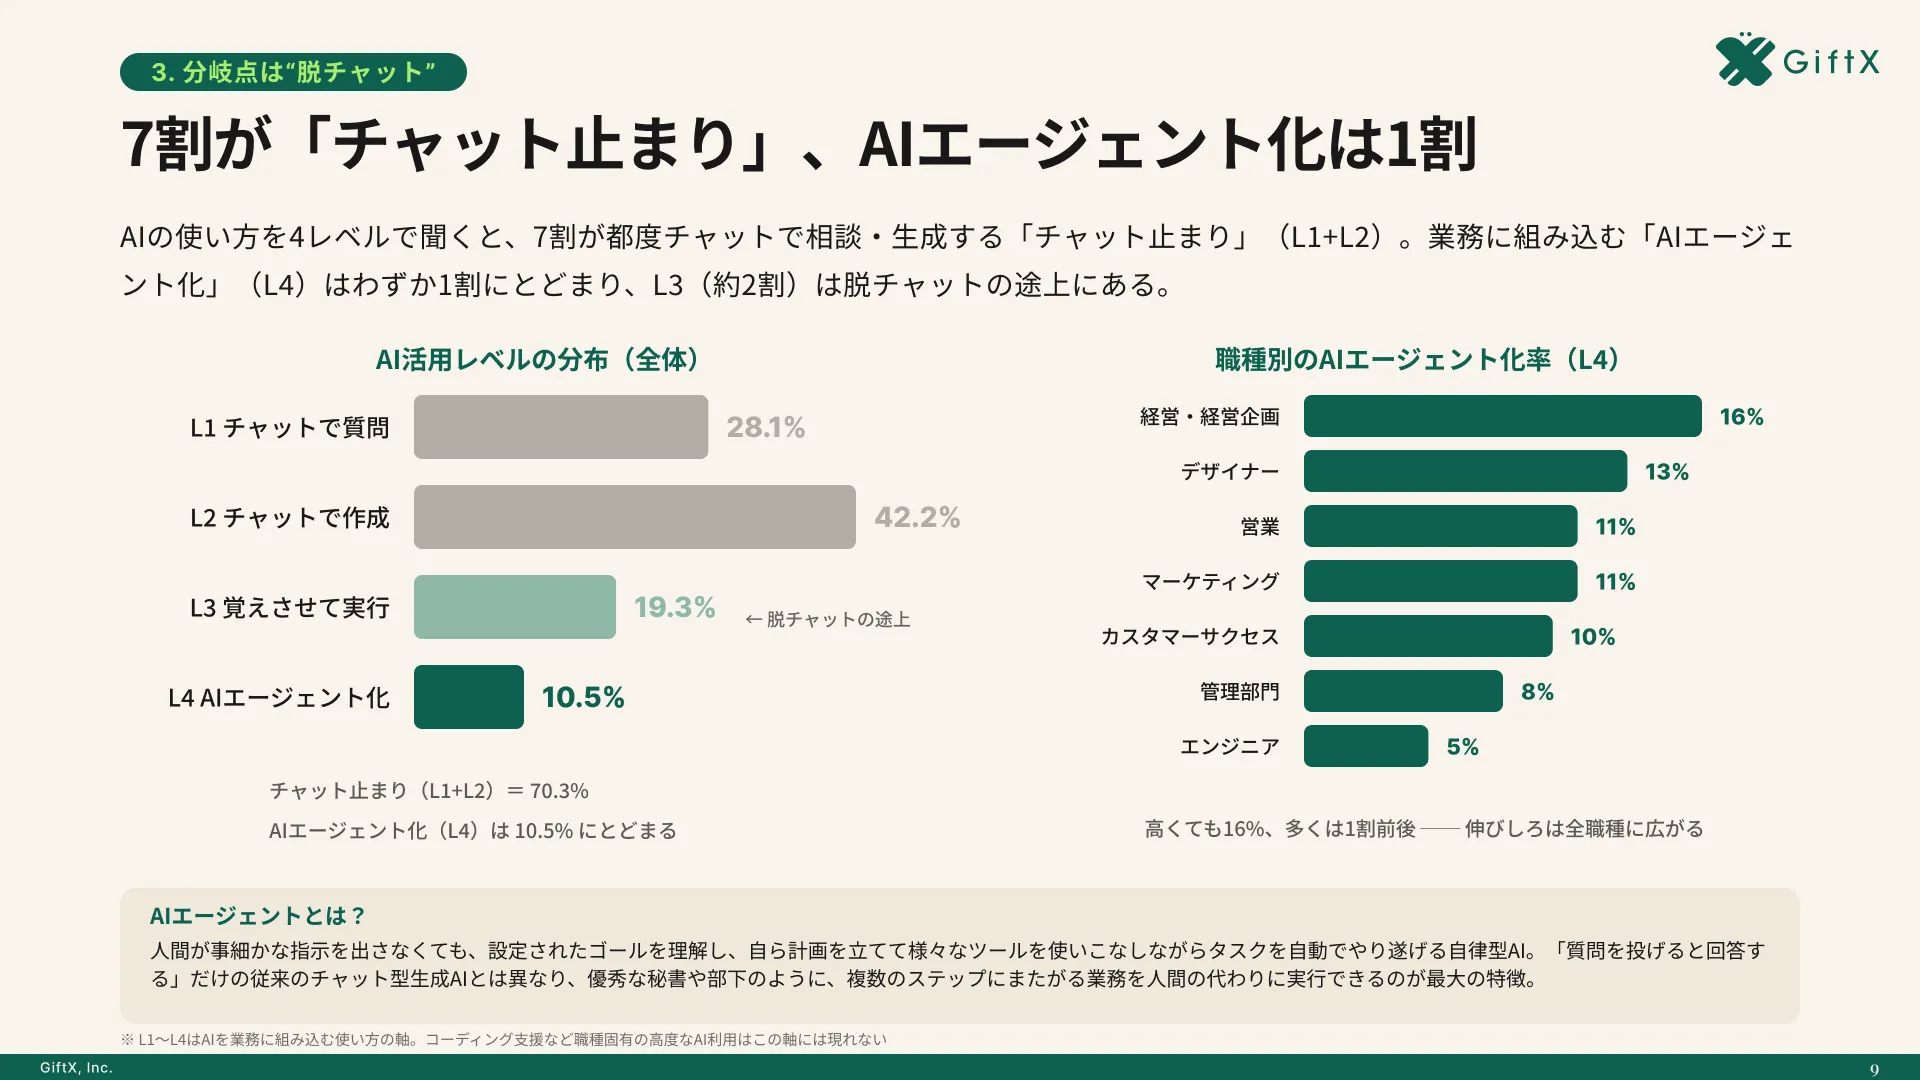
全国8,000人調査で、AIの活用方法によって生産性向上に約3.8倍の差が生まれることが判明。
専用設計と汎用性の違い
専用設計は、対象処理が明確なときに高い効率を狙えます。一方、モデル構造が大きく変わった場合や、想定外の処理を動かす場合には、ソフトウェアとチップの追加対応が必要になる可能性があります。
汎用性の高い基盤は、多様なモデル、開発ツール、既存コードを利用しやすい利点があります。どちらが常に優れているかではなく、対象処理の安定性、必要な柔軟性、供給計画を含めて選ぶものです。Jalapeñoについては利用者が直接選べないため、この比較はOpenAIのインフラ戦略を理解するためのものになります。
Jalapeñoの注意点|公表値を読むときの4つの条件
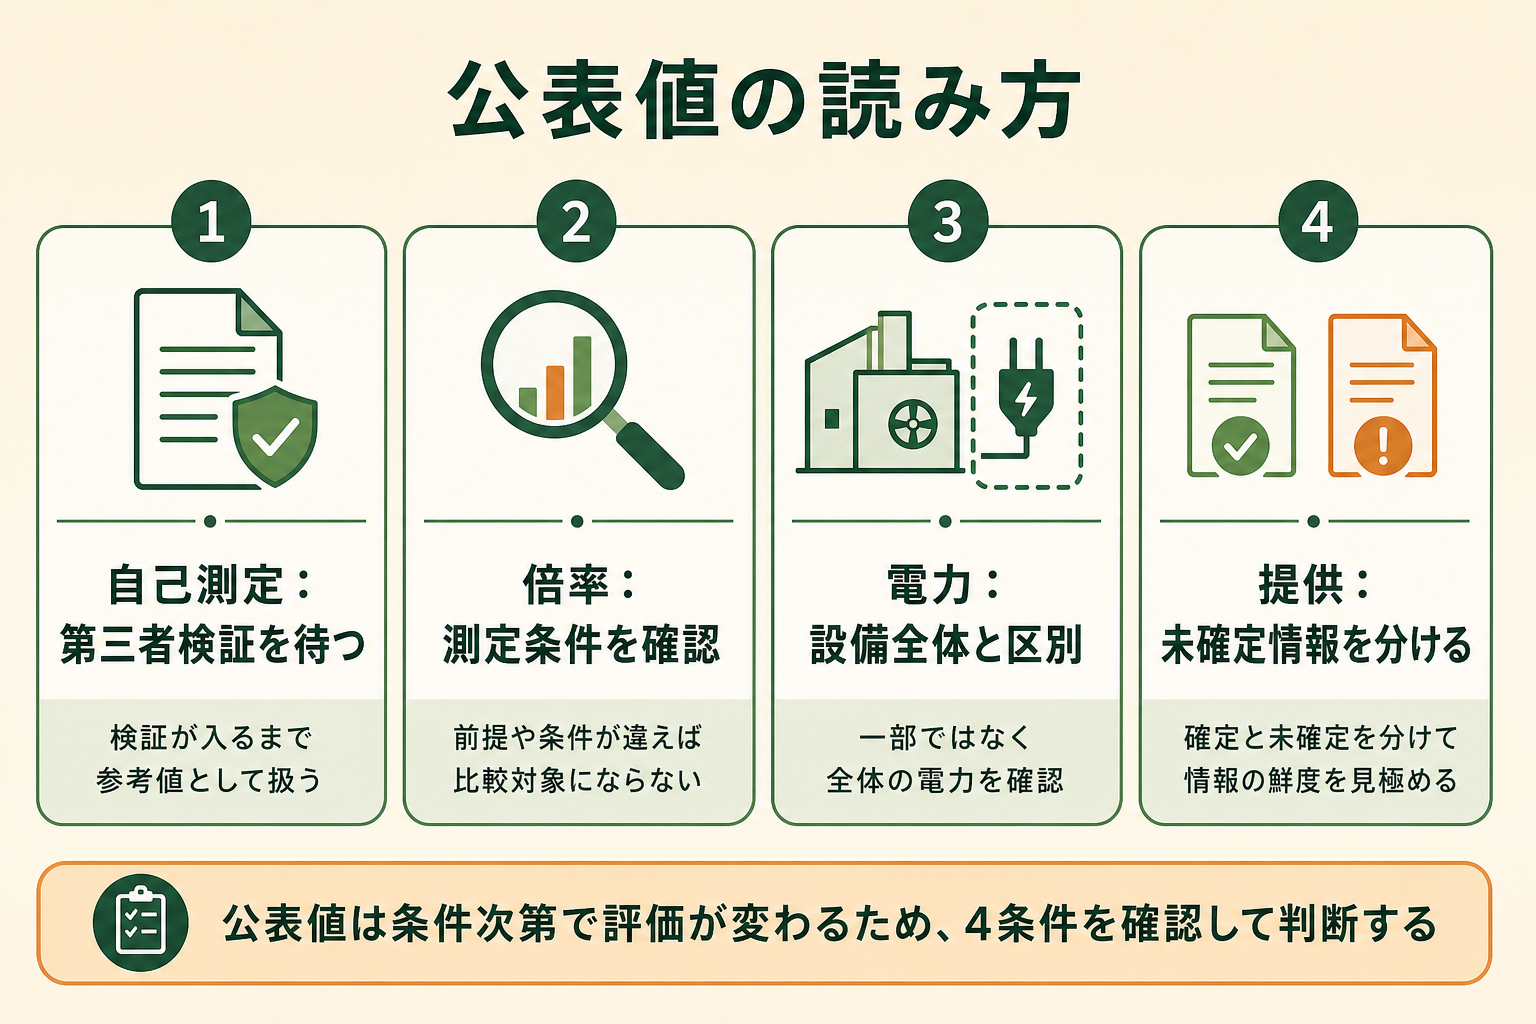
Jalapeñoの初期結果は、OpenAIがカスタムチップで実際の大規模モデルを動かしたことを示す判断材料です。一方、導入判断や将来予測に使うには、次の4つの条件を押さえる必要があります。
1. 数値はOpenAIによる自己測定である
公開された結果はOpenAIが設計し、測定したものです。モデル名、比較対象、主要な指標は示されていますが、独立した第三者による再現結果は確認できません。自己測定だから誤りだという意味ではなく、初期データとして検証余地が残るということです。
今後、量産システムでの長期運用、異なる入力条件、第三者の測定が公開されれば、性能の適用範囲がより明確になります。それまでは、公式値の前に「OpenAIによると」と付けて扱うのが適切です。
2. 大きな倍率には測定条件がある
53.7〜104.3倍という値は、同一レイテンシーにそろえた特定の測定点におけるスループット差です。一般的な電力効率の代表値は1.5〜1.9倍であり、エンドツーエンドのレイテンシーは1.7〜3.6倍低いと報告されています。
同じページに複数の倍率がある場合は、指標、分母、固定した条件を確認します。TPS/kW、レイテンシー、TBTはそれぞれ別の側面を測るため、単純に足したり、一つの「速さ」へまとめたりできません。
3. チップ電力と設備全体の電力は異なる
OpenAIの電力効率は、チップパッケージの消費電力で正規化されています。データセンター全体では、冷却、電源変換、ネットワーク、ストレージ、待機設備なども電力を使います。
そのため、TPS/kWの差からサービス全体の電気代や環境負荷を直接算出することはできません。設備全体のPUE、稼働率、チップ数、ラック構成などの情報が必要ですが、Jalapeñoについては詳細が公表されていません。PUEはデータセンター全体の電力をIT機器の電力で割った効率指標です。
4. 量産・提供範囲・料金は未確定である
OpenAIは2026年末までに導入を始める目標を示していますが、資格試験、量産規模、ソフトウェア成熟度の確認は続いています。どのモデル、地域、サービスから使うかは未公表です。
また、製造プロセス、搭載メモリの詳細、配備台数、総保有コスト、サービス料金への反映も明らかになっていません。将来の改善を期待しつつ、現在の契約や設計は確認済みの提供条件に基づいて進める必要があります。
Jalapeñoの導入時期と今後の展開
OpenAIは2026年末までにJalapeñoの導入を始めることを目標にしています。これは導入開始の目標であり、全サービスや全地域への一斉展開を意味しません。初期配備後に、運用データを見ながら対象を広げる可能性があります。
2026年6月の発表から8月の初期結果まで
2026年6月24日(米国時間)の最初の発表では、エンジニアリングサンプル上でGPT-5.3-Codex-Sparkが動作したことが示されました。エンジニアリングサンプルは、量産前に動作や性能を確認する試作チップです。
同年8月26日の更新では、3つのオープンモデルによるベンチマークが追加されました。最初の動作確認から、異なるモデルを使った比較へ進んだ段階です。短期間で情報が更新されているため、今後も公式ページの数値や提供計画が変わる可能性があります。
次に確認すべき公式情報
Jalapeñoの実用段階を判断するには、次の情報を確認します。
- 量産開始と実際の配備規模
- 対象となるOpenAIモデルやサービス
- 本番環境での性能、安定性、消費電力
- APIのレート制限や料金への影響
- 独立した第三者による再現結果
これらが公開されるまでは、Jalapeñoを「初期ベンチマークを公開した導入前のカスタム推論チップ」と位置付けるのが正確です。完成済みの一般向け製品や、すべてのOpenAIサービスをすでに動かす標準基盤として扱うのは早いでしょう。
OpenAIのJalapeñoに関するよくある質問
OpenAIのJalapeñoは購入できますか?
2026年8月31日時点では購入できません。OpenAIの内部推論基盤向けに設計されており、一般向け価格、販売店、購入申込ページは公表されていません。BroadcomやCelesticaから購入できるという案内もありません。
JalapeñoはすでにChatGPTやAPIで使われていますか?
どのChatGPTプランやAPIモデルで使われているかは公表されていません。OpenAIは2026年末までに導入を始める目標を示していますが、対象サービスや地域は未発表です。現時点で利用者がJalapeñoを選ぶ設定もありません。
JalapeñoはNVIDIA製品より常に速いのですか?
すべての条件で100倍速いわけではありません。最大104.3倍という値は、同じレイテンシーにそろえた特定の測定点におけるスループット差です。OpenAIが示したピーク時の電力効率の代表値は1.5〜1.9倍で、モデルと条件により結果が異なります。
Jalapeñoが速い理由は何ですか?
OpenAIのモデルと推論処理に合わせて設計し、KVキャッシュなどのモデル状態をチップの近くに保持することで、データ移動を減らしているためです。モデルとチップ向けソフトウェアを共同で最適化できる点も、カスタム設計の利点です。
JalapeñoはAIモデルの学習にも使えますか?
OpenAIはJalapeñoを推論チップとして発表しており、学習用チップとしての性能は示していません。OpenAIは学習と推論で複数の計算基盤を組み合わせる方針です。Jalapeñoが学習用途を担うと判断できる公式情報はありません。
JalapeñoでChatGPTやAPIは安くなりますか?
料金変更は発表されていません。電力効率の改善は運用コストを抑える要因になり得ますが、サービス料金は設備、モデル開発、安全対策、運用など多くの要素で決まります。将来の値下げを前提にせず、OpenAIの公式料金を確認してください。
AIエージェント導入で陥りがちな3つの落とし穴
Jalapeñoのような推論基盤の進化は、AIエージェントの応答性や処理量を支える要素です。ただし、基盤の性能が上がるだけで、AIエージェントが目的どおり動くわけではありません。実際の導入では、次の3つの落とし穴に注意が必要です。
1. いきなり全てを自動化しようとする
「AIで何かを自動化する」という目標だけでは、必要な入力、判断基準、完了条件を決められません。いきなり全てへ対象を広げると、評価できないまま開発量が増えます。最初に一つの作業と、その作業で改善したい時間・品質・件数を定めます。
2. 壮大な戦略から始めて作業を定めない
壮大な戦略を掲げるだけでは、AIエージェントへ渡す情報や完了条件が決まりません。参照先、更新責任者、閲覧可能な範囲、実行してよい操作を一つの作業単位で先に整理する必要があります。
3. 汎用チャットを業務フローへそのまま組み込む
汎用チャットをカスタマイズせず業務フローへ組み込むと、誤った判断が外部操作につながるおそれがあります。金額、契約、公開、個人情報など影響の大きい処理では、人の承認を挟む境界を明確にします。失敗時に停止し、履歴を追える設計も必要です。
スモールスタートで1業務をAIエージェントに任せる
導入初期は、入力と出力を明確にできる1業務から始めます。実データで精度と所要時間を測り、人の確認が必要な場面を特定してから対象を広げる方法が現実的です。
つまり、チップやモデルの性能だけでなく、業務フロー・データ・運用体制まで含めた設計がAIエージェント導入を成功させる鍵です。どの業務から始めるべきか整理したい場合は、AIエージェント構築支援サービスでご相談いただけます。
まとめ
OpenAI Jalapeñoは、OpenAIがBroadcomらと開発した初のカスタムAI推論チップです。OpenAIの初期測定では、3つのオープンモデルでピーク時の電力効率が比較対象の1.5〜1.9倍、エンドツーエンドのレイテンシーが1.7〜3.6倍低い結果を示しました。大きな倍率は特定条件の測定値であり、ChatGPT全体の速度や料金への反映は未公表です。2026年末の導入開始目標と今後の本番データを確認しながら、AIエージェントはまず1業務のスモールスタートで確かめましょう。
AI活用の伴走支援をご検討の方へ
本記事で紹介したAIエージェントの活用に向けて、自社の業務でも具体的に進めたい・相談したいとお考えの方は、ぜひGiftX AIエージェント構築支援までお問い合わせください。
GiftX AIエージェント構築支援では、貴社の業務に合わせて1業務単位のスモールスタートから本番運用まで、AIエージェント構築をワンストップで支援します。ユースケースの洗い出しから、PoC、本番運用、社内ナレッジ化まで伴走します。
AI活用にご関心のある方は、ぜひ一度ご相談ください。