GPT-6 Astra APIを実装する前に確認する3項目
実装を始める前に、API、認証、成功条件を分けて確認します。最初の疎通確認へ多くの機能を載せると、失敗時に原因を切り分けにくくなります。
関連記事:GPT-6 Astraとは?使い方・料金・性能・GPT-5.6との違い
ツール利用はResponses APIを選ぶ
GPT-6 AstraのモデルIDはgpt-6-astraです。Chat Completions APIにも対応していますが、ツール呼び出しはResponses APIでのみ利用できます。Function CallingやWeb検索などを組み込む予定があるなら、最初から/v1/responsesを採用します(2026年9月時点、出典: developers.openai.com)。
APIキーはサーバー側で管理する
APIキーは環境変数やシークレット管理基盤から読み込み、ブラウザへ配布するJavaScriptや公開リポジトリへ入れません。
権限不足とモデル未提供は、アプリケーションの処理失敗とは別の問題です。最小リクエストが失敗したら、モデルID、Projectのモデルアクセス、APIキー、請求・利用上限の順で確認します。
最初の成功条件を固定する
HTTP 200だけを成功にせず、次の3点を確認します。
response.idを取得できるresponse.output_textから期待するテキストを読めるresponse.usageをログへ残せる
ツールを追加する前の基準応答を保存しておくと、後の変更で壊れた箇所を比較できます。
Responses APIで最小リクエストを実装する
Python SDKを使う最小例です。事前にOPENAI_API_KEYをサーバー環境へ設定し、OpenAI SDKをインストールします。
pip install openai
from openai import OpenAI

client = OpenAI()

response = client.responses.create(

model="gpt-6-astra",

reasoning=\{"effort": "low"\},

input="この障害報告を、原因・影響・次の対応の3項目で要約してください。",

)

print(response.id)

print(response.output_text)

print(response.usage)
output_textはテキスト出力をまとめて読むための便利なプロパティです。一方、ツール呼び出しや複数種類の出力を扱う場合は、response.outputの各itemをtypeで判定します。すべての出力がmessageとは限らないため、配列の先頭だけを決め打ちして読まないようにします。
reasoning.effortはlow、medium、high、xhigh、maxに対応します。まずlowで動作確認し、難しい判断を含む代表タスクで品質が不足するときだけ上げると、待ち時間と費用を比較しやすくなります。Astraはnoneに対応しません。
GPT-6 AstraでFunction Callingを実装する
Function Callingでは、モデルが外部処理を直接実行するわけではありません。モデルが呼び出し内容を返し、アプリケーションが検証・実行し、その結果を同じcall_idへ返します。
import json

from openai import OpenAI

client = OpenAI()

tools = [\{

"type": "function",

"name": "get_order_status",

"description": "注文番号から配送状況を確認する",

"strict": True,

"parameters": \{

"type": "object",

"properties": \{

"order_id": \{"type": "string"\},

\},

"required": ["order_id"],

"additionalProperties": False,

\},

\}]

first = client.responses.create(

model="gpt-6-astra",

input="注文A-1024の配送状況を確認してください。",

tools=tools,

)

outputs = []

for item in first.output:

if item.type != "function_call":

continue

args = json.loads(item.arguments)

# 実運用では認可、入力検証、タイムアウトをここで行う

result = \{"order_id": args["order_id"], "status": "発送準備中"\}

outputs.append(\{

"type": "function_call_output",

"call_id": item.call_id,

"output": json.dumps(result, ensure_ascii=False),

\})

if outputs:

final = client.responses.create(

model="gpt-6-astra",

previous_response_id=first.id,

input=outputs,

tools=tools,

)

print(final.output_text)
本番では、利用者が対象へアクセスできるか、書き込みを伴うかをアプリ側で検証します。購入、送信、削除、権限変更には人の承認を挟み、call_idと実行状態を保存して二重実行を防ぎます。
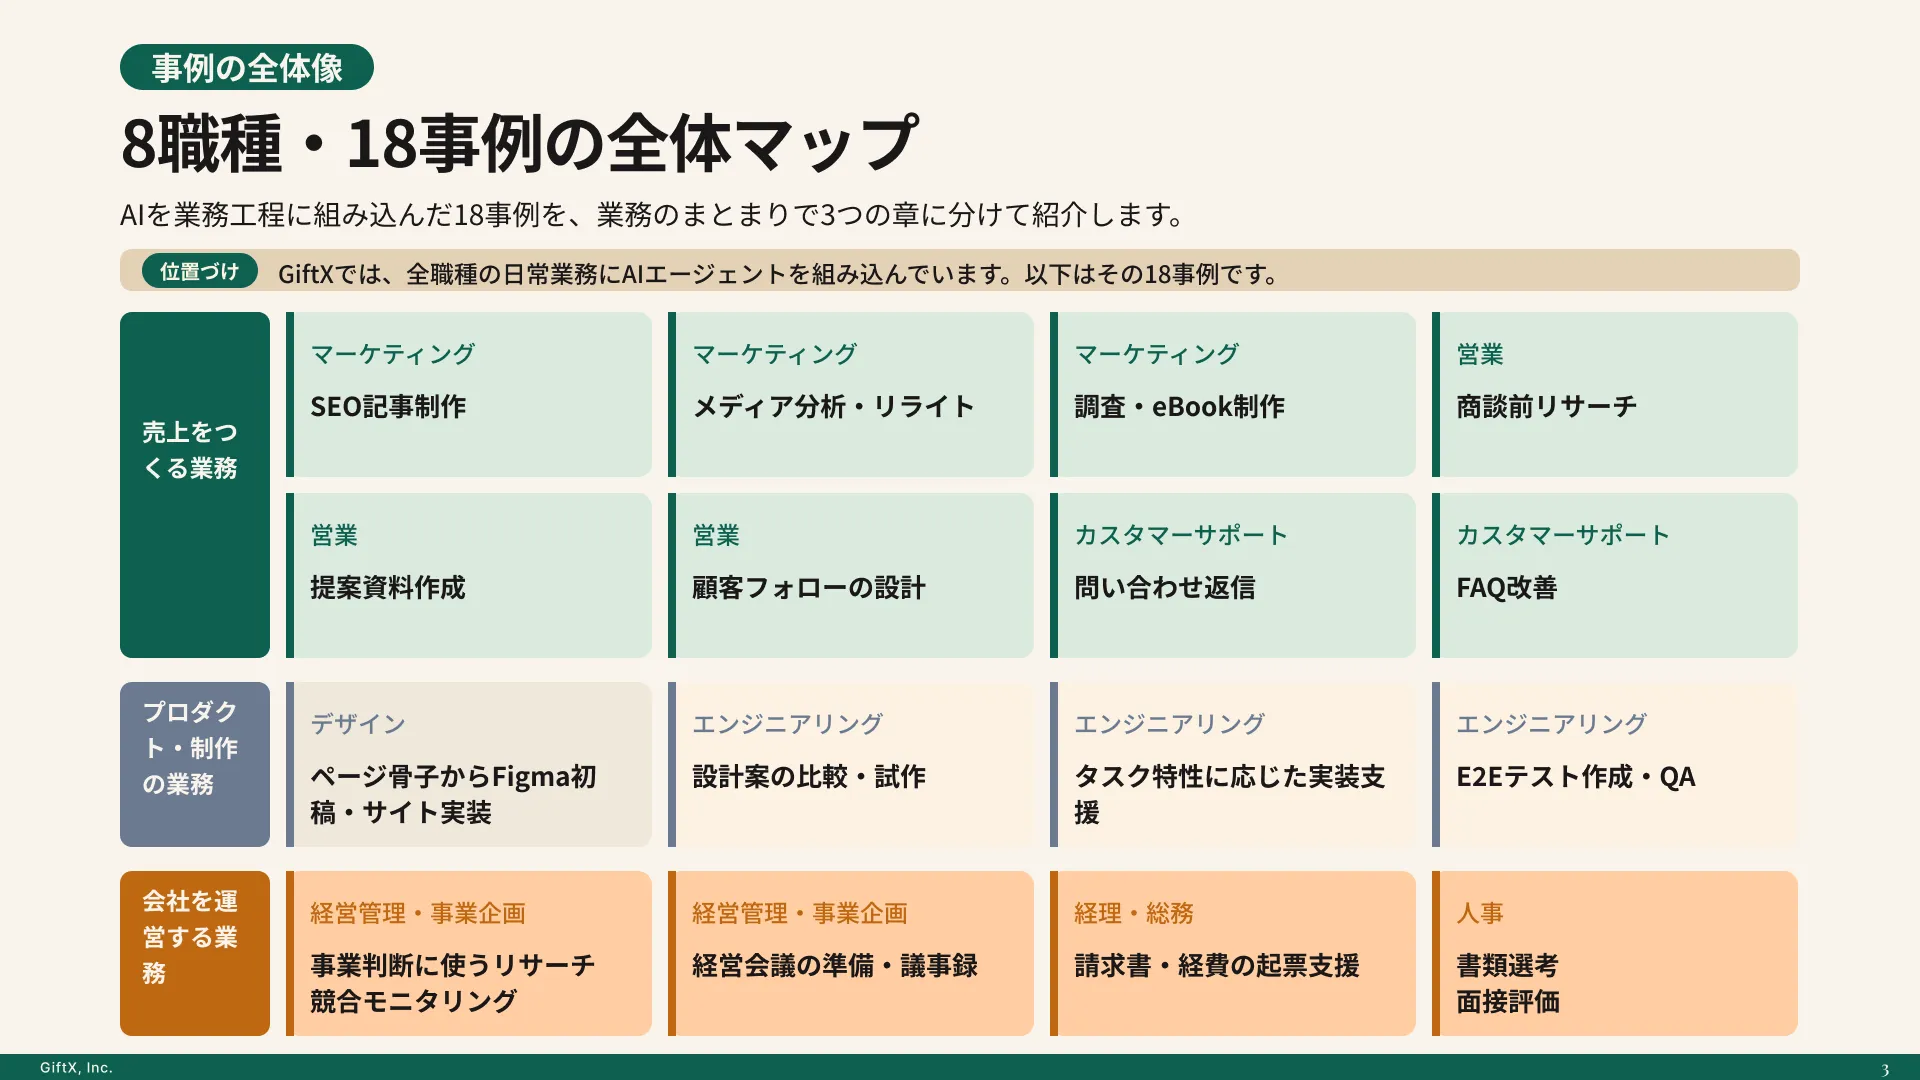
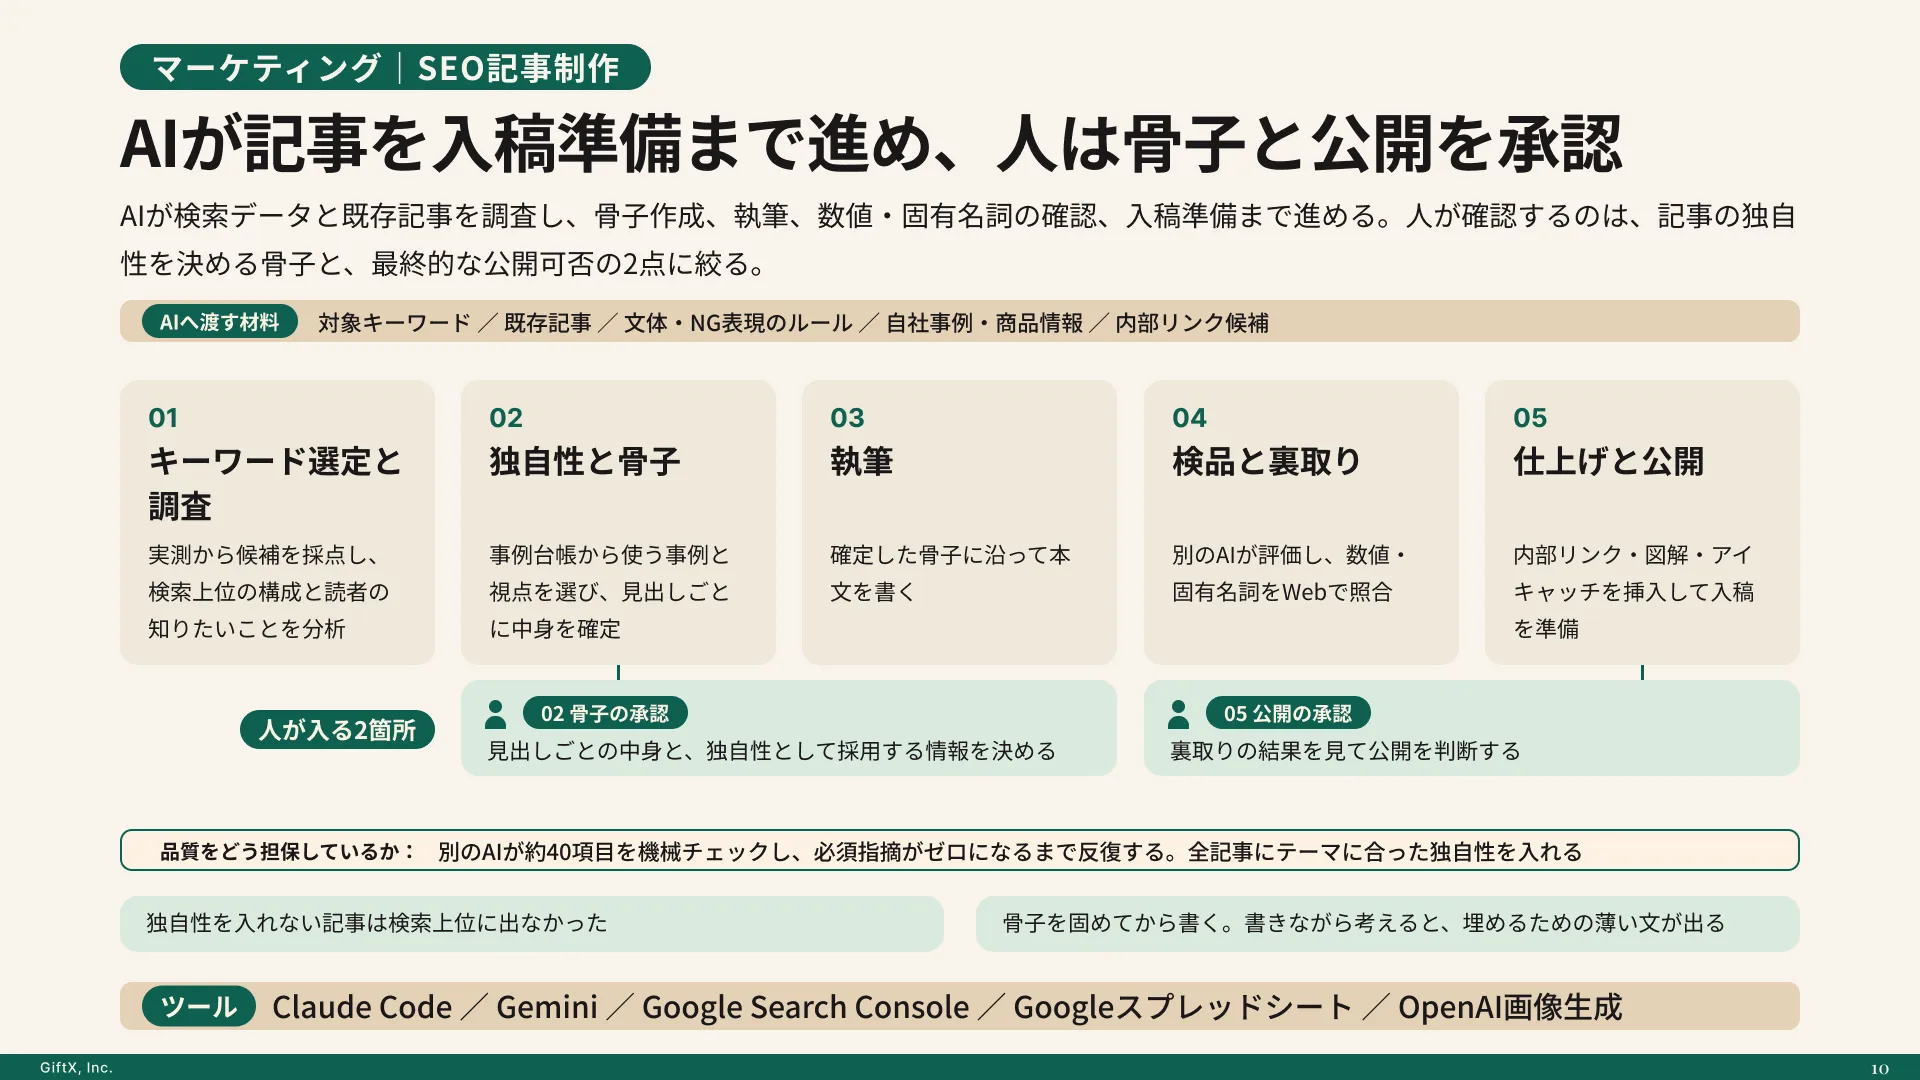
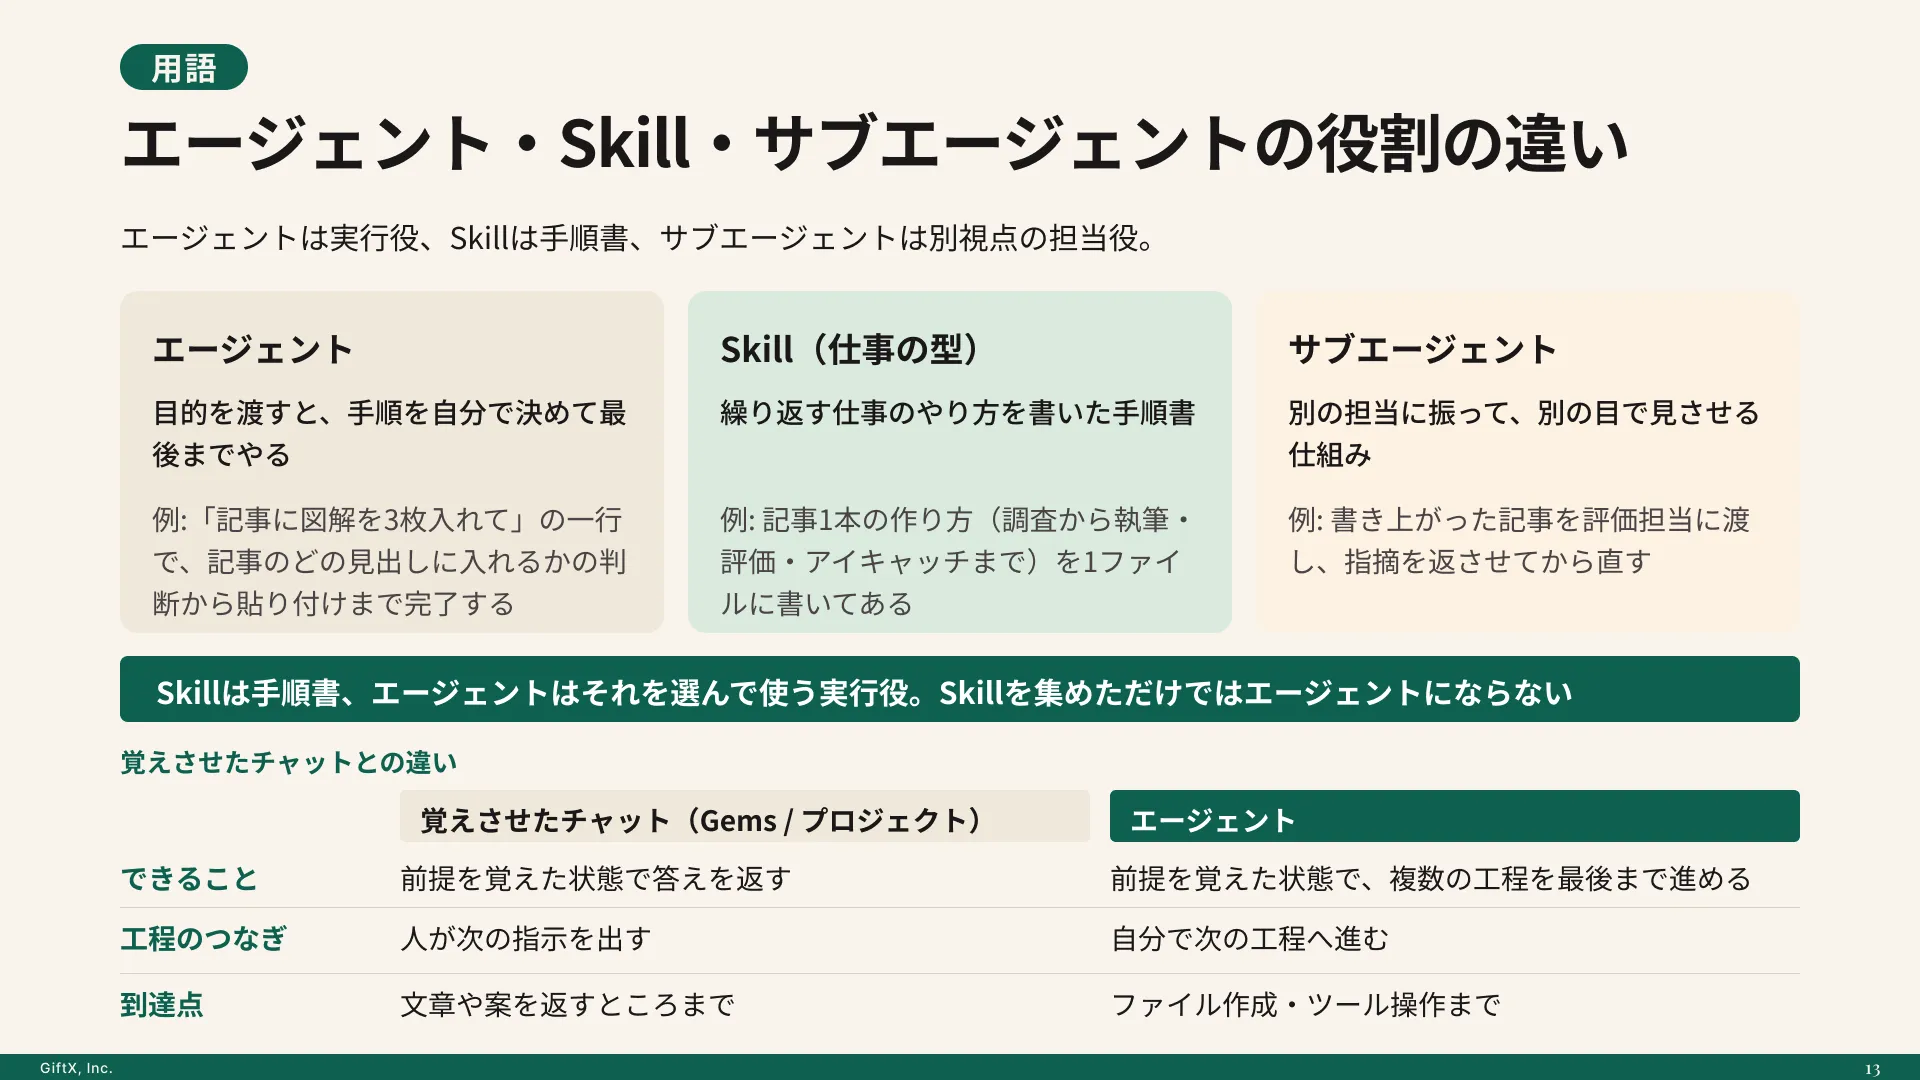
AIエージェントを「どう作り、どう育てるか」を、GiftX記事制作エージェントの実物で解説。
非同期ツール呼び出しと途中指示を扱う
GPT-6 Astraには、長時間処理を止めずに進めるための機能があります。ただし、モデル側だけでジョブ管理が完結するわけではありません。アプリケーションが状態を保持し、結果や追加指示を正しい応答へ結び付けます。
async tool callingで待ち時間を重ねる
functionまたはcustom toolの定義へasync: trueを付けると、モデルはそのツール結果を待つ間に、別のツールを呼んだり独立した作業を進めたりできます。ツールを実行する主体はアプリケーションのままです。OpenAIのBackground modeとは別機能なので、ジョブキュー、タイムアウト、失敗時の再実行は自社側で管理します。
async_tool = \{

"type": "function",

"name": "search_contracts",

"description": "契約書群から指定条件を検索する",

"async": True,

"strict": True,

"parameters": \{

"type": "object",

"properties": \{"query": \{"type": "string"\}\},

"required": ["query"],

"additionalProperties": False,

\},

\}
完了結果は、最初の呼び出しに付いたcall_idを使い、後続のResponsesリクエストへfunction_call_outputとして返します。アプリ側ではcall_idとジョブIDの対応表を保存し、完了済みジョブの再実行を防ぎます(出典: developers.openai.com)。
Mid-turn steeringで進行中の方向を修正する
Mid-turn steeringは、WebSocket接続中の応答へ追加指示を送る機能です。進行中のresponse IDをprevious_response_idへ指定して、response.steerを送ります。
\{

"type": "response.steer",

"previous_response_id": "resp_1",

"input": "対象期間を直近3か月に限定し、公開情報だけを使ってください。"

\}
response.steer.acceptedはキューへの受理であり、反映完了ではありません。既出力や実行済み操作は取り消されず、開始済みツールも自動キャンセルされません。後続のresponse.createdとresponse.completedまでを同じ論理ターンとして追跡します(出典: developers.openai.com)。
configuration_updateで推論強度を変える
難しい検討だけreasoning effortを上げる場合は、次のuser messageより前にconfiguration_updateを入れます。
next_response = client.responses.create(

model="gpt-6-astra",

previous_response_id=response.id,

reasoning=\{"effort": "low"\},

input=[

\{

"type": "configuration_update",

"reasoning": \{"effort": "high"\},

\},

\{

"role": "user",

"content": "障害パターンとロールバック条件を詳しく分析してください。",

\},

],

)
リクエスト側のreasoning.effortを保つため、プロンプトprefixをキャッシュへ残しやすくなります。この機能はAstraの標準single-agent mode向けで、automatic compactionやautomatic truncationとの併用には制約があります。
Chat Completions APIと旧モデルから移行する
移行では、エンドポイントだけでなく入力、出力、状態、パラメータの4点を棚卸しします。
| 確認項目 | 既存実装 | Responses APIでの扱い |
|---|---|---|
| 入力 | `messages` | `input`へ文字列またはmessage/itemを渡す |
| テキスト出力 | `choices[0].message.content` | `output_text`または`output` itemを読む |
| 会話状態 | messagesを再送 | `previous_response_id`または履歴再送 |
| ツール要求 | tool callを読む | `function_call` itemを読む |
| ツール結果 | tool role message | `function_call_output` itemを返す |
| ストリーム | chunk差分 | Responsesのevent typeごとに処理する |
非対応パラメータを削除する
GPT-6 Astraではtemperature、top_p、top_logprobsを削除します。Chat Completionsではlogprobsも削除し、Responsesではincludeに指定したmessage.output_text.logprobsを外します。reasoning.effortでnoneまたはminimalを使っていた実装は、まずlowへ置き換えて比較します(出典: developers.openai.com)。
全モデルへ同じパラメータを付けている場合は、モデルごとの許可リストを作り、起動時に設定を検証します。
回帰テストを先に固定する
切り替え前に、代表入力と期待条件を保存します。文章の完全一致ではなく、構造化出力のschema適合、必須項目、禁止操作、ツール引数、根拠URL、最大処理時間などを判定します。
最低限、次を回帰テストへ含めます。
- 通常のテキスト応答
- ツール呼び出しなしで完了する入力
- 1回と複数回のFunction Calling
- ツール失敗、タイムアウト、空結果
- 追加指示と中断後の再開
- 長文入力と出力上限
- 安全上拒否・停止された場合の縮退
プロンプトキャッシュとAPIコストを設計する
GPT-6 Astraは1,050,000トークンのコンテキストと128,000トークンの最大出力に対応します。ただし、入る量と毎回入れるべき量は別です。272Kを超える入力は、リクエスト全体について入力・キャッシュ料金が2倍、出力料金が1.5倍になります(2026年9月時点、出典: developers.openai.com)。
変わりにくいdeveloper message、tool schema、共通ルールをprefix側へ置き、毎回変わるデータを後ろへ置きます。GPT-5.5以前のprompt_cache_retentionは、prompt_cache_options.ttlの30mへ置き換えます。
response = client.responses.create(

model="gpt-6-astra",

input=messages,

tools=tools,

prompt_cache_key="contract-review-v1",

prompt_cache_options=\{"mode": "implicit", "ttl": "30m"\},

)
2026年9月時点で、Standardの100万トークン単価は入力10ドル、キャッシュ入力1ドル、キャッシュ書き込み12.50ドル、出力50ドルです。cached tokens、cache write tokens、output tokens、ツール料金を分けて集計し、用途別にmax_output_tokensを設定します。
GPT-6 Astra APIを段階移行する手順
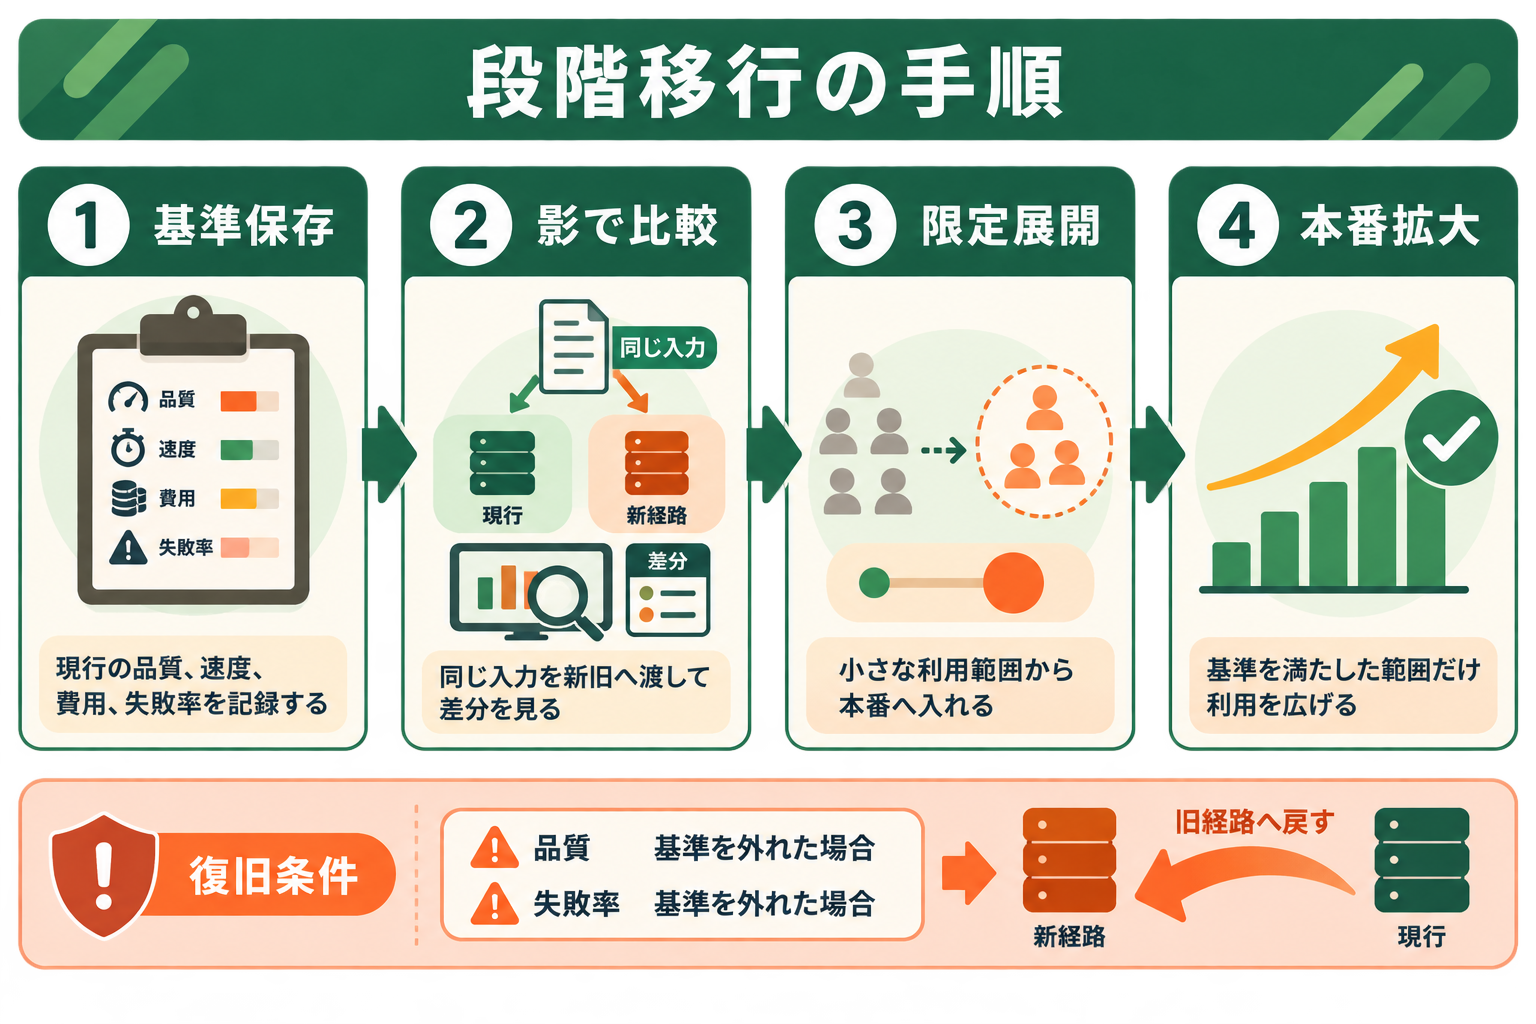
本番を一度に切り替えず、観測できる単位で段階展開します。
関連記事:AIエージェントの法人導入ガイド|PoCから本番運用までの5ステップと3つの落とし穴
1|現在値と判定基準を保存する
現行モデルで代表テストを実行し、品質、レイテンシ、トークン、ツール成功率、人の修正量を保存します。
2|シャドー実行で差分を見る
本番入力を複製できる場合は、Astraの結果を利用者へ返さないシャドー実行で比較します。個人情報や機密情報を複製できない場合は、匿名化した代表データセットを使います。ツールはread-onlyのモックへ置き換え、外部書き込みを起こさないようにします。
3|限定トラフィックへ展開する
判定基準を満たしたら、対象業務、利用者、比率で範囲を限定します。一時的なレート制限は自動再試行、schema不一致や権限エラーは停止して確認、と分けます。
4|ロールバック条件を数値で決める
次のような条件を切り替え前に決めます。
- 必須schemaの不一致率が基準を超える
- ツール失敗率または重複実行が増える
- p95レイテンシが許容値を超える
- 1タスクあたりの原価が予算を超える
- 禁止操作または承認漏れが1件でも起きる
ロールバック時はモデルIDだけでなく、Responses固有の状態と旧実装の入力形式を戻せるようにします。変換層、feature flag、評価ログを切り離しておくと、復旧後も失敗原因を調べられます。
GPT-6 AstraのAPI移行で陥りがちな3つの落とし穴
高性能なモデルへ移しても、移行単位、権限、検証が曖昧なら本番運用は安定しません。最初は一つの業務フローを選び、戻せる状態で試します。
落とし穴1|モデルIDだけを差し替える
非対応パラメータ、Responsesのoutput item、ツール結果の返し方を確認せずにモデルIDだけを変えると、疎通後の実処理で失敗します。リクエスト変換、レスポンス変換、ツール実行を別々にテストし、最後に結合します。
落とし穴2|最大コンテキストを毎回使う
大量の履歴と資料を毎回送ると、長文料金倍率、待ち時間、関連性の低下が同時に起こり得ます。検索で必要箇所を絞り、安定したprefixはキャッシュし、古い履歴は要約・明示的compactionの対象にします。
落とし穴3|本番の書き込みツールから試す
ツールschemaが正しくても、認可、冪等性、承認、監査ログが不足していれば事故を防げません。まずread-onlyまたはモックで検証し、次に取消可能な操作、最後に外部送信や削除など影響の大きい操作へ広げます。
まず1業務をスモールスタートで自動化する
移行対象は、入力、成果物、許可するツール、成功条件を明確にできる一つの業務から選びます。回帰テストとロールバック条件を先に置き、限定トラフィックで安定してから隣の工程へ広げます。API設計から運用まで伴走が必要な場合は、GiftX AIエージェント構築支援でご相談いただけます。
GPT-6 Astra APIに関するよくある質問
GPT-6 AstraのモデルIDは何ですか
モデルIDはgpt-6-astraです。Responses APIのmodelへ指定します。固定した挙動が必要な場合は、公式モデルページで利用可能なsnapshotやaliasの最新情報も確認してください。
Chat Completions APIからも呼び出せますか
テキスト生成にはChat Completions APIも利用できます。ただし、GPT-6 Astraでツール呼び出しを使う場合はResponses APIが必要です。今後Function Callingや長時間タスクを実装するなら、Responses APIへの移行を優先します。
Mid-turn steeringで開始済みツールを止められますか
自動では止まりません。追加指示は後続の作業へ反映されますが、既出力の書き換えや実行済み操作の取消、開始済みツールのキャンセルは行いません。アプリ側でキャンセル可能なジョブ設計と承認境界を用意します。
移行後に問題が出たら旧モデルへ戻せますか
戻せますが、モデルIDの切り替えだけでなく、入力・出力の変換と会話状態も旧経路へ戻せる設計が必要です。feature flag、代表テスト、ロールバック条件、旧モデル用の変換層を移行期間中は残します。
まとめ
GPT-6 Astra APIを使うときは、gpt-6-astraをResponses APIへ指定し、最小リクエスト、output item、Function Callingの順に実装します。長時間処理ではcall_idとジョブ状態を保存し、async tool calling、Mid-turn steering、configuration_updateを用途に応じて追加します。
既存実装からの移行では、非対応パラメータ、キャッシュ、長文料金、ストリーミング、ツール権限を回帰テストへ含めます。シャドー実行と限定トラフィックで比較し、旧モデルへ戻す条件を先に決めてから本番比率を上げてください。
GPT-6 Astra APIを使った業務エージェントの設計をご検討の方へ
APIを営業支援などの本番業務へ組み込むには、モデル選定だけでなく、データ取得、ツール権限、承認、状態管理、監視、原価、ロールバックを一つの運用として設計する必要があります。
GiftXでは、対象業務の切り出しからResponses APIを使ったAIエージェントの設計・実装・運用までを伴走しています。自社の既存システムへ安全に接続したい方は、GiftX AIエージェント構築支援をご覧ください。
▶ GiftX AIエージェント構築支援の詳細・お問い合わせはこちら